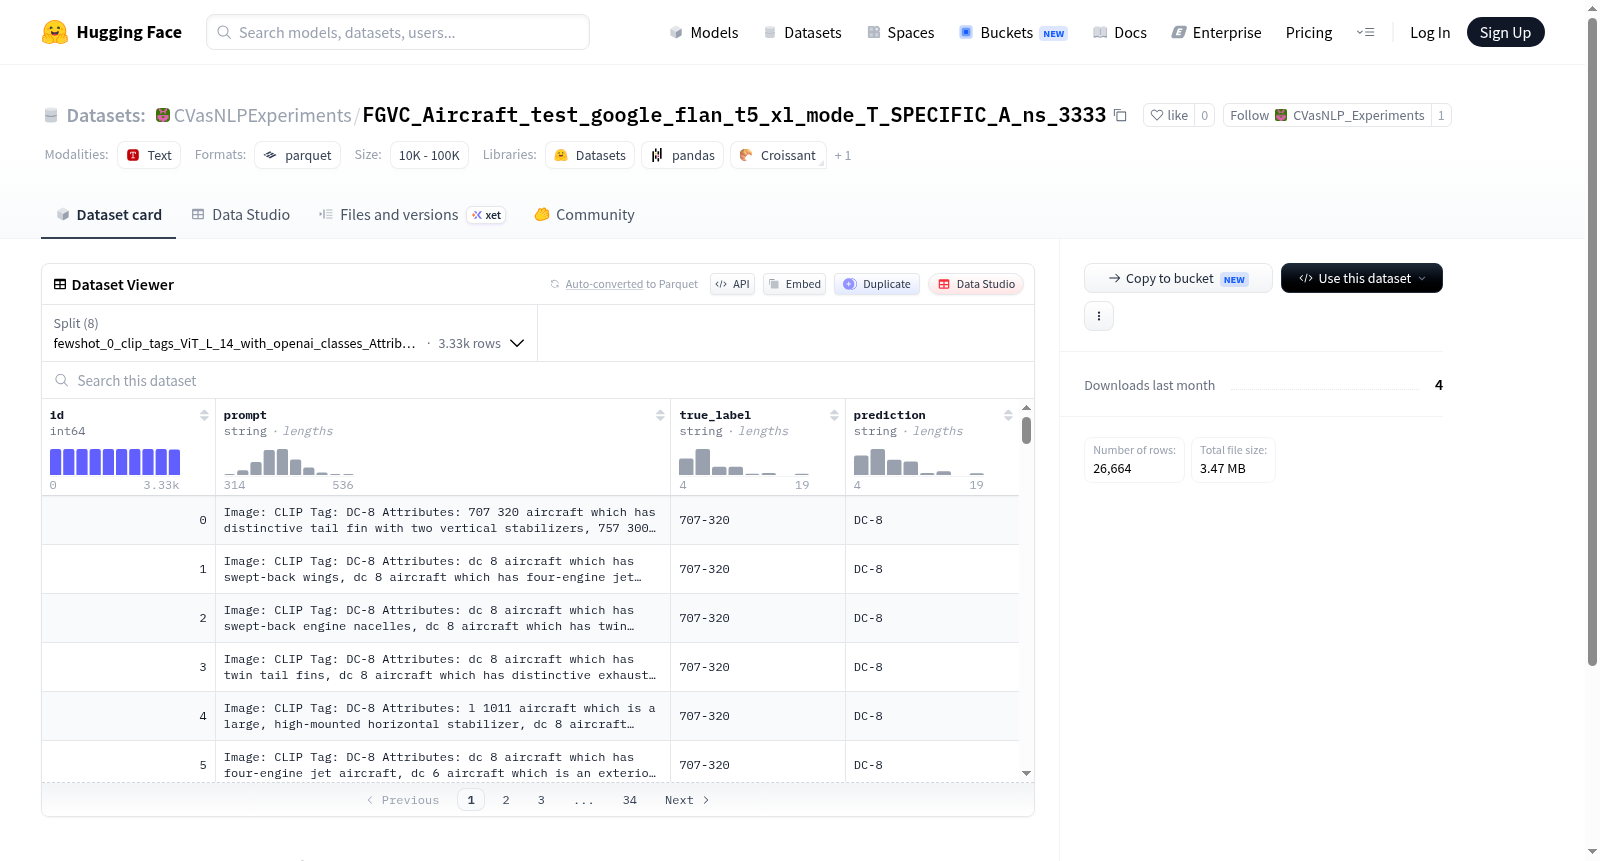
CVasNLPExperiments/FGVC_Aircraft_test_google_flan_t5_xl_mode_T_SPECIFIC_A_ns_3333
收藏资源简介:
--- dataset_info: features: - name: id dtype: int64 - name: prompt dtype: string - name: true_label dtype: string - name: prediction dtype: string splits: - name: fewshot_0_clip_tags_ViT_L_14_with_openai_classes_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices num_bytes: 1486108 num_examples: 3333 - name: fewshot_1_clip_tags_ViT_L_14_with_openai_classes_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices num_bytes: 2879731 num_examples: 3333 - name: fewshot_0_clip_tags_ViT_L_14_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices num_bytes: 1492678 num_examples: 3333 - name: fewshot_1_clip_tags_ViT_L_14_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices num_bytes: 2892999 num_examples: 3333 - name: fewshot_3_clip_tags_ViT_L_14_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices num_bytes: 5701653 num_examples: 3333 - name: fewshot_0__Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_clip_tags_LAION_ViT_H_14_2B_simple_specific_rices num_bytes: 1428942 num_examples: 3333 - name: fewshot_1__Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_clip_tags_LAION_ViT_H_14_2B_simple_specific_rices num_bytes: 2771870 num_examples: 3333 - name: fewshot_3__Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_clip_tags_LAION_ViT_H_14_2B_simple_specific_rices num_bytes: 5457391 num_examples: 3333 download_size: 3463840 dataset_size: 24111372 --- # Dataset Card for "FGVC_Aircraft_test_google_flan_t5_xl_mode_T_SPECIFIC_A_ns_3333" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集信息: 特征字段: - 字段名:id,数据类型:64位整型 - 字段名:prompt(提示词),数据类型:字符串型 - 字段名:true_label(真实标签),数据类型:字符串型 - 字段名:prediction(模型预测结果),数据类型:字符串型 数据集拆分: - 拆分名称:少样本0_CLIP标签_ViT_L_14_带OpenAI类别_ViT_L_14属性_OpenAI Davinci 003文本模型_完整CLIP标签_ViT_L_14_简单特定水稻类,数据字节数:1486108,样本数量:3333 - 拆分名称:少样本1_CLIP标签_ViT_L_14_带OpenAI类别_ViT_L_14属性_OpenAI Davinci 003文本模型_完整CLIP标签_ViT_L_14_简单特定水稻类,数据字节数:2879731,样本数量:3333 - 拆分名称:少样本0_CLIP标签_ViT_L_14_ViT_L_14属性_OpenAI Davinci 003文本模型_完整CLIP标签_ViT_L_14_简单特定水稻类,数据字节数:1492678,样本数量:3333 - 拆分名称:少样本1_CLIP标签_ViT_L_14_ViT_L_14属性_OpenAI Davinci 003文本模型_完整CLIP标签_ViT_L_14_简单特定水稻类,数据字节数:2892999,样本数量:3333 - 拆分名称:少样本3_CLIP标签_ViT_L_14_ViT_L_14属性_OpenAI Davinci 003文本模型_完整CLIP标签_ViT_L_14_简单特定水稻类,数据字节数:5701653,样本数量:3333 - 拆分名称:少样本0_LAION_ViT_H_14_2B属性描述符_OpenAI Davinci 003文本模型_完整CLIP标签_LAION_ViT_H_14_2B简单特定水稻类,数据字节数:1428942,样本数量:3333 - 拆分名称:少样本1_LAION_ViT_H_14_2B属性描述符_OpenAI Davinci 003文本模型_完整CLIP标签_LAION_ViT_H_14_2B简单特定水稻类,数据字节数:2771870,样本数量:3333 - 拆分名称:少样本3_LAION_ViT_H_14_2B属性描述符_OpenAI Davinci 003文本模型_完整CLIP标签_LAION_ViT_H_14_2B简单特定水稻类,数据字节数:5457391,样本数量:3333 下载总大小:3463840 字节 数据集总大小:24111372 字节 # 数据集卡片:"FGVC_Aircraft_test_google_flan_t5_xl_mode_T_SPECIFIC_A_ns_3333" [需要补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集概述
数据集特征
- id: 整数类型 (int64)
- prompt: 字符串类型 (string)
- true_label: 字符串类型 (string)
- prediction: 字符串类型 (string)
数据集分割
- fewshot_0_clip_tags_ViT_L_14_with_openai_classes_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices
- 大小: 1486108 字节
- 示例数: 3333
- fewshot_1_clip_tags_ViT_L_14_with_openai_classes_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices
- 大小: 2879731 字节
- 示例数: 3333
- fewshot_0_clip_tags_ViT_L_14_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices
- 大小: 1492678 字节
- 示例数: 3333
- fewshot_1_clip_tags_ViT_L_14_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices
- 大小: 2892999 字节
- 示例数: 3333
- fewshot_3_clip_tags_ViT_L_14_Attributes_ViT_L_14_text_davinci_003_full_clip_tags_ViT_L_14_simple_specific_rices
- 大小: 5701653 字节
- 示例数: 3333
- fewshot_0__Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_clip_tags_LAION_ViT_H_14_2B_simple_specific_rices
- 大小: 1428942 字节
- 示例数: 3333
- fewshot_1__Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_clip_tags_LAION_ViT_H_14_2B_simple_specific_rices
- 大小: 2771870 字节
- 示例数: 3333
- fewshot_3__Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_clip_tags_LAION_ViT_H_14_2B_simple_specific_rices
- 大小: 5457391 字节
- 示例数: 3333
数据集大小
- 下载大小: 3463840 字节
- 数据集总大小: 24111372 字节