
遇见数据集

IAAR-Shanghai/LongEvoRoleBench

收藏
Hugging Face2026-07-13 更新2026-07-22 收录
官方服务:

资源简介:

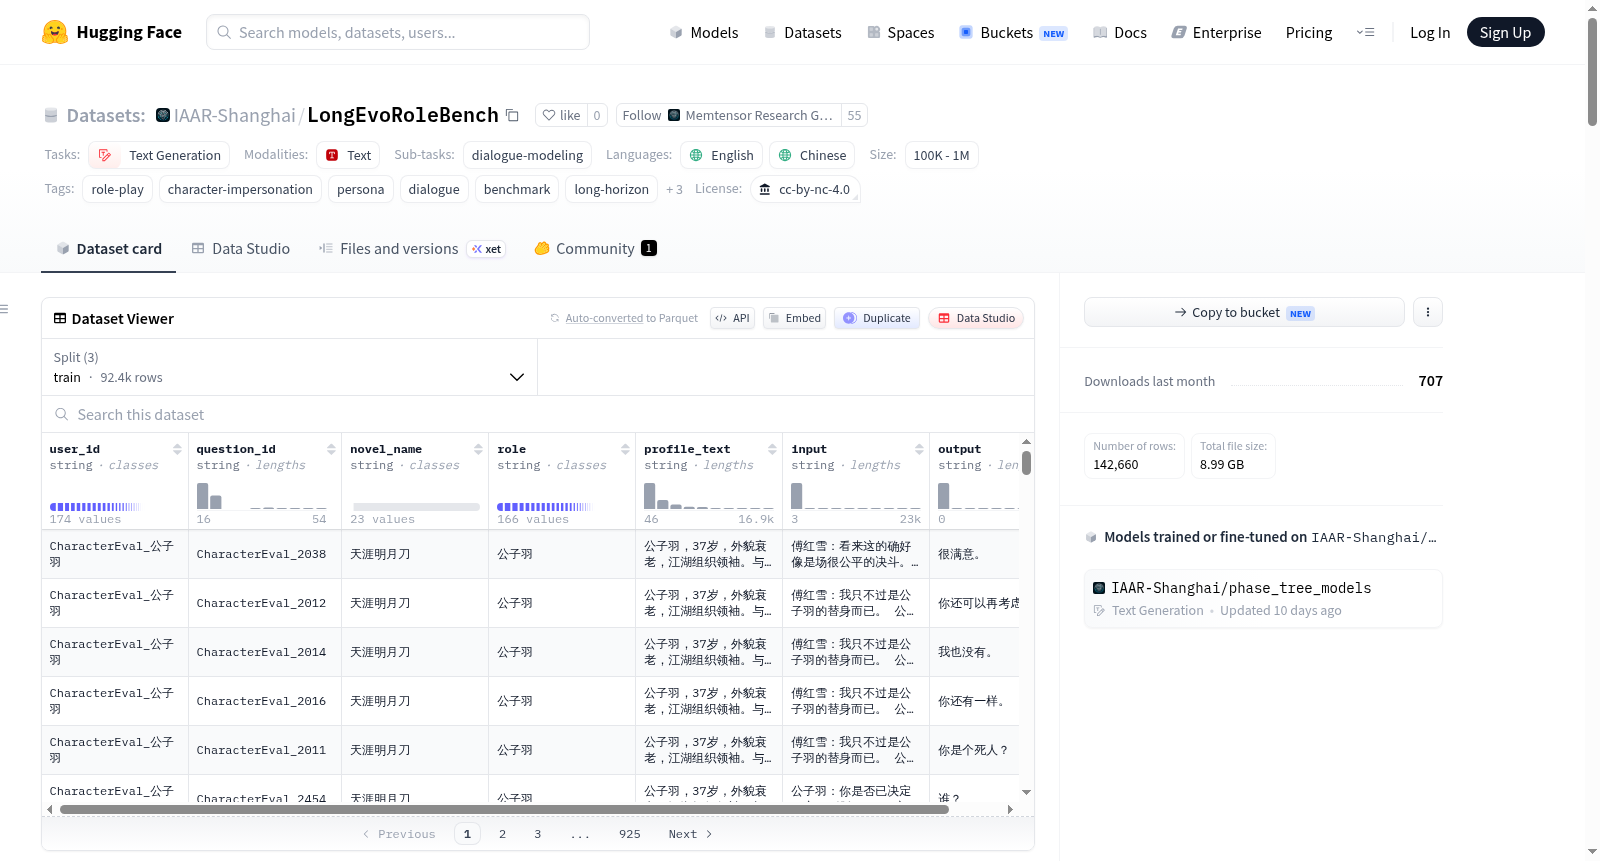
LongEvoRoleBench 是一个用于长视野、进化感知角色扮演的统一基准。它标准化了8个现有角色对话语料库,采用共同的下一个话语协议:其中4个长对话语料库测试跨剧集角色状态演化,4个短对话语料库在同一评估格式下提供场景内状态跟踪检查。数据集引入了PHASE-Tree(心理学基础层次属性结构化演化树)作为角色状态表示,并提供原始数据和已处理的分割数据。已处理数据包括多种配置文件表示方法(从M1到M6),其中M6对应完整的PHASE-Tree条件。数据集支持训练和评估,包含训练、随机测试和OOD测试分割,并针对短长期数据集采用不同的OOD策略(短期为未见角色,长期为未见时间周期)。

LongEvoRoleBench is a unified benchmark for long-horizon, evolution-aware role-playing. It standardizes 8 existing character-dialogue corpora into a common next-utterance protocol: 4 long-dialogue corpora test cross-episode character-state evolution, and 4 short-dialogue corpora provide within-scene state-tracking checks under the same evaluation format. The dataset introduces the PHASE-Tree (Psychology-grounded Hierarchical Attribute-Structured Evolving Tree) as the character-state representation and provides both raw source corpora and fully processed evaluation splits. The processed data includes multiple profile representation methods (M1 to M6), with M6 corresponding to the full PHASE-Tree conditioning. It supports training and evaluation with train, random test, and OOD test splits, using different OOD strategies for short-term (unseen characters) and long-term (unseen time periods) datasets.
提供机构:
IAAR-Shanghai
搜集汇总
数据集介绍
IAAR-Shanghai/LongEvoRoleBench 数据集图片
构建方式
LongEvoRoleBench基于8个现有角色对话语料库构建,通过统一的下一轮对话协议标准化处理。其中4个长对话语料库(Friends、HPD、StarTrek_TNG、TheOffice)用于评估跨篇章角色状态演化,4个短对话语料库(RAIDEN、CharacterEval、SimsConv、ChatHaruhi)用于场景内状态追踪检查。所有数据经过PHASE-Tree流水线处理,该流水线以心理学启发的层级化属性状态演化树为核心,生成从M1(仅对话上下文)到M6(完整PHASE-Tree)共6种配置变体,并划分训练集、随机测试集和分布外测试集。
使用方法
推荐通过PHASE-Tree代码库使用该数据集,在项目根目录执行`hf download IAAR-Shanghai/LongEvoRoleBench --repo-type=dataset --local-dir LongEvoRoleBench`即可获得完整目录结构。用户可直接加载processed目录下各数据集的JSON文件,每个样本包含角色标识符、对话上下文和标准回复字段。对于仅需查看M6主配置的用户,也可通过`datasets.load_dataset("IAAR-Shanghai/LongEvoRoleBench")`快速加载,但完整的训练评估流程需依赖本地文件布局。
背景与挑战
背景概述
LongEvoRoleBench是由上海人工智能实验室等机构于近期推出的统一基准数据集,专门用于评估长程、具备角色状态演变能力的对话系统。该数据集的创建旨在解决当前角色扮演对话中角色状态无法跨场景动态演化的问题,通过整合来自RAIDEN、CharacterEval等8个现有角色对话语料库,并引入心理学启发的层级属性结构演化树(PHASE-Tree)作为角色状态表征框架,为模型在长程对话中的角色一致性追踪和状态演变建模提供了标准化的评估协议。LongEvoRoleBench的发布填补了该领域缺乏统一、多场景演化评估基准的空白,有望推动角色扮演对话系统从静态属性匹配向动态状态建模的方向发展,对提升对话智能体的长期交互真实性和人格连贯性具有重要意义。
当前挑战
LongEvoRoleBench所解决的领域核心挑战在于角色扮演对话系统难以在长程交互中维护角色状态的一致性和动态演化,现有模型多局限于单场景或短时的属性匹配,无法捕捉角色在跨情节对话中的人格特质演变。该数据集构建过程中的挑战包括:首先,整合来自不同源、不同语言(中英文)和不同剧情长度的8个语料库,需统一数据格式并设计跨场景的标准化评估协议;其次,为支持角色状态演化,需从原始对话中提取并构建层级化、可演变的属性树结构(PHASE-Tree),这对长程语料(如《老友记》《星际迷航》)中的时间序列和角色变化建模提出了精细的人力和算法要求;最后,合理划分分布内和分布外测试集(如短程数据集采用未见角色、长程数据集采用未见时间片)以确保评估的公平性和挑战性,也是一项复杂的设计任务。
常用场景
经典使用场景
LongEvoRoleBench作为一个面向长时序、角色状态演化的统一基准评测数据集,其核心应用场景在于评估与提升对话模型对角色人格动态演化的理解与生成能力。该数据集将八类已有的角色对话语料标准化为统一的下一轮对话预测协议,涵盖跨剧集的长对话演进与单场景内的短期状态追踪,为实现更具拟人化、持续一致性的角色扮演系统提供了可靠的评估平台。
解决学术问题
该数据集攻克了长期角色扮演中角色状态漂移与人格连贯性难以追踪的核心学术难题。通过引入心理层次化属性结构演化树(PHASE-Tree)方法,解决了跨时间段的角色状态表征与演化建模问题,并系统区分了短期静态与长期动态两种设定下的评测指标,填补了现有基准在角色属性长程演化评估领域的空白,推动了角色驱动对话系统从静态模板向动态人格建模的演进。
实际应用
在实际应用中,LongEvoRoleBench可服务于构建具备长期记忆与人格稳定性的人机交互系统,例如虚拟社交助手、沉浸式叙事游戏中的智能NPC养成、影视或文学IP驱动的角色数字分身等。借助该基准评估的模型能在多轮跨集对话中保持角色性格变化的有序性和一致性,从而显著提升用户在长期交互过程中的沉浸感与情感共鸣。
数据集最近研究
最新研究方向
LongEvoRoleBench聚焦于长程、演化感知的角色扮演对话评估,其核心在于通过心理学启发的PHASE-Tree分层属性演化树建模角色状态的动态变迁,填补了现有基准在跨剧集角色一致性及情节内状态追踪两方面的空白。该基准统一了8个中英文角色对话语料库,涵盖Friends、StarTrek等长对话集与ChatHaruhi等短交互场景,并引入随机测试与分布外(OOD)测试策略以严格检验模型的泛化能力。此项工作与当前大语言模型在长上下文理解、拟人化对话系统及持续人格建模等前沿热点紧密相关,为评估模型在复杂叙事中保持角色特质长期演化的能力提供了标准化实验平台,推动人工智能从单轮回复向具有时间深度的个性化交互演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

