
遇见数据集

srpone/zooclaw-fashion-eval

收藏
Hugging Face2026-06-30 更新2026-07-22 收录
官方服务:

资源简介:

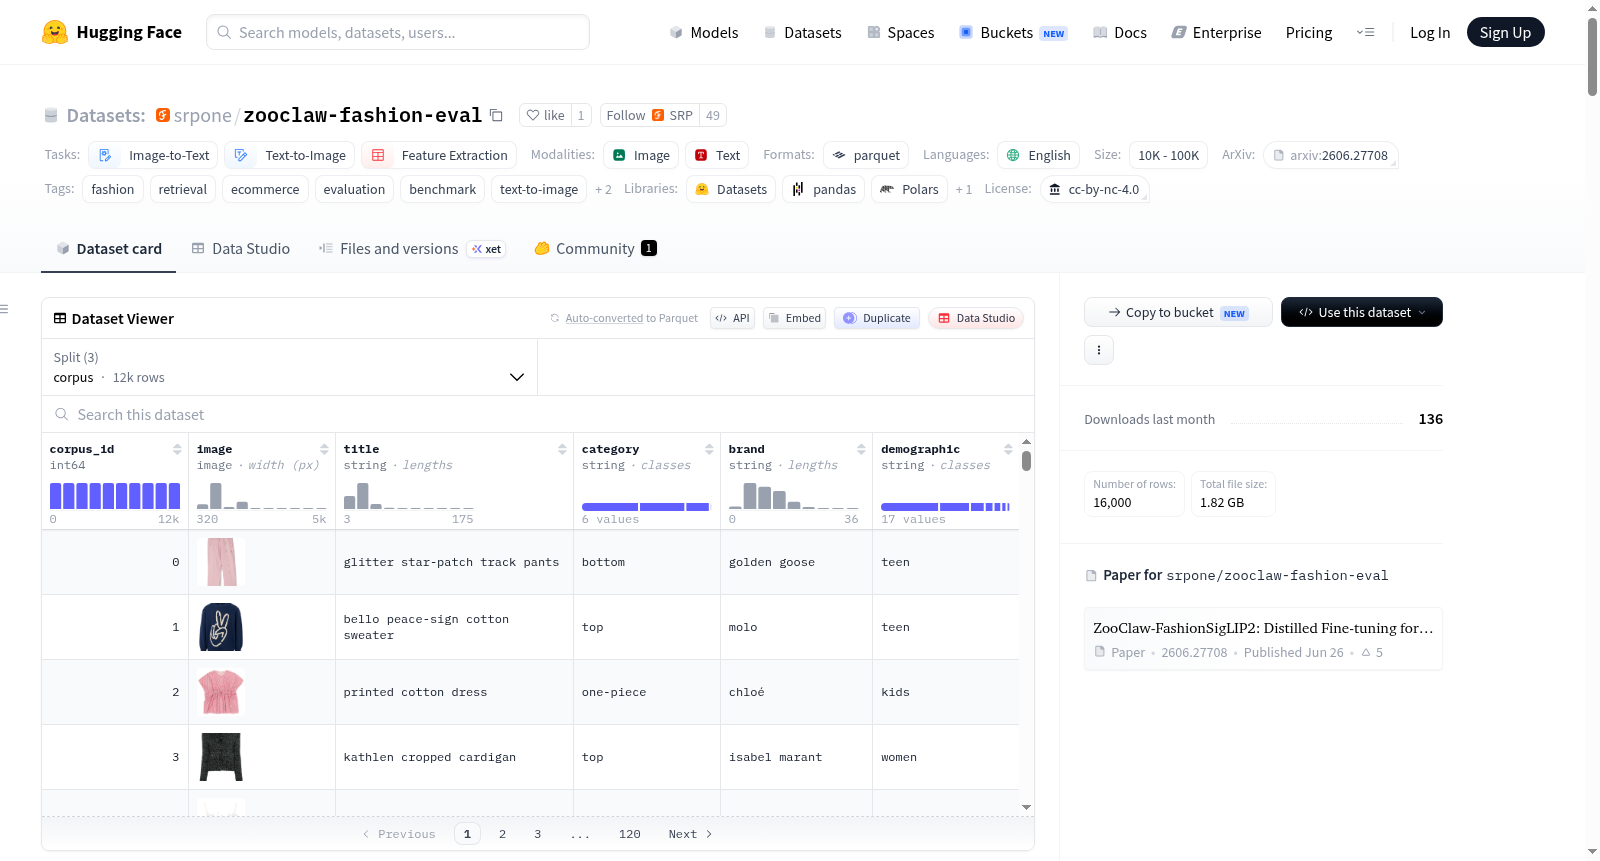
ZooClaw-Fashion是一个用于时尚图文检索的评估基准,旨在严格测试跨模态检索模型在真实世界电商时尚产品上的性能。它包含零样本和领域内两种查询划分,支持对模型泛化能力的细粒度分析。数据来源于zoodata.ai提供的多品牌时尚目录,该平台是ZooClaw平台上智能体使用的数据代理栈。数据集包含2000个查询(1000个零样本查询和1000个领域内查询)和12000个产品,覆盖2086个独特品牌,支持文本到图像、图像到文本和文本到文本三种检索任务。数据按类别(如上衣、下装、包袋等)和人口统计属性(如女性、男性、儿童等)分布,图像格式包括WEBP、JPG和PNG。数据集结构遵循BEIR风格,包含独立的查询、语料库和真实标签文件,用于评估时尚检索模型的性能。

ZooClaw-Fashion is an evaluation benchmark for fashion image-text retrieval, designed to rigorously test cross-modal retrieval models on real-world e-commerce fashion products. It features both zero-shot and in-domain query splits, enabling fine-grained analysis of model generalization. Products are sourced from the multi-brand fashion catalog provided by zoodata.ai — the data-agent stack used by agents on the ZooClaw platform. The dataset includes 2,000 queries (1,000 zero-shot and 1,000 in-domain) and 12,000 products, covering 2,086 unique brands, and supports text-to-image, image-to-text, and text-to-text retrieval tasks. Data is distributed across categories (e.g., top, bottom, bag) and demographics (e.g., women, men, kids), with image formats including WEBP, JPG, and PNG. The dataset follows a BEIR-style structure with separate files for queries, corpus, and ground truth, facilitating evaluation of fashion retrieval models.
提供机构:
srpone
搜集汇总
数据集介绍
srpone/zooclaw-fashion-eval 数据集图片
构建方式
该数据集构建于真实电商场景,产品源自多品牌时尚目录zoodata.ai,由ZooClaw平台上的智能体所使用的数据代理栈提供。数据集采用BEIR风格的目录结构,分别针对文本到图像、图像到文本及文本到文本三类检索任务进行组织,包含独立的查询文件、语料库文件及基于SKU的标注文件。查询集由2000条构成,均分为零样本与域内两类,分别用于测试模型的泛化能力与领域内检索质量。语料库涵盖12,000件商品,覆盖上衣、下装、包袋等六大品类及多元人口统计维度,总计来自2,086个品牌。
特点
该数据集在构建中凸显两大特性:其一为任务多样性,不仅支持标准的短文本与图像检索,还引入由大语言模型生成的长文本查询,提升对自然语言细致描述的理解评估能力;其二为评估细粒度,通过零样本与域内查询的精心划分,可深入剖析跨模态模型在真实电商场景中的泛化表现。同时,产品信息包含分类、品牌及人口统计标签,为多维度性能分析提供了坚实的结构支撑。
使用方法
用户可通过HuggingFace的snapshot_download方法便捷下载数据集至本地,随后依据任务子目录加载对应的queries.json、corpus.json及ground_truth.json文件进行解析。数据集支持Python环境下的快速加载与交互,示例代码展示了如何获取查询、语料及真实匹配结果。此外,建议配合LookBench评估框架进行标准化评测,该框架提供Recall@K及MRR等核心指标的计算接口,便于复现基准结果并开展模型对比研究。
背景与挑战
背景概述
在电子商务蓬勃发展且视觉搜索技术日益普及的当下,跨模态时尚检索成为连接用户文本意图与商品图像的关键技术。ZooClaw-Fashion评测数据集由SerendipityOne Inc.的研究团队于2026年创建,旨在为时尚图片-文本检索任务提供严谨的标准化评估基准。该数据集依托zoodata.ai平台提供的多品牌时尚商品目录,精心构建了包含2000条查询与12000个商品条目的评测集,并创新性地划分出零样本与域内查询子集,以深入剖析模型的泛化能力。其发布不仅填补了面向真实电商场景、兼顾细粒度属性与品牌多样性的评测基准空白,更通过配套的最先进模型ZooClaw-FashionSigLIP2,推动了该领域研究的量化比较与进步。
当前挑战
该数据集所应对的核心挑战在于,现有的跨模态检索基准难以真实反映模型在复杂电商环境中的表现,尤其是在面对训练阶段未见的新商品(零样本场景)时,模型的泛化能力与检索鲁棒性显著不足。具体而言,数据集的构建面临着多方面的困难:首先,需要从海量、多SKU的真实商品库中精确筛选并标注出细粒度的图文对应关系,确保跨模态语义的严格对齐;其次,要在保持域内查询质量的同时,设计出能有效评估模型零样本泛化能力的查询集,这要求对商品分布与检索难度有深刻洞察;最后,数据集还需应对多品牌、多品类带来的长尾分布与风格多样性挑战,以保证评测结果的全面性与代表性。
常用场景
经典使用场景
ZooClaw-Fashion-Eval数据集的核心应用场景在于评估和基准测试跨模态时尚图像-文本检索模型的性能。该数据集通过精心设计的零样本(zero-shot)与域内(in-domain)查询划分,为研究者提供了衡量模型泛化能力与领域内检索精度的双重维度。其典型任务涵盖文本到图像(text-to-image)、图像到文本(image-to-text)以及文本到文本(text-to-text)三大检索范式,支持从简短产品名称到由大语言模型生成的长篇自然语言描述等多层次查询输入。因此,该数据集成为对比不同多模态模型在真实电商场景下检索效能的权威标杆。
实际应用
在实际应用中,ZooClaw-Fashion-Eval数据集直接服务于电商平台的智能检索系统,赋能用户通过自然语言或图片精准搜索时尚单品。例如,消费者可以输入‘带有金色闪粉星星补丁的慢跑裤’这种细节丰富的描述,系统即可从海量商品库中召回匹配产品;同时,图像到文本检索支持后台对商品标签的自动校验与补全。此外,该数据集为基于多模态检索的推荐系统、虚拟试衣间以及个性化穿搭助手等商业产品提供了坚实的性能验证基础,显著提升了线上购物的便捷性与用户体验。
衍生相关工作
基于该数据集,研究工作衍生出多个前沿成果,最核心的当属其相伴而生的ZooClaw-FashionSigLIP2模型。该模型通过蒸馏微调(Distilled Fine-tuning)在跨基准泛化上表现卓越,并在Fashion200k和H&M等外部数据集上验证了其鲁棒性。此外,社区围绕该数据集构建了LookBench整体式时尚检索基准框架,为统一的模型评估提供了标准化流水线。这些工作共同推动了从特征提取到端到端检索的范式演进,并启发了后续关于多模态对齐、难负样本挖掘以及零样本学习在垂直电商领域应用的系列研究。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

