
遇见数据集

amalia-llm/MATH-Vision-PT

收藏
Hugging Face2026-07-07 更新2026-07-22 收录
官方服务:

资源简介:

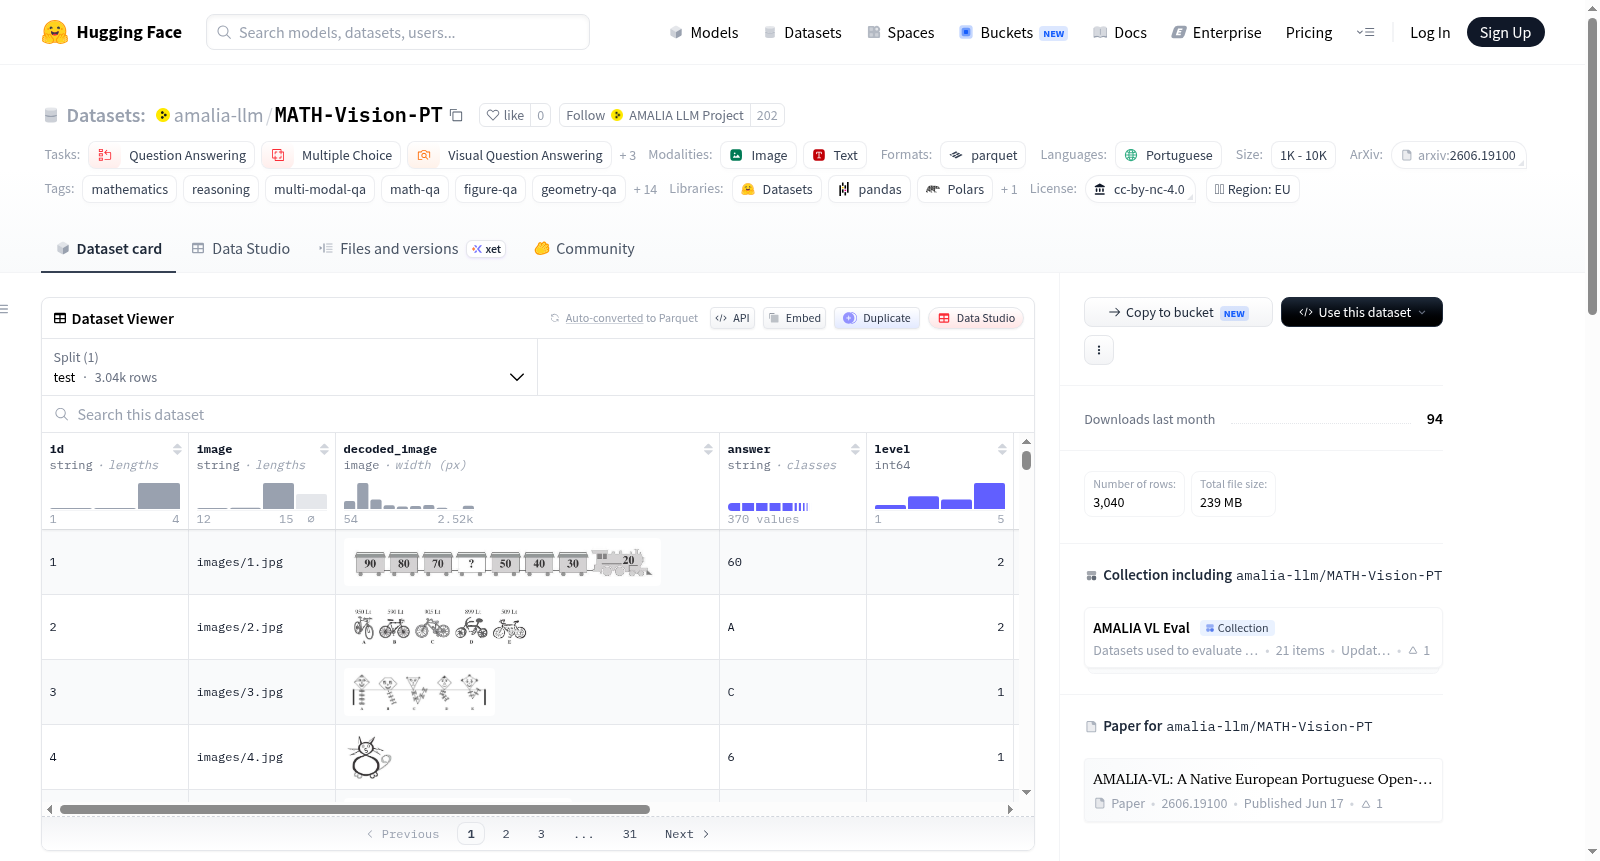
MATH-Vision-PT是MATH-Vision数据集的欧洲葡萄牙语(pt-PT)机器翻译版本,由gemini-3.1-pro翻译工具从原始英文测试集转换而来。该数据集是一个多模态基准,专注于在视觉上下文中呈现的竞赛级数学问题,涵盖数学、推理、几何图表、科学图表、表格、函数图等多种主题。它包括3040个测试样本,每个样本包含图像、问题、选项、答案、解决方案等特征,适用于问答、多项选择、视觉问答、文本生成、图像到文本等多种任务。数据集作为AMALIA项目的一部分,用于评估大型视觉语言模型在欧洲葡萄牙语上的性能。注意:数据集是机器翻译的,可能包含翻译错误或伪影,且翻译内容采用cc-by-nc-4.0许可证,非商业使用需署名,而图像和未翻译列则保留原始许可证。

MATH-Vision-PT is a European Portuguese (pt-PT) machine translation of the MATH-Vision benchmark, which consists of competition-level mathematics problems presented in visual contexts. Translated from the original English test split using gemini-3.1-pro, this dataset includes 3040 test examples with features such as images, questions, options, answers, and solutions. It covers diverse topics like mathematics, reasoning, geometry diagrams, scientific figures, tables, and function plots, and supports tasks including question-answering, multiple-choice, visual-question-answering, text-generation, and image-to-text. As part of the AMALIA project, it is used for evaluating large vision-language models on European Portuguese. Note: The dataset is machine-translated and may contain errors or artifacts; the translated content is licensed under cc-by-nc-4.0 for non-commercial use with attribution, while images and untranslated columns retain the original license.
提供机构:
amalia-llm
搜集汇总
数据集介绍
amalia-llm/MATH-Vision-PT 数据集图片
构建方式
MATH-Vision-PT数据集源自国际知名的MATH-Vision基准测试,后者收录了竞赛级别的数学问题,且问题呈现常融合图表、几何图形等视觉上下文。在构建过程中,研究团队采用gemini-3.1-pro模型,将原始英文测试集(test split)的题目描述、选项、答案及解答等文本内容,精确翻译为欧洲葡萄牙语(pt-PT)。翻译工作严格保留图像等非文本字段的原貌,确保视觉信息不受语言转换的影响。最终形成一份包含3040个样本,涵盖数学、科学等多学科领域,且兼顾视觉与语言双模态的评估数据集。
特点
该数据集的核心特色在于其双语与跨模态的独特设计。它不仅继承了MATH-Vision原版中丰富的视觉元素,包括几何图形、函数图、表格和科学图表等,还通过高质量机器翻译赋予了欧洲葡萄牙语的语言版本。这种设计使得研究者能够在非英语语境下,精准评估视觉-语言模型解决复杂数学推理问题的能力。数据集采用多项选择和问答格式,题目难度按等级划分,并提供了详尽的解答过程,为分析模型的逻辑推理与视觉理解水平提供了坚实依据。
使用方法
MATH-Vision-PT可直接作为基准测试套件,用于评估欧洲葡萄牙语环境下的大规模视觉-语言模型的数学推理性能。用户通过HuggingFace Datasets库加载数据,使用包含图像路径、解码图像、多语言选项及标准答案等字段。在评估时,可结合amalia-vl-eval工具链,将模型生成的回答与标准解答进行比对,从而计算准确率等指标。由于数据集采用双重许可(翻译内容为CC-BY-NC 4.0,图像等保持原许可),使用时需同时遵守两种协议,特别注意非商业性使用和原始数据集的归属要求。
背景与挑战
背景概述
MATH-Vision-PT数据集由葡萄牙AMALIA项目团队于2026年创建,依托Gemini-3.1-pro大模型,将原版MATH-Vision基准测试中的竞赛级数学问题及视觉情境内容,从英文精准迁移至欧洲葡萄牙语。该数据集聚焦于多模态数学推理的跨语言评估,旨在为葡语社区提供首个系统性的视觉-语言数学基准。其发布推动了低资源语言在多模态推理领域的研究进程,并为评估大型视觉语言模型在非英语环境下的泛化能力奠定了关键基石。
当前挑战
该数据集所解决的领域挑战在于,现有数学视觉问答基准多集中于英语,缺乏对欧洲葡萄牙语等低资源语言的支持,限制了多模态模型在非英语场景下的公平评估与迁移学习。构建过程中,机器翻译产生的语义歧义与术语错误构成核心难题,尤其涉及几何图形、函数图像等视觉元素与文本对应关系时,翻译误差易导致推理链条断裂。此外,保持数学竞赛题目的严谨性与视觉上下文一致性,需要在翻译后人工校验,显著增加了数据质量控制的工作负荷。
常用场景
经典使用场景
MATH-Vision-PT数据集的核心应用在于评估与强化多模态大语言模型在数学推理与视觉理解融合任务上的表现。该数据集荟萃了竞赛级别的数学问题,并将题目以图像、图表、几何图形、函数曲线及科学图示等视觉形式呈现,同时提供欧洲葡萄牙语(pt-PT)的翻译文本。研究者可借助此数据集,系统性地检验模型在解读复杂视觉信息并联合语义推理方面的综合能力,尤其适合构建和测试跨模态的数学问答系统。
解决学术问题
该数据集精准回应了多模态大语言模型在非英语语言环境中数学推理能力评估的匮乏问题。学术实践中,现有基准多集中于英文语境,忽视了语言特异性对模型认知表现的影响。MATH-Vision-PT的推出,使得研究者能够深入探究语言转换带来的语义漂移与推理一致性挑战,为模型在多语言、多模态条件下的鲁棒性评价提供了关键标尺,促进了跨语言数学推理研究的理论深化与框架完善。
衍生相关工作
围绕MATH-Vision-PT,衍生出一系列重要学术工作,最具代表性的是AMALIA-VL项目。该项目以该数据集为评估核心组件,系统性开发并优化了针对欧洲葡萄牙语的开源视觉与语言模型,旨在弥合主流多模态模型在低资源语言上的性能鸿沟。此外,基于该数据集翻译与对齐的范式,研究者相继构建了多语言视觉数学推理基准,推动了跨文化、跨语言的多模态评测体系的建立,启发了诸如葡萄牙语数学图文理解等下游任务的研究热潮。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

