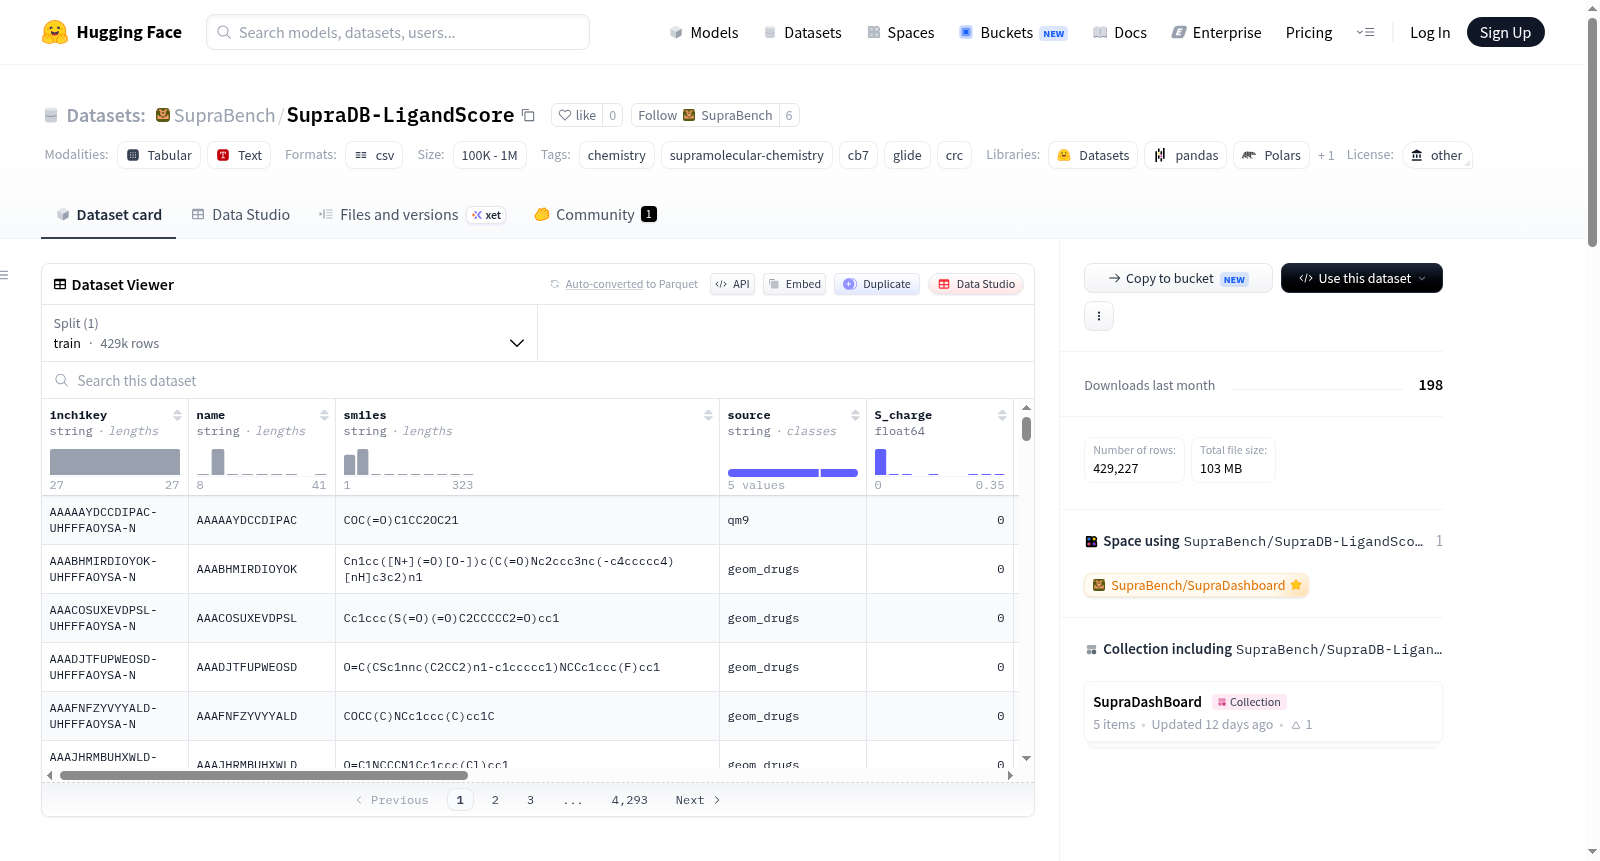
SupraDB-LigandScore
收藏资源简介:
SupraDB-LigandScore是SupraBench特征数据集的一部分,由SupraEngineering计算流水线生成。该数据集专注于超分子化学领域,特别是CB[7](葫芦脲)主客体相互作用研究,旨在为配体评分提供机制性特征。数据内容包含13个预计算的配体相关评分特征,如电荷评分(S_charge)、疏水性评分(S_hydrophobic)、刚性评分(S_rigidity)、去溶剂化评分(S_desolvation)、堆积评分(S_packing)、形状评分(S_shape)、构象多样性评分(S_conformer_diversity)、玻尔兹曼浓度评分(S_boltzmann_concentration)以及惩罚性评分(S_bad)等。所有特征均为无单位的浮点数评分。数据表以inchikey作为主连接键,可与SupraDB-GEOM身份表及其他特征数据集(如SupraDB-PoseFeat和SupraDB-CavityScore)进行连接,以支持完整的超分子分析流水线。数据集规模为429140行,适用于配体筛选、结合亲和力预测、主客体相互作用机制研究等计算化学任务。数据来源于预计算的pickle文件(data/pool_full/features/scores.pkl),使用GLIDE 2025u2等软件工具在CRC计算环境中生成,并通过publish.py脚本发布。
SupraDB-LigandScore is part of the SupraBench feature dataset, generated by the SupraEngineering computational pipeline. This dataset focuses on the field of supramolecular chemistry, particularly the study of CB[7] (cucurbituril) host-guest interactions, aiming to provide mechanistic features for ligand scoring. The data includes 13 precomputed ligand-related scoring features, such as charge score (S_charge), hydrophobic score (S_hydrophobic), rigidity score (S_rigidity), desolvation score (S_desolvation), packing score (S_packing), shape score (S_shape), conformer diversity score (S_conformer_diversity), Boltzmann concentration score (S_boltzmann_concentration), and penalty score (S_bad). All features are unitless floating-point scores. The data table uses inchikey as the primary key for linking with the SupraDB-GEOM identity table and other feature datasets (e.g., SupraDB-PoseFeat and SupraDB-CavityScore) to support a complete supramolecular analysis pipeline. The dataset contains 429,140 rows and is suitable for computational chemistry tasks such as ligand screening, binding affinity prediction, and mechanistic studies of host-guest interactions. The data is sourced from precomputed pickle files (data/pool_full/features/scores.pkl), generated using software tools like GLIDE 2025u2 in a CRC computational environment, and released via the publish.py script.
数据集名称
SupraDB-LigandScore
概述
SupraBench/SupraDB-LigandScore 是一个由 SupraEngineering 计算管道生成的超分子化学特征数据集,专注于 CB[7](葫芦脲[7])宿主-客体系统的配体筛选评分。数据集位于管道中的 Phase 1(全池配体仅评分)和 Phase 2(发布分割)阶段。
数据模式
数据集包含 14 列,其中 inchikey 是唯一连接键,用于与 SupraDB-GEOM(身份表)、SupraDB-CavityScore 和 SupraDB-PoseFeat 等其他特征数据集进行连接。
| 列名 | 数据类型 | 单位 | 含义 |
|---|---|---|---|
inchikey |
string | 无 | 主要 InChIKey,跨 SupraDB-GEOM、LigandScore、CavityScore 和 PoseFeat 共享的连接键 |
name |
string | 无 | 来自 SupraDB-GEOM 身份表的客体名称 |
smiles |
string | 无 | 来自 SupraDB-GEOM 身份表的规范最大片段 SMILES |
source |
string | 无 | 优先去重后来自 SupraDB-GEOM 身份表的优胜来源 |
S_charge |
float32 | 无量纲分数 | 配体电荷分数,结合正式/部分正电荷定位 |
S_hydrophobic |
float32 | 无量纲分数 | 疏水性分数,源自 logP、疏水体积、疏水 SASA 分数和疏水原子分数 |
S_rigidity |
float32 | 无量纲分数 | 配体刚性分数,源自可旋转键计数 |
S_desolvation |
float32 | 无量纲分数 | 配体去溶剂化有利性分数,源自拓扑极性表面积 |
S_packing |
float32 | 无量纲分数 | 配体堆积分数,源自分子体积相对于 CB[7] 空腔体积 |
S_shape |
float32 | 无量纲分数 | 配体形状分数,源自回转半径、非球形性和紧凑性 |
S_conformer_diversity |
float32 | 无量纲分数 | 构象集中分数,有利于低构象多样性 |
S_boltzmann_concentration |
float32 | 无量纲分数 | 玻尔兹曼浓度分数,源自顶部构象系综权重质量 |
S_bad |
float32 | 无量纲分数 | 针对阴离子基团、高极性、柔性和非球形性的惩罚性分数 |
关键信息
- 行数:429,140
- 连接键:
inchikey是唯一连接键,用于关联 SupraDB-GEOM、LigandScore、PoseFeat 和 CavityScore 数据集 - 管道位置:Phase 1 全池配体仅评分(通过 score_nodock);Phase 2 发布分割
- 计算环境:CRC(高性能计算集群)
- 对接/软件环境:GLIDE 2025u2 / aISS 回退机制(如集成规范文档所述)
- 构象坍塌:采用最高玻尔兹曼权重的构象;PoseFeat 保留
np.argmax(boltz)处的真实姿态及其boltzmann_weight和delta_e - 源 Pickle 文件:
data/pool_full/features/scores.pkl
数据来源和生成
- 管道上游:Phase 0 的 SupraDB-GEOM 身份表
- 生成命令:
/users/tma2/workspace/SupraDashboard/.venv/bin/python engineering/src/publish.py --pool-scores data/pool_full/features/scores.pkl --identity data/pool_full/guests.csv --out data/pub_full - 重新生成:通过重新运行
SupraEngineering/src/publish.py,使用相同的管道 pickle 输入和--out目标即可重新生成数据集
许可
license: other(其他许可,具体条款需查阅官方说明)