遇见数据集

LDS-retrain-bank-adamw-wikitext2-N4656-bs8-seed1006

收藏
Hugging Face2026-08-30 更新2026-08-31 收录
官方服务:

资源简介:

该数据集是Retrain bank: WikiText-2 / GPT-2, random halves, seed 1006,包含100个完全重新训练的语言模型,每个模型是在WikiText-2训练集的随机50%(2,328个文档)上微调的GPT-2(gpt2)模型,遵循Bae等人2024年论文《Training Data Attribution via Approximate Unrolled Differentiation》附录B.1中的方案。数据集旨在为训练数据归因方法提供ground truth评估基准。

This dataset is Retrain bank: WikiText-2 / GPT-2, random halves, seed 1006, containing 100 fully retrained language models, each fine-tuned on a random 50% (2,328 documents) of the WikiText-2 training set using GPT-2 (gpt2), following the scheme in Appendix B.1 of the paper Training Data Attribution via Approximate Unrolled Differentiation by Bae et al. 2024. The dataset aims to provide a ground truth evaluation benchmark for training data attribution methods.

提供机构:
EleutherAI
创建时间:
2026-08-30
原始信息汇总

数据集概述

LDS-retrain-bank-adamw-wikitext2-N4656-bs8-seed1006 是一个用于**训练数据归属(Training Data Attribution)**研究的重训练模型库,由 EleutherAI 发布,采用 Apache-2.0 许可证。

核心内容

该数据集包含 100 个完全重新训练的语言模型,每个模型均为 GPT-2(gpt2),分别在 WikiText-2 训练集的**不同随机 50%(2,328 篇文档)**子集上微调而成。完整训练集共 4,656 篇文档,源自 EleutherAI/bergson-wikitext-2-4656-chunks

训练配方遵循 Bae et al. 2024 论文《Training Data Attribution via Approximate Unrolled Differentiation》附录 B.1 的设置。其中 retrained/base 是在完整训练集上使用相同随机种子训练的模型。

文件结构

路径 说明
retrained/base/ 基于完整训练集微调的模型
retrained/subset_*/ 100 个在不同随机半集上训练的模型
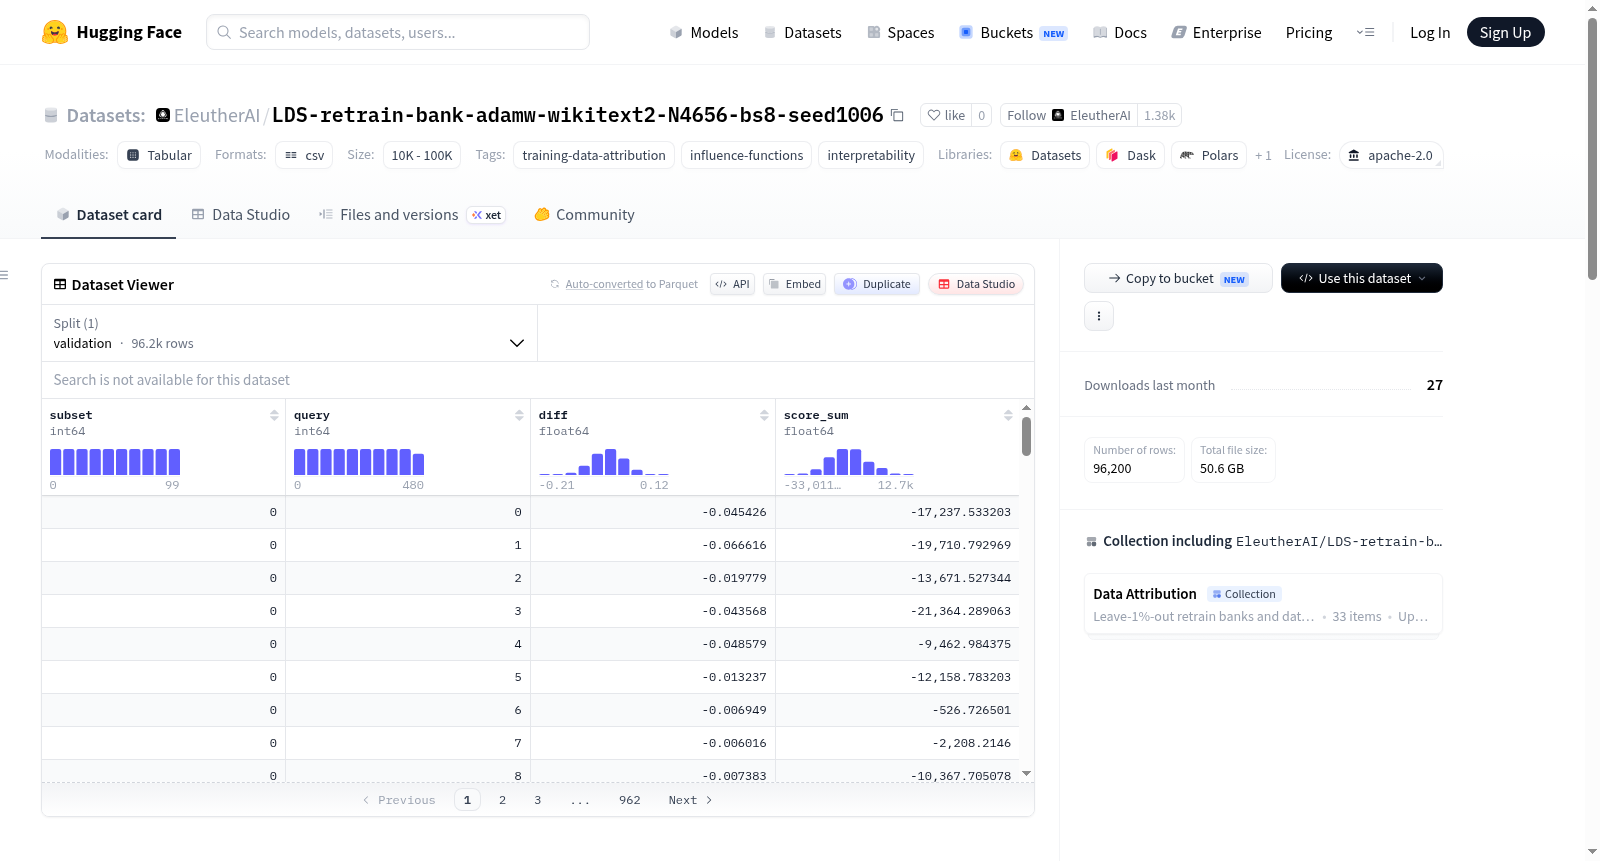
validation.csv 基准真值:481 个验证查询在(子集,查询)层面的损失变化,以及被移除文档的 EK-FAC 影响力之和
subsets.json 每个子集移除的文档 ID
config.yaml 精确的训练配置
summary*.csv 每个查询的 EK-FAC LDS 值

用途

  • 验证集为每个半集训练对查询损失的影响提供了真实基准
  • 用户可将自己的方法预测的影响力与 diff 列进行相关性分析
  • LDS 定义为:对 481 个查询取 Spearman 相关系数的均值
  • 该目录可直接作为 bergson validate 步骤的 retrained_dir 使用

多种子扩展

共有五个共享相同 100 个子集但训练种子不同的库(seed 1004–1008),对五个种子的查询损失取平均可得到 bergson 复现中所使用的更高精度基准真值。

训练配置

  • 优化器:AdamW(β=(0.9, 0.999),ε=1e-8)
  • 学习率:3e-5(恒定)
  • 权重衰减:0.01
  • 批大小:8
  • 轮数:3
  • 精度:fp32,启用 dropout
  • 随机种子:1006

基准方法性能(基于五种子真值)

方法 LDS(481 个查询的平均 Spearman,95% 置信区间)
EK-FAC IF 0.468 ± 0.015
SOURCE 0.476 ± 0.015

生成工具

bergson 项目生成,具体配置见 examples/replicate_bae_approx_unrolling_source/wikitext_gpt2_retrain.yaml

搜集汇总
数据集介绍
LDS-retrain-bank-adamw-wikitext2-N4656-bs8-seed1006 数据集图片
构建方式
本数据集源于对语言模型可解释性领域的深入探索,旨在通过重训练范式精确度量训练数据对模型预测的影响。其构建过程严谨而系统,依托EleutherAI/bergson-wikitext-2-4656-chunks语料库,选取其中4656篇文档构成WikiText-2训练集,并采用随机二分策略生成100个互异的50%子集(每子集含2328篇文档)。针对每个子集,以GPT-2为基础模型,遵循Bae等人提出的近似展开微分(Approximate Unrolled Differentiation)方案,配置AdamW优化器、恒定学习率3e-5、批大小8及3轮训练,从零开始微调,最终形成100个完全重训练的模型实例。同时,为提供对照基准,另在完整训练集上以相同随机种子训练一个基线模型。上述模型的参数配置、数据划分细节均存档于config.yaml与subsets.json,确保实验的完全可复现性。
特点
该数据集的核心特征在于其作为‘重训练库’的完备性与多样性。它不仅存储了模型权重,更附带了关键的真实标签——validation.csv文件记录了481个验证查询在各子集训练前后的损失变化,这一度量构成了评估训练数据归因方法的黄金标准。数据集设计精巧,通过控制子集划分的一致性而改变训练种子,衍生出五个平行仓库,支持跨种子平均化以获取更稳健的评估结果。其独特之处在于,每个子集代表一次独立的训练实验,使得研究者能够直接观测到移除特定数据子集对模型行为产生的因果效应,为解析模型内部决策机制提供了前所未有的微观视角。
使用方法
本数据集的使用便捷而直观,适用于训练数据归因与模型可解释性研究。研究者可通过huggingface_hub的snapshot_download接口获取全部资源,随后依据validation.csv中记录的损失差值(diff)作为真实值,将自身提出的归因方法所预测的影响分数与其进行相关分析。评估指标采用LDS(Loss Drop Spearman),即对481个查询计算预测值与实测值间的斯皮尔曼秩相关系数并取均值。此外,目录结构可直接对接bergson框架的validate流程,简化了评估管线。通过对比五种子平均后的基准性能,研究者可客观衡量新方法的有效性,推动该领域的理论进步。
背景与挑战
背景概述
该数据集由EleutherAI研究机构于近期创建,旨在为训练数据归因(Training Data Attribution)研究提供高质量的基准资源。其核心研究问题在于如何精确评估单个训练样本对模型预测的影响,这是可解释人工智能领域的关键挑战。通过复现Bae等人2024年提出的近似展开微分方法,该数据集包含100个在WikiText-2语料库随机一半子集上微调的GPT-2模型,并提供了每个子集对481个验证查询损失变化的精确测量。这一设计使得研究者能够验证和比较不同归因方法的性能,如EK-FAC和SOURCE,推动了数据归因领域从理论走向实证,对提升大语言模型的透明度和可信度具有重要影响力。
当前挑战
该数据集应对的领域问题在于训练数据归因的长期挑战:精确计算单个样本对模型行为的贡献通常需要昂贵的重训练或近似计算,而现有方法缺乏可靠的基准。构建过程中,研究者面临双重难题:一是严格复现标准训练设置(如优化器、学习率、批次大小等)以确保公平比较,二是管理计算资源,因为训练100个GPT-2模型(每个在2328个文档上微调)需要显著的计算能力,同时确保五个种子的一致性以提供准确的地面真值。此外,验证查询的选择和损失变化的精确测量也构成了方法论上的挑战,以确保归因评估的可靠性和泛化性。
常用场景
经典使用场景
该数据集作为训练数据归因(Training Data Attribution)领域的关键基准资源,其核心用途在于评估和验证各类归因方法的有效性。具体而言,它提供了100个在随机半份WikiText-2子集上微调的GPT-2模型,以及相应的验证集查询损失变化,使得研究者能够精确地衡量不同归因算法在预测训练数据对模型行为影响时的准确性。这一设计遵循了Bae等人提出的近似展开微分框架,为量化训练样本对模型预测的贡献提供了可复现的黄金标准,广泛应用于归因方法的对比实验与超参数调优。
衍生相关工作
该数据集沿袭了EleutherAI在训练数据归因领域的深入探索,其构建方法直接呼应了Bae等人关于近似展开微分的开创性工作。其中所包含的多种子重训练银行(种子1004至1008)为后续研究提供了丰富的复现与扩展素材,催生了对归因方法鲁棒性的系统性分析。以该数据集为基准,研究者进一步衍生了关于更高效影响函数近似、数据子集选择优化及模型行为归因解释等方向的工作,推动了如SOURCE等先进方法的发展,并促进了归因技术在大型语言模型可解释性领域的交叉融合,形成了活跃的研究生态。
数据集最近研究
最新研究方向
该数据集致力于训练数据归因方法的前沿验证,通过构建百个重训语言模型的基准库,为影响函数与近似展开方法提供精确的ground truth,推动可解释AI在数据溯源与模型行为剖析领域的实证研究。其设计融合了随机子集训练与多种子聚合策略,显著提升了归因评分稳定性,成为评估新方法有效性的关键参照。当前热点聚焦于高效归因算法的开发与跨模型泛化能力的探究,该资源为此类研究提供了标准化的实验平台,对深化数据影响理解、优化训练数据治理及增强模型透明度具有重要科学意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务