
Neomi26/cc12m-images-015
收藏官方服务:
资源简介:
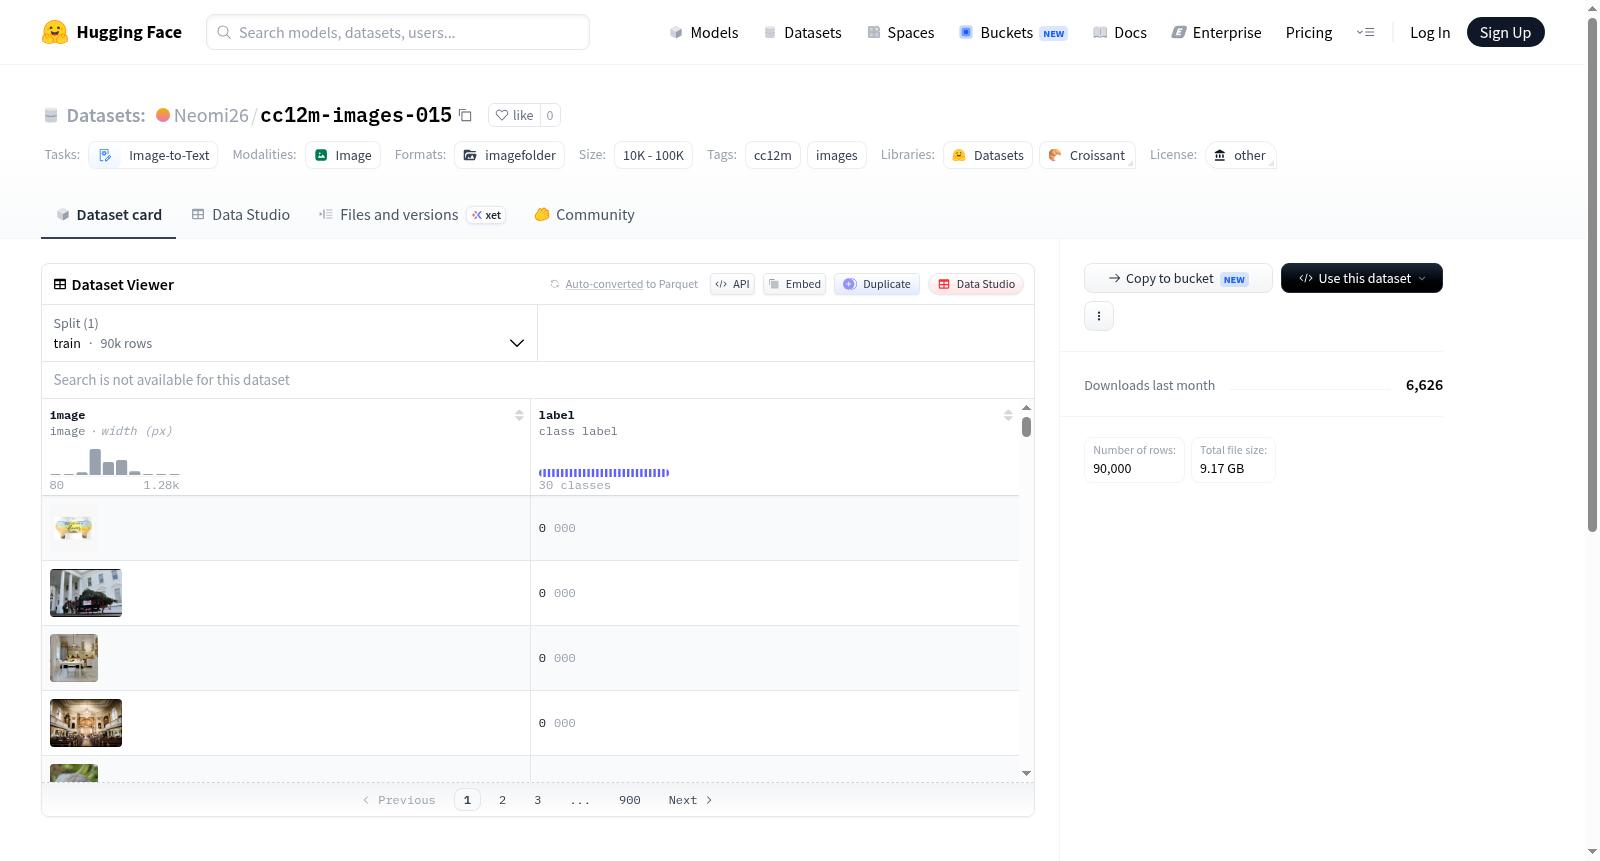
cc12m-images-015是CC12M数据集的子集,包含90,000张图像,已重新托管为单独的JPEG文件,以便通过浏览器直接访问。图像URL遵循特定模式,并提供了清单文件manifest.parquet,其中包含键、图像URL、源URL、标题、宽度、高度、原始宽度、原始高度、分片、仓库和路径等列。该数据集是Neomi26/cc12m-images-NNN系列的一部分,原始数据集为pixparse/cc12m-wds。
cc12m-images-015 is a subset of the CC12M dataset, consisting of 90,000 images re-hosted as individual JPEG files for browser access. The image URL follows a specific pattern, and a manifest file manifest.parquet is provided with columns such as key, image_url, source_url, caption, width, height, original_width, original_height, shard, repo, and path. It is part of the Neomi26/cc12m-images-NNN series, with the original dataset being pixparse/cc12m-wds.
提供机构:
Neomi26搜集汇总
数据集介绍
构建方式
cc12m-images-015 数据集源自广为人知的 CC12M 大规模图文对数据集,经过精心筛选与重构,从原始 WebDataset 格式转化为独立 JPEG 文件,以便于浏览器直接访问。该子集包含 90,000 张图像,按照预设的文件夹与键值规则进行组织,并提供清单文件 manifest.parquet,详列每张图像的键、图像链接、原始来源 URL、对应的文本描述、尺寸信息及所属分片等元数据,形成一套完整且结构化的图像存储体系。
使用方法
使用该数据集时,开发者可直接通过描述中的 URL 模式拼接图像链接进行访问,例如基于 manifest.parquet 中的 key 与 folder 字段自动生成图像路径。清单文件本身亦可作为高效的数据索引,支持按需加载特定图像及其对应的图文对。对于大规模训练任务,建议利用全局索引整合所有子集的图像,实现分布式加载与多模态模型的高效训练。
背景与挑战
背景概述
cc12m-images-015 数据集源自 Conceptual 12M(CC12M),这是一个由谷歌研究团队于2021年发布的大规模图文对数据集,旨在为图像到文本生成任务提供高质量的训练样本。该数据集通过精心设计的过滤策略从网络爬取约1200万张图像及其对应描述,显著推动了多模态学习的发展,尤其在视觉语言预训练模型(如CLIP、ALIGN)中发挥了基石作用。cc12m-images-015 作为其子集,由研究者 Neomi26 重新托管为90,000张独立JPEG文件,并通过统一的URL模式便于浏览器直接访问,同时附带详尽的清单文件,记录了每张图像的元数据,进一步提升了数据集的可复用性与易用性。这一举措不仅扩展了CC12M的应用场景,也为小规模实验和快速原型开发提供了便利。
当前挑战
cc12m-images-015 所解决的领域问题是图像到文本生成任务中大规模高质量图文对的稀缺性。原始CC12M通过网络爬取构建,面临噪声数据(如描述不准确、图像质量参差不齐)和版权问题的挑战,需要复杂的过滤与清洗流程以确保数据可靠性。在本数据集的构建过程中,研究人员遇到了存储与访问效率的挑战:将原始WebDataset格式转换为独立的JPEG文件,需处理超过12TB的数据量,并确保90,000张图像的文件名、路径与元数据精确对应,同时维护122个仓库的全局索引一致性,这一过程对存储优化、数据校验和版本管理提出了严苛要求。
常用场景
经典使用场景
CC12M作为大规模图文对数据集,其子集cc12m-images-015在视觉与语言预训练领域扮演着基石角色。研究者常利用该数据集进行图像-文本匹配、跨模态检索以及视觉定位等经典任务的模型训练与评估。通过构造高质量的图文对样本,该数据集为CLIP、ALIGN等对比学习框架提供了丰富的训练素材,促使模型在零样本分类、图像描述生成等下游任务中展现卓越的泛化能力。其精心整理的90,000张JPEG图像与对应文本描述,确保了数据加载的高效性与实验复现的可靠性。
解决学术问题
在学术研究中,该数据集有效应对了多模态学习中的数据稀缺问题,特别是针对图文对齐关系的建模难题。它支持研究者深入探索弱监督学习范式下视觉语义的捕捉机制,解决了从海量网络数据中自动学习鲁棒特征表示的挑战。通过提供标准化的数据接口与元数据,cc12m-images-015促进了图像质量、文本噪声对模型性能影响的可控实验,推动了如ALBEF、VLMO等先进算法在图文表征一致性上的突破,为后续涌现的新颖架构奠定了坚实的实验基准。
实际应用
实际应用中,基于cc12m-images-015训练的多模态模型被广泛集成于智能图像搜索引擎、辅助视觉障碍用户的内容理解系统以及社交媒体的自动标签推荐服务。企业可利用该数据集微调出适配特定品类的商品描述生成器,实现电商场景下的自动化文案产出。此外,广告投放平台借助其图文对齐能力,能够更精准地匹配广告素材与用户兴趣,提升点击转化率。这些落地实践显著降低了人工标注成本,加速了从视觉内容到自然语言桥梁的工业化构建。
数据集最近研究
最新研究方向
cc12m-images-015作为CC12M数据集的子集,专注于图像-文本对齐任务,在当前多模态学习前沿中占据重要地位。该数据集精选约9万张高分辨率图片,并配有描述性文本,为视觉语言模型的微调与评估提供了轻量化、可便捷访问的资源。随着CLIP、BLIP等跨模态预训练模型的蓬勃发展,CC12M及其子集成为研究图像-文本表征学习、零样本迁移及细粒度语义匹配等热点方向的关键基准。其公开的manifest.parquet文件详细记录了图像元数据,进一步支持了数据质量分析、偏差检测及模型鲁棒性研究,推动多模态系统在内容审核、知识蒸馏等实际应用中的落地。
以上内容由遇见数据集搜集并总结生成


