criteo/FairJob
收藏资源简介:
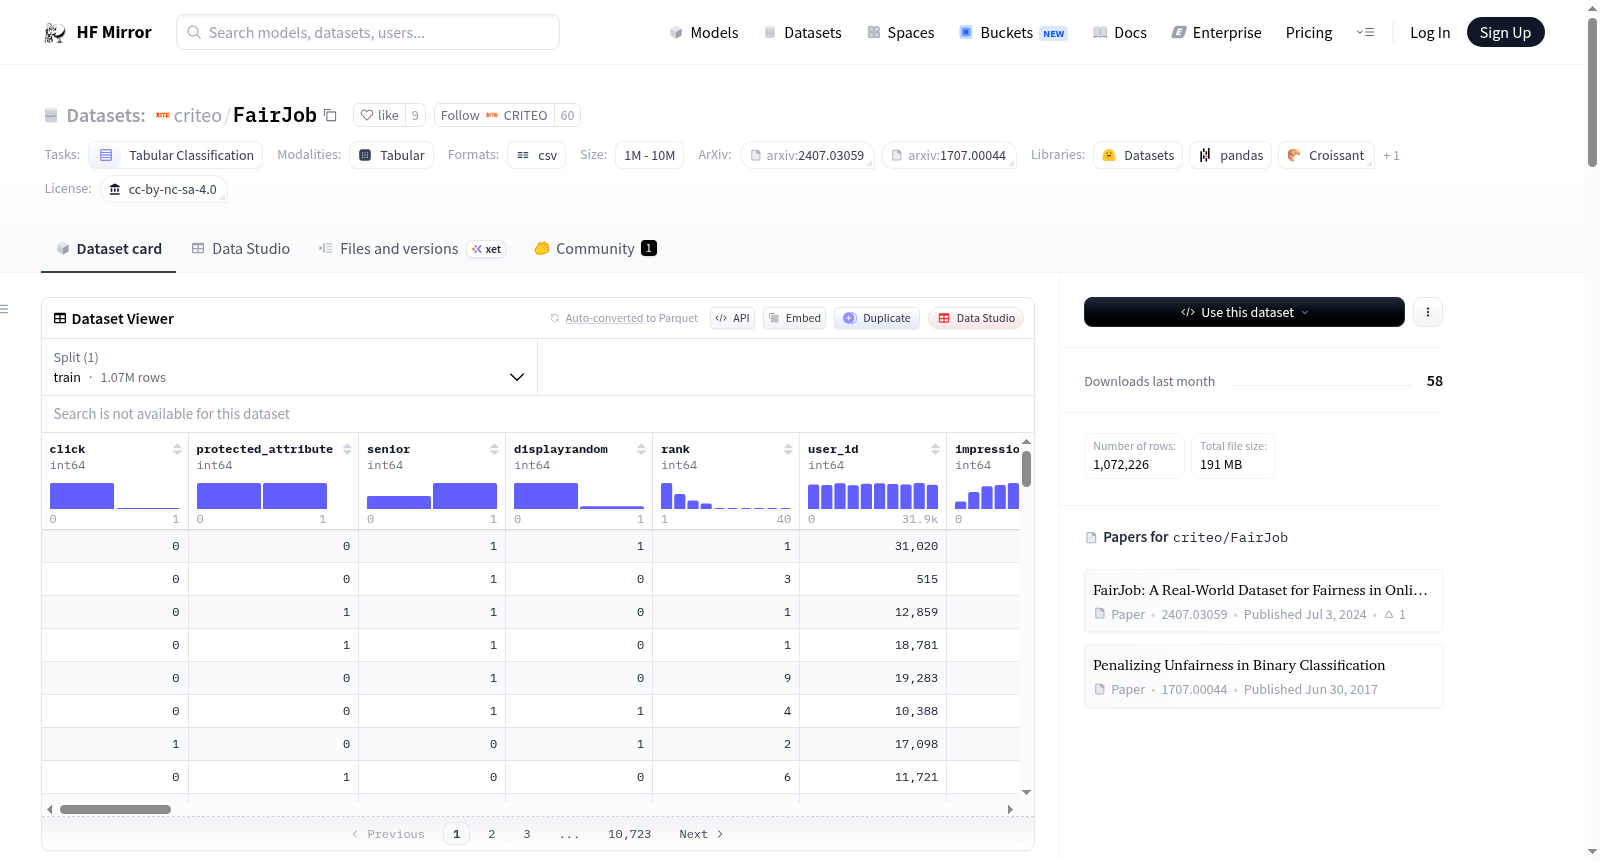
FairJob数据集由Criteo发布,旨在促进广告和AI系统中的公平性研究。数据集包含1072226行和55列,每行代表一个展示给用户的产品,用户可以在一个展示会话中看到多个产品。数据集的特征包括用户ID、产品ID、展示ID、匿名分类用户特征、匿名分类产品特征、匿名数值用户特征等。标签包括保护属性(性别代理)、职位级别、产品展示位置、点击等。数据集的局限性包括性别代理的近似性、历史偏见和市场不公平性等。挑战包括处理混合类型数据、长尾现象、产品流行度偏差和高度不平衡的数据。评估指标包括负对数似然和基于职位级别的公平性度量。
The FairJob dataset is released by Criteo to foster research and innovation on Fairness in Advertising and AI systems. The dataset contains 1072226 rows and 55 columns, with each row representing a product shown to a user. Users can see multiple products in a single impression session. The dataset features include user ID, product ID, impression ID, anonymized categorical user features, anonymized categorical product features, and anonymized numerical user features. Labels include protected attribute (gender proxy), job seniority, product display position, and click. Limitations of the dataset include the approximation of gender proxy, historical bias, and market unfairness. Challenges include handling mixed-type data, long-tail phenomenon, product popularity bias, and highly imbalanced data. Evaluation metrics include negative log-likelihood and fairness metrics based on job seniority.
CRITEO FAIRNESS IN JOB ADS DATASET
概述
该数据集由Criteo发布,旨在促进广告和AI系统中公平性的研究和创新。数据集旨在用于学习点击预测模型,并评估这些模型在不同性别群体中的预测偏差。
许可
数据集基于CC-BY-NC-SA 4.0许可发布。您可以自由分享和改编这些数据,前提是您遵守署名、非商业用途和相同方式共享的条件。请在使用前仔细阅读完整许可。
数据描述
数据集包含Criteo AdTech公司运行了5个月的职位定向广告活动中收集的匿名用户上下文和发布者特征。每行代表向用户展示的产品。每个用户都有一个印象会话,可以在同一时间看到多个产品。每个产品可能被用户点击或未点击。数据集包含1072226行和55列。
- 特征
user_id:分配给每个用户的唯一标识符,已匿名化。product_id:分配给每个产品的唯一标识符,即职位广告。impression_id:分配给每个印象的唯一标识符,即可以同时显示多个产品的在线会话。cat0到cat5:匿名的分类用户特征。cat6到cat12:匿名的分类产品特征。num13到num47:匿名的数值用户特征。
- 标签
protected_attribute:描述用户性别代理的二元特征,女性为0,男性为1。senior:描述职位高级性的二元特征,助理角色为0,管理角色为1。rank:对应于产品在给定impression_id显示中的位置排序的数值特征。displayrandom:如果与同一impression_id相关的产品在横幅上的显示位置被随机化,则为1。click:如果用户在印象impression_id中点击了产品product_id,则为1。
数据统计
| 维度 | 平均值 |
|---|---|
| click | 0.077 |
| protected attribute | 0.500 |
| senior | 0.704 |
受保护属性
由于Criteo无法访问用户人口统计信息,我们报告了一个性别代理作为受保护属性。该代理以二元形式报告,但我们承认性别不一定是二元的。
代理值计算为用户时间线中看到的产品性别属性的多数。具有性别属性的产品通常是时尚和服装。我们鼓励在其他属性方面进行公平性研究。
限制和解释
我们指出,提出的性别代理并不给出性别的定义。由于我们无法访问敏感信息,这是我们目前识别匿名数据偏差的最佳解决方案,我们鼓励任何关于更好近似的讨论。虽然我们的研究聚焦于性别,但这不应减少调查其他类型算法歧视的重要性。尽管该数据集在公平性算法的高风险领域提供了重要的应用,但存在一些基本限制,这些限制无法通过数据收集或整理过程轻易解决。这些限制包括影响用户正面结果的历史偏差,以及无法验证性别代理与真实性别值的接近程度。此外,可能存在市场不公平导致的偏差。在使用该数据集进行研究时,应考虑这些限制和可能的伦理问题。读者不应将该数据集的汇总统计数据解释为真实情况,而应仅视为数据集的特征。
指标
强烈建议使用负对数似然(越低越好)来衡量预测质量。
建议通过根据高级职位广告的条件化人口统计平权来衡量广告的公平性:
$$ E[f(x) | protected_attribute=1, senior=1] - E[f(x) | protected_attribute=0, senior=1] $$
这对应于两个性别群体在高级职位机会预测中的平均差异(越低越好)。直观上,当该指标较低时,意味着我们不会偏向于向一个性别展示更多高级职位机会。
示例
您可以通过运行example.py(需要numpy + torch)开始。这实现了:
- 一个虚拟分类器(完全公平但不太有用)
- 一个带有分类特征嵌入的逻辑回归(很大程度上不公平且有用)
- 一个“公平”逻辑回归(相对公平且有用)
“公平”逻辑回归基于Bechavod & Ligett提出的方法。
引用
如果您在研究中使用该数据集,请使用以下Bibtex条目引用:
@misc{criteo_fairness_dataset author = {CRITEO}, title = {{CRITEO FAIRNESS IN JOB ADS DATASET}, year = {2024}, howpublished= {url{http://XXX}}