sarvam/sft_saaras_flow
收藏资源简介:
sft_saaras_flow数据集是一个用于ASR(自动语音识别)转录校正的合成SFT(监督微调)数据集,旨在将大型模型(Gemini 3.1 Pro)蒸馏为较小的校正模型。数据集包含1100个示例,覆盖11种语言:英语、印地语、马拉地语、古吉拉特语、卡纳达语、泰米尔语、泰卢固语、马拉雅拉姆语、奥里亚语、孟加拉语和旁遮普语,每种语言100个示例。每个示例包括原始ASR转录文本(使用口语的本土文字)、应用配置(如校正模式、风格预设、语言提示等参数)以及通过应用的真实格式化提示生成的校正后输出。数据集格式为SFT格式,其中messages列已准备好用于聊天SFT,包括系统提示(校正提示)、用户转录(原始转录)和助手校正转录(校正后转录)。其他列提供语言、用户转录、校正转录、各种轴配置(如模式、风格预设等)、检测到的语言、校正提示以及生成元数据(如步骤1和步骤3元数据、错误信息)。数据集适用于文本生成任务,支持多语言处理,并强调合成数据和ASR转录校正的应用。
The sft_saaras_flow dataset is a synthetic SFT (Supervised Fine-Tuning) dataset for ASR (Automatic Speech Recognition) transcription correction, designed to distill a large model (Gemini 3.1 Pro) into a smaller correction model. It contains 1100 examples across 11 languages: English, Hindi, Marathi, Gujarati, Kannada, Tamil, Telugu, Malayalam, Odia, Bengali, and Punjabi, with 100 examples per language. Each example includes a raw ASR transcript (in the native script of the spoken language), app configuration (such as correction mode, style preset, language hint, and other variation axes), and the corrected output generated by the apps real formatting prompt. The dataset is formatted for SFT, with the messages column ready for chat-SFT, comprising the system prompt (correction prompt), user transcript (raw transcript), and assistant corrected transcript (corrected transcript). Additional columns provide language, user transcript, corrected transcript, various axis configurations (e.g., mode, style preset, language hint, app category, detected patterns, faithfulness enabled, high polish, english full style, memory hints, persona bias), along with persona, variation, detected languages, correction prompt, and generation metadata (step1_meta, step3_meta, error). The dataset is suitable for text-generation tasks, supports multilingual processing, and emphasizes synthetic data and ASR transcription correction applications.
- 数据集名称:
sarvam/sft_saaras_flow - 任务类型: 文本生成
- 模态: 文本
- 语言: 英语、印地语、马拉地语、古吉拉特语、卡纳达语、泰米尔语、泰卢固语、马拉雅拉姆语、奥里亚语、孟加拉语、旁遮普语,共11种语言
- 规模: 1000 - 10000 行(具体为1100行)
- 格式: parquet, optimized-parquet
- 标签: Synthetic, asr, transcription-correction, sft, distillation
- 许可证: Apache-2.0
- 数据集描述: 该数据集是合成SFT数据,用于ASR转录纠错,旨在通过蒸馏大型模型(Gemini 3.1 Pro)来训练一个较小的纠错模型。每个样本包含一个真实的原始ASR转录(使用口语的本土文字)及其应用配置(变化轴)和纠正后的输出。
- 数据集结构:
- 包含一个子集
default,共1100行,并只有一个分割train。 - SFT格式 (
messages列): 可直接用于聊天SFT训练:system对应correction_prompt,user对应user_transcript,assistant对应corrected_transcript。 - 其他主要列:
language,user_transcript,corrected_transcript, 配置列(mode,style_preset,language_hint,app_category,detected_patterns,faithfulness_enabled,high_polish,english_full_style,memory_hints,persona_bias),以及persona,variation,detected_languages,correction_prompt, 元数据(step1_meta,step3_meta,error)。
- 包含一个子集
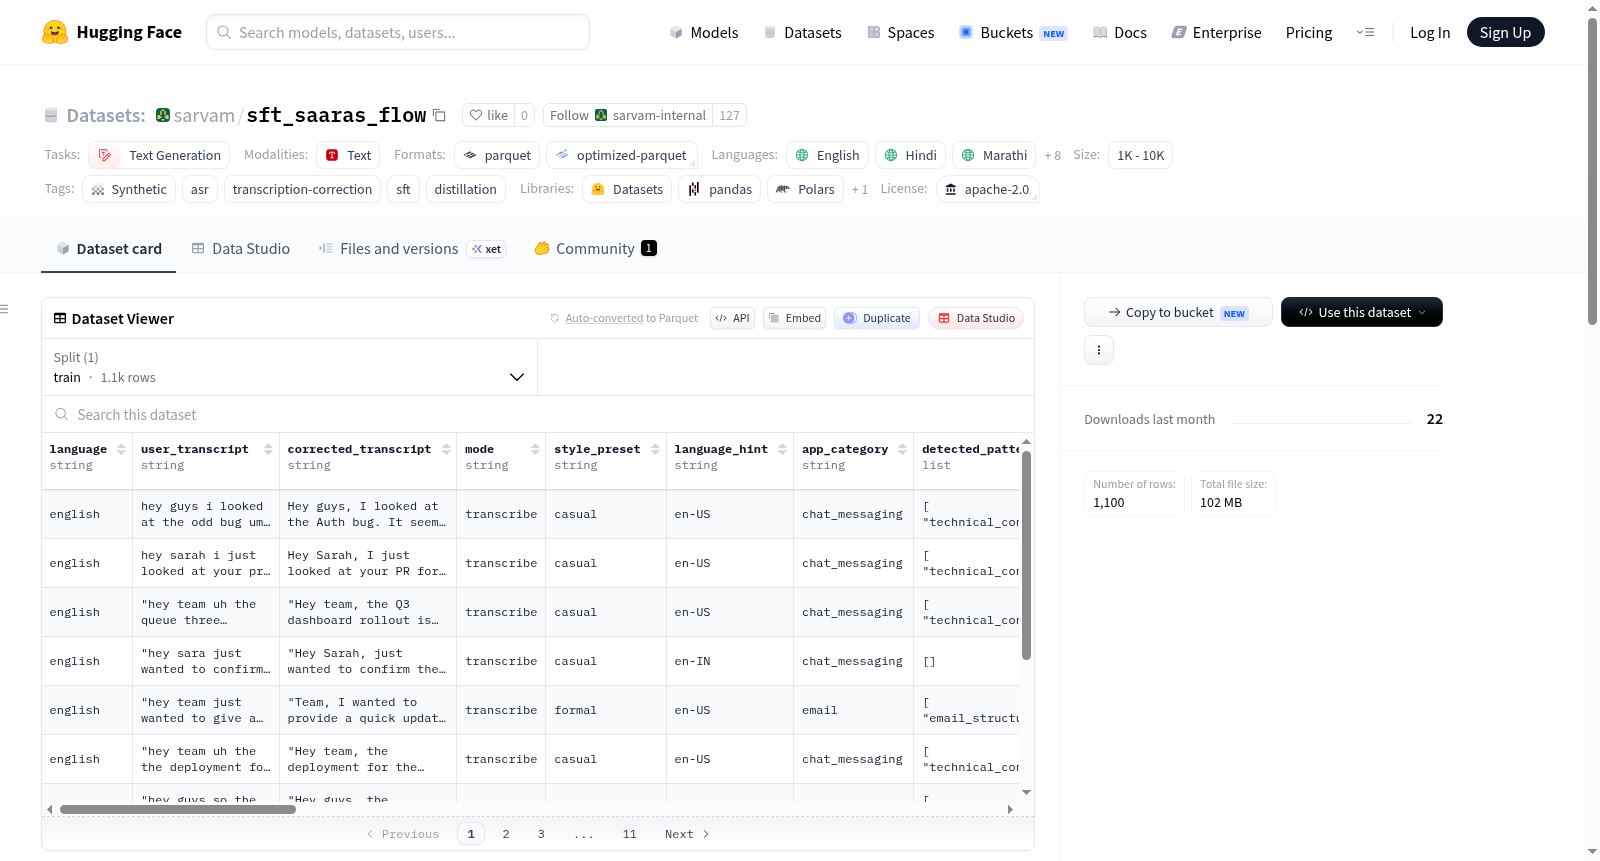
- 数据预览示例: 展示了10行数据,包括英语对话、技术场景,其中用户转录包含口语错误(如填充词、同音词错误),纠正后的转录会修正这些错误并规范化文本。
- 每月下载量: 22
- 总文件大小: 102 MB