omnimcp_enterprise_data_platform_village_teaser
收藏资源简介:
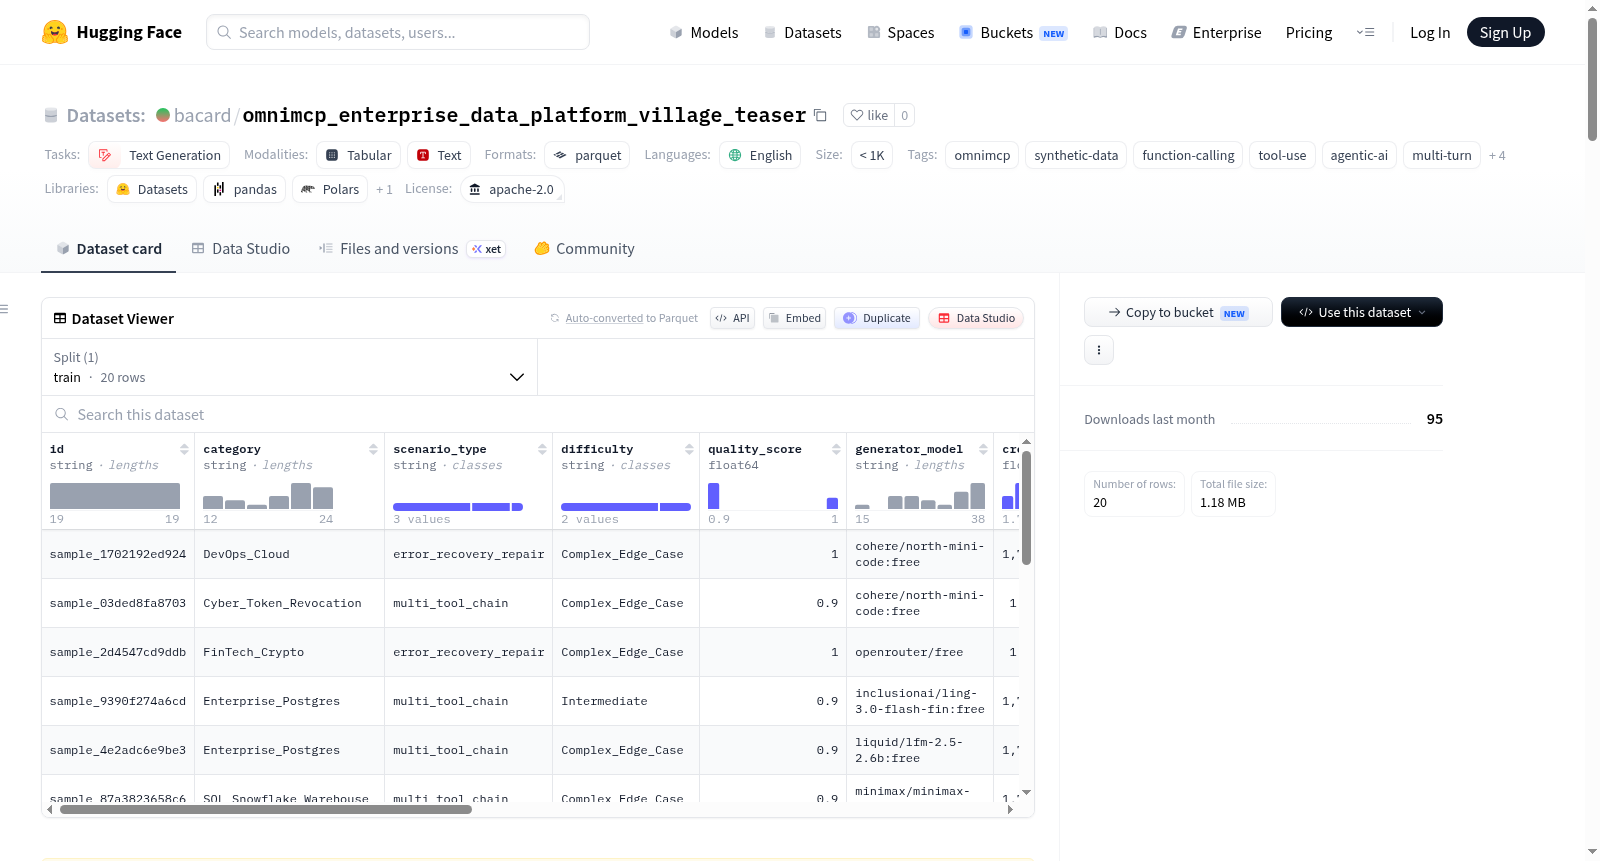
该数据集是OmniMCP企业现代数据平台村庄(Village)的免费评估预告版本,专注于全栈数据操作(DataOps)与云数据仓库套件。数据集包含经过验证的多轮对话代理AI训练样本,旨在训练AI代理统一事务数据库和多云数据仓库,优化聚类、强制分区过滤并防止内存泄漏。数据集涵盖Postgres、Snowflake、BigQuery、Kafka、dbt等现代数据技术栈,适用于函数调用、工具使用、对话生成、文本生成等任务。数据集规模小于1000个样本,所有数据均为合成数据,经过严格语法验证(AST和Pydantic)且符合GDPR/DSGVO合规要求,完全声明为合成来源。
This dataset is a free evaluation preview version of the OmniMCP Enterprise Modern Data Platform Village, focusing on full-stack DataOps and cloud data warehouse suites. It contains validated multi-turn conversational agent AI training samples, designed to train AI agents to unify transactional databases and multi-cloud data warehouses, optimize clustering, enforce partition filtering, and prevent memory leaks. The dataset covers modern data technology stacks such as Postgres, Snowflake, BigQuery, Kafka, and dbt, and is suitable for tasks like function calling, tool usage, dialogue generation, and text generation. The dataset size is less than 1000 samples, all data is synthetic, strictly grammar-validated (AST and Pydantic), compliant with GDPR/DSGVO requirements, and fully declared as synthetic.
OmniMCP: Enterprise Modern Data Platform Village - Full-Stack DataOps & Cloud Warehouse Suite (Evaluation Teaser)
数据集概述
这是一个企业级现代数据平台领域的多轮对话式AI训练数据集,属于OmniMCP模块化生态系统中的"Enterprise Modern Data Platform Village"套件。该数据集为官方免费评估预览版,专注于多轮代理式AI(Multi-Turn Agentic AI)场景,核心目标为统一事务数据库与多云数据仓库,训练AI代理优化聚类、执行分区过滤以及防止内存泄漏。
基本信息
| 属性 | 值 |
|---|---|
| 语言 | 英语 (en) |
| 许可证 | Apache 2.0 |
| 任务类别 | 对话 (Conversational)、文本生成 (Text Generation) |
| 数据集规模 | n < 1K(少于1000条样本) |
| 标签 | omnimcp、synthetic-data、function-calling、tool-use、agentic-ai、multi-turn、unsloth、axolotl、vllm |
核心特点
- 验证性多轮Agentic AI数据集:专为训练AI代理在实际企业数据平台环境中执行多轮工具调用而设计。
- 数据合成:所有数据均为完全合成生成,符合GDPR/DSGVO标准,使用数学上净化的RFC 2606数据。
- 质量保证:声明0.0%语法错误率,经过严格的AST与Pydantic验证。
- 合规性:完整声明符合欧盟AI法案第50条与第53条的合成来源要求。
覆盖领域
数据集聚焦于企业现代化数据平台技术栈,涵盖以下组件:
- PostgreSQL:事务数据库优化
- Snowflake:云数据仓库
- BigQuery:云数据分析
- Kafka:流式数据管道
- dbt:数据转换工具
数据加载示例
python from datasets import load_dataset
dataset = load_dataset("bacard/omnimcp_enterprise_data_platform_village_teaser") print(f"Loaded {len(dataset[train])} verified multi-turn training samples!") print(dataset[train][0])
商业背景与完整版
该Teaser为免费评估版本,完整生产级主包由商业许可提供。OmniMCP采用四级模块化层级结构,企业数据平台Village属于第3级(Level 3: The Village),每个Village由多个专业House(第2级)组合而成,其中"Enterprise Modern Data Platform"对应完整商业套件。