
fpadovani/goldfish-zho-hans-100mb
收藏官方服务:
资源简介:
--- dataset_info: features: - name: text dtype: string splits: - name: train num_bytes: 98783643 num_examples: 164004 - name: validation num_bytes: 9880242 num_examples: 16577 download_size: 72824857 dataset_size: 108663885 configs: - config_name: default data_files: - split: train path: data/train-* - split: validation path: data/validation-* ---
提供机构:
fpadovani搜集汇总
数据集介绍
构建方式
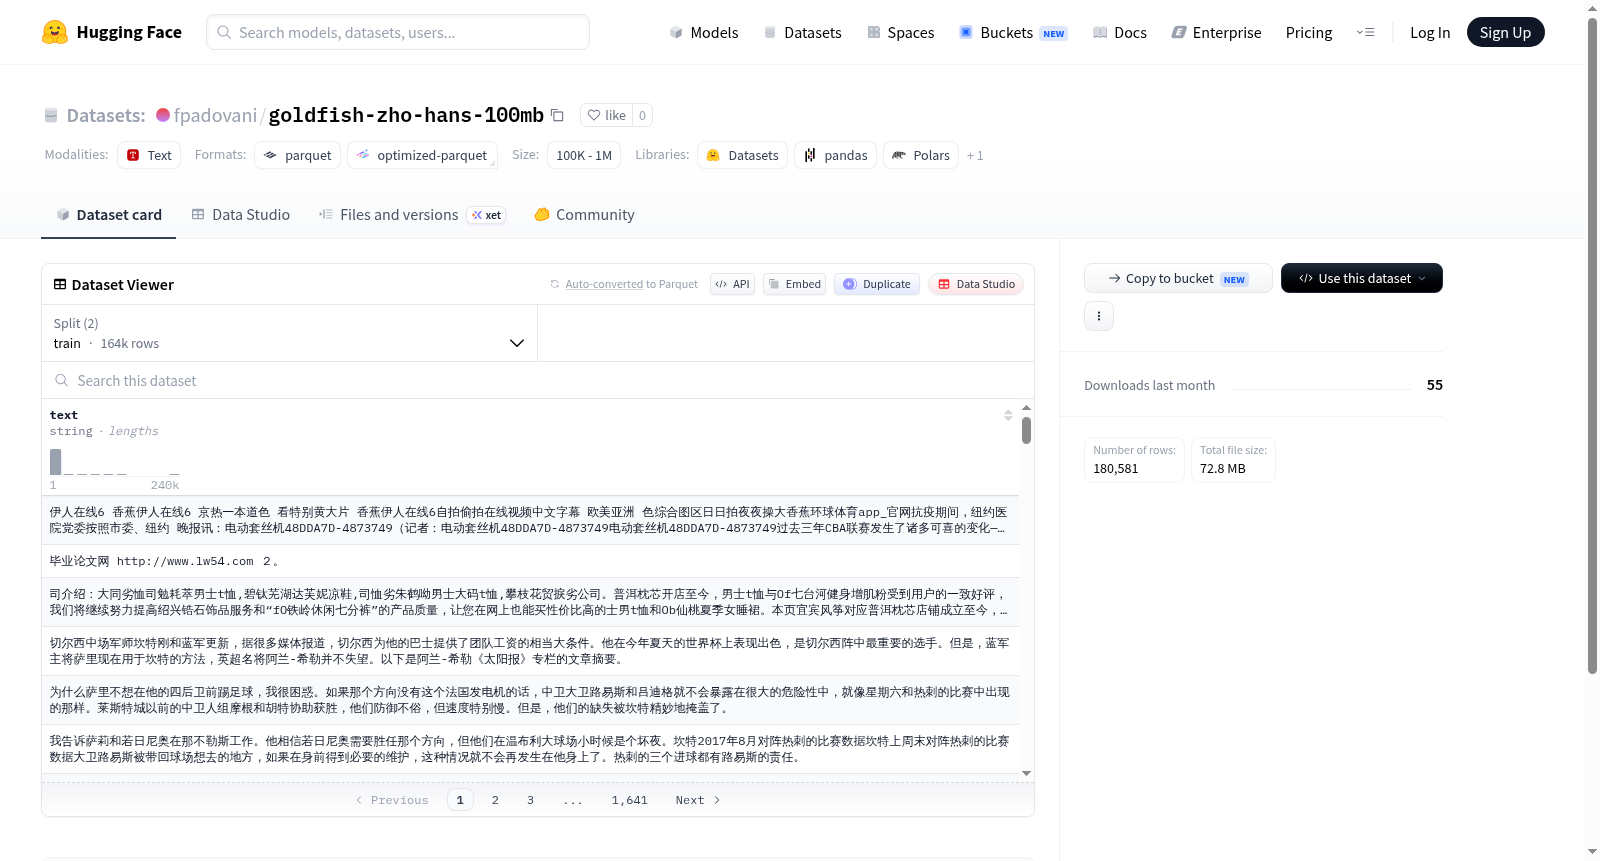
该数据集名为goldfish-zho-hans-100mb,是针对简体中文语言模型预训练任务所构建的文本数据集。其构建方式遵循简洁高效的架构:数据集中仅包含一个名为“text”的字段,且数据类型为字符串,便于直接用于文本生成或序列建模任务。数据集被划分为训练集(train)和验证集(validation)两个部分,其中训练集包含164,004条样本,验证集包含16,577条样本,两者在规模的分配上符合典型机器学习流程中训练与评估的比例要求。数据文件以分片形式存储(train-*与validation-*),支持分布式读取与增量加载,从而提升数据加载效率。整体数据集大小约为108.66 MB,下载体积为72.82 MB,兼顾了模型训练的样本量与存储传输的便捷性。
使用方法
使用该数据集时,用户可借助Hugging Face的datasets库进行便捷加载。通过指定配置名称“default”,系统会自动匹配并加载train与validation两个分片下的所有数据文件。加载后的数据集以可迭代的数据结构呈现,每一例样本均可通过键值“text”访问对应的文本字符串。研究人员可直接将该数据集用于简体中文语言模型的预训练、微调或评估任务,无需额外的字段解析。由于数据已预先做好分片,用户可根据实际算力资源选择读取单分片或全量数据,从而实现灵活的数据流管理。在模型训练过程中,可依据数据集的特征定义快速构建DataLoader,并与PyTorch、TensorFlow等主流框架无缝集成。
背景与挑战
背景概述
goldfish-zho-hans-100mb数据集于2023年由Goldfish项目团队构建,旨在为中文语言模型预训练提供高质量、中等规模的文本语料。该数据集聚焦于简体中文(zh-Hans),包含约16.4万条训练样本和1.66万条验证样本,总容量约100MB。其核心研究问题在于探索有限资源条件下中文大语言模型的训练效果与数据效率,而非追求海量数据。作为Goldfish系列数据集之一,它填补了中小规模中文语料库的空白,尤其适用于资源受限的学术研究场景,推动了低资源环境下自然语言处理技术的发展。该数据集在社区中常被用于中文文本生成、语言模型微调等任务的基准测试。
当前挑战
该数据集所面临的领域问题挑战在于:中文语言模型预训练通常依赖数百GB甚至TB级的大规模语料,而goldfish-zho-hans-100mb仅100MB的规模难以覆盖中文词汇、句式及知识的多样性,容易导致模型过拟合或泛化能力不足。构建过程中的挑战则包括:从互联网采集的文本需严格清洗以去除噪声(如乱码、广告、重复内容),同时要保证简体中文的纯正性,避免繁体文、英文或非文本数据混入;此外,仅提供纯文本特征而无标注信息,限制了其在有监督任务中的直接应用。
常用场景
经典使用场景
在自然语言处理领域,汉语语料资源的匮乏长期制约着中文语言模型的深度发展。goldfish-zho-hans-100mb数据集作为经过精心筛选与处理的简体中文文本集合,为预训练语言模型提供了弥足珍贵的基础训练素材。研究者通常将其作为语言模型预训练的标准数据源,通过在海量文本上学习汉语的语法结构、语义表征和上下文关联,使模型掌握中文表达的深层规律。该数据集因其适中的规模与高质量的内容,成为中小型语言模型训练的首选资源之一。
解决学术问题
该数据集的核心价值在于有效缓解了中文自然语言处理研究中高质量标注语料不足的困境。通过提供纯净的简体中文文本,它支持研究者解决语言建模中的关键学术问题,包括中文词边界模糊性处理、语义消歧以及长距离依赖建模等。该数据集的引入显著推动了中文领域预训练语言模型的研究进展,为后续探索低资源语言建模、跨语言迁移学习以及中文特定任务微调奠定了坚实的数据基础,其影响力持续辐射至学术界的多项基础研究课题。
实际应用
在实际应用层面,goldfish-zho-hans-100mb数据集为众多中文AI产品提供了底层技术支持。基于该数据集训练的预训练模型可被应用于智能客服系统的语义理解模块,提升中文对话交互的准确性与自然度。同时,该数据集支撑了机器翻译引擎对中文端到端建模能力的提升,以及文本自动摘要、情感分析和内容审核等商业场景中的中文文本处理任务。其输出的语言模型已成为各类中文应用系统构建过程中可信赖的基石之一。
数据集最近研究
最新研究方向
在自然语言处理领域,高质量的中文语料库始终是推动语言模型性能跃升的关键基石。goldfish-zho-hans-100mb作为一项专注于简体中文的精细数据集,其出现恰逢大语言模型对海量、纯净文本需求激增的浪潮,为中文预训练模型的微调与评估提供了标准化的数据支撑。当前前沿研究方向聚焦于如何利用此类可控规模的语料库,结合少样本学习与指令微调技术,提升模型在中文理解、生成及跨任务泛化上的鲁棒性。该数据集不仅促进了中文NLP在通顺度与语义忠实度上的基准评价,更在应对语言模型的灾难性遗忘现象时,通过其精炼的领域内文本,为持续学习与知识注入策略的验证开辟了新路径,其影响深远,正加速推动中文NLP从研究走向成熟应用。
以上内容由遇见数据集搜集并总结生成


