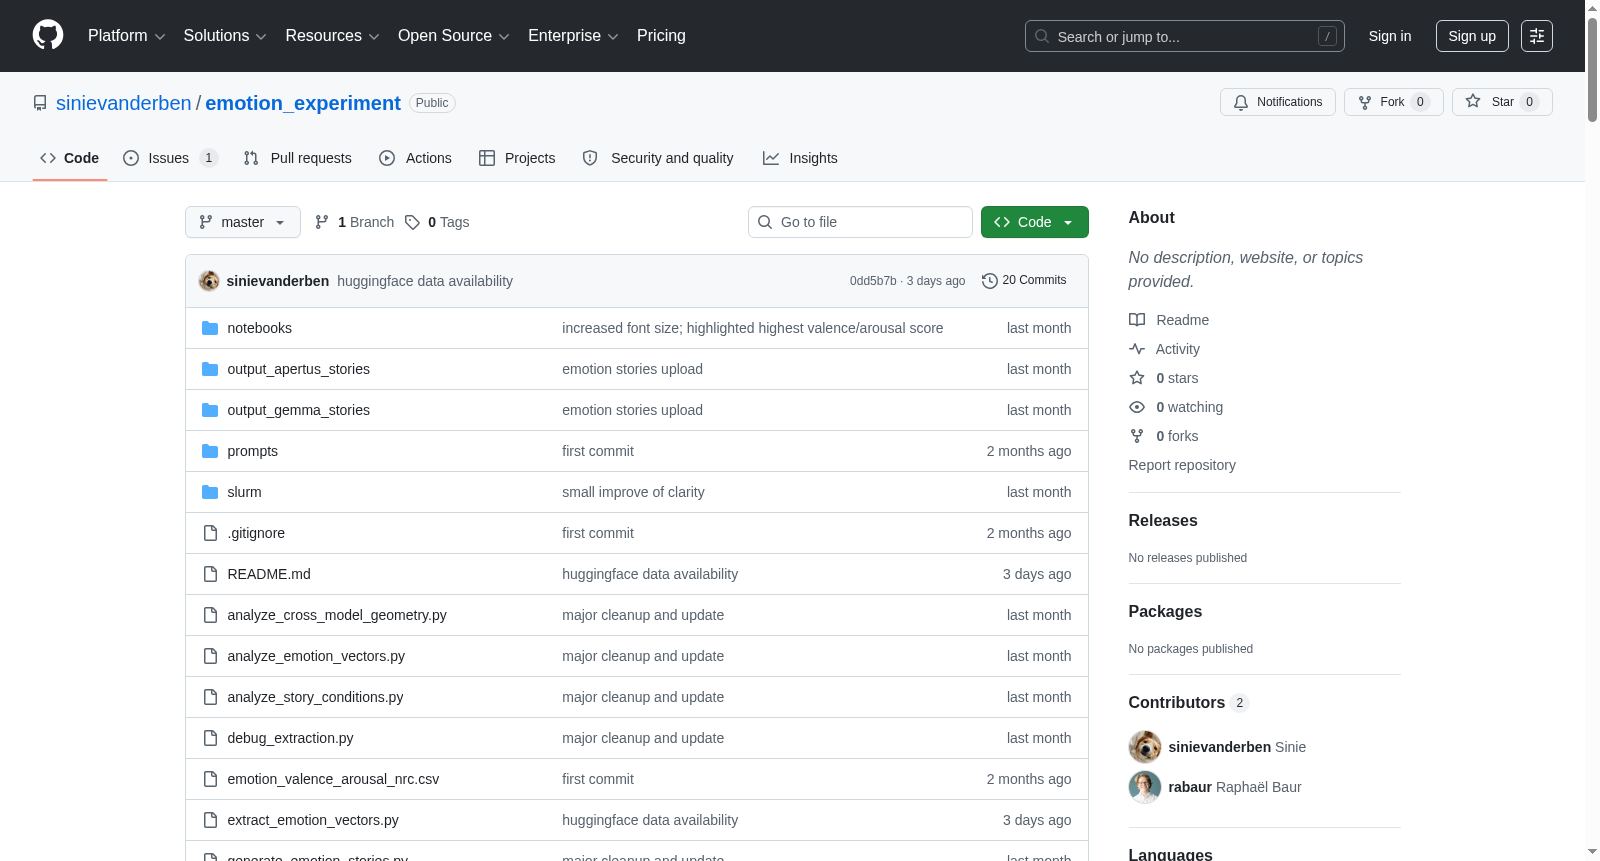
synthetic emotion-story datasets
收藏资源简介:
该数据集是由苏黎世联邦理工学院研究团队构建的合成情绪故事数据集,旨在探究开源大语言模型中的情绪向量表征。数据集包含1539个故事样本,覆盖171种不同情绪类别,每个情绪对应9个由APERTUS-8B和GEMMA-4-E4B模型生成的短篇叙事文本,并额外包含40个中性故事作为对照基准。数据生成过程采用标准化提示模板,要求模型创作角色体验目标情绪但不直接提及情绪名称的叙事内容,形成跨模型对比的实验语料。该数据集主要应用于计算语言学和人工智能可解释性研究领域,专门用于分析语言模型内部情绪表征的几何结构、跨层演化规律及其与人类心理学维度(效价-唤醒度)的对应关系。
This dataset is a synthetic emotional story dataset constructed by a research team from ETH Zurich, aimed at exploring emotional vector representations in open-source large language models (LLMs). The dataset contains 1539 story samples covering 171 distinct emotion categories. For each emotion category, there are 9 short narrative texts generated by the APERTUS-8B and GEMMA-4-E4B models, with an additional 40 neutral stories serving as control benchmarks. The data generation process adopts standardized prompt templates, which require the models to create narrative content where characters experience the target emotion without directly mentioning the name of the emotion, thereby forming experimental corpora for cross-model comparison. This dataset is mainly applied in the fields of computational linguistics and AI interpretability research, and is specifically used to analyze the geometric structure of emotional representations within language models, the cross-layer evolution rules, and their correspondence with human psychological dimensions (valence-arousal).
数据集概述
本数据集是关于大型语言模型中情感向量研究的复现项目,主要针对两个开源模型(Apertus 8B 和 Gemma 4 E4B)的残差流进行情感向量提取与分析。
核心内容
- 研究目标:复现 Anthropic 的情感向量工作,生成情感标注故事,提取模型隐藏状态下的情感向量,并分析其几何结构。
- 模型与数据规模:
Apertus 8B:包含 513 个提示、1,539 个故事。Gemma 4 E4B:包含 513 个提示、1,539 个故事。- 每个数据集结构为:171 种情感 × 3 个主题 × 3 个故事。
数据来源与格式
- 数据发布平台:Hugging Face Hub。
- 数据集链接:
- Apertus 8B 故事数据集:
snae/emotion_stories_Apertus_8B_Instruct - Gemma 4 E4B 故事数据集:
snae/emotion_stories_gemma_4_4B
- Apertus 8B 故事数据集:
加载方式
使用 datasets 库即可加载:
python from datasets import load_dataset
ds = load_dataset("snae/emotion_stories_Apertus_8B_Instruct") row = ds["train"][0] print(row["emotion"], "—", row["topic"]) for story in row["stories"]: # 3 stories per row print(story[:80], "...")
数据属性
- 每条记录包含:情感标签(emotion)、主题(topic)、三个故事(stories)。
- 使用场景:可直接跳过本地故事生成步骤,直接从 Hugging Face Hub 加载数据集,用于后续的情感向量提取与分析。
相关工具与流程
该数据集是完整流水线中的一环,整个流程包括:
- 生成情感故事(可跳过,直接使用发布的数据集)
- 提取情感向量(支持从 Hugging Face 加载故事)
- 分析情感向量(PCA、UMAP、CKA 分析)
- 跨模型几何比较
引用与归属
该项目是对 Anthropic 情感向量研究的复现,原始论文:
Sofroniew, Kauvar, Saunders, Chen & et all. (2026). Emotion Concepts and their Function in a Large Language Model.
https://transformer-circuits.pub/2026/emotions/index.html