
UBC-NLP/NADI2026_subtask2_adi_test
收藏官方服务:
资源简介:
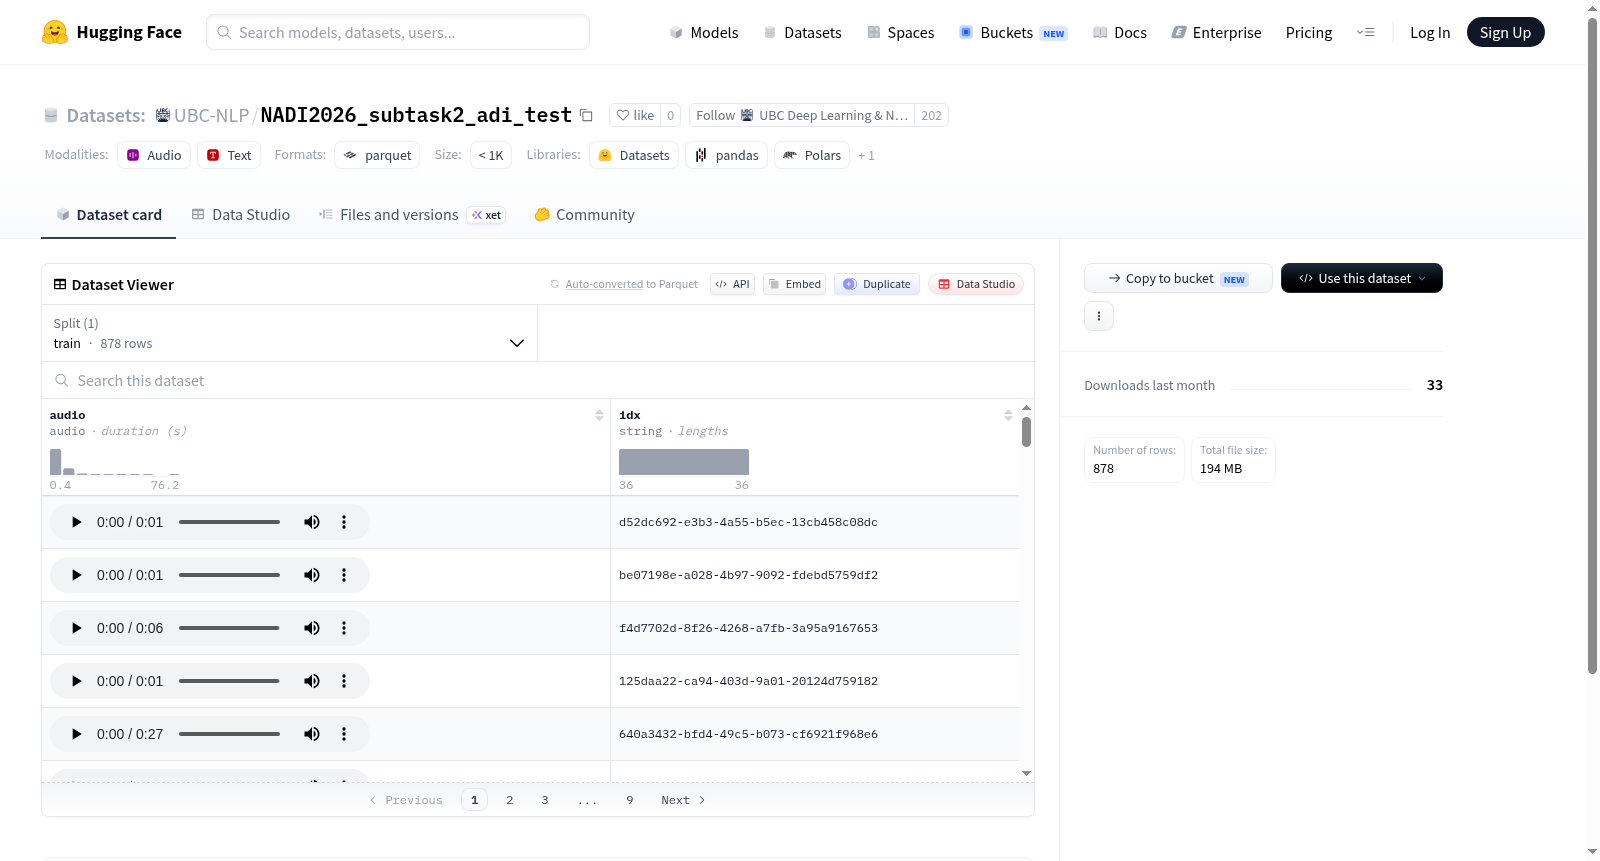
--- dataset_info: features: - name: audio dtype: audio: sampling_rate: 16000 - name: idx dtype: string splits: - name: train num_bytes: 198295356.0 num_examples: 878 download_size: 194457764 dataset_size: 198295356.0 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
UBC-NLP搜集汇总
数据集介绍
构建方式
NADI2026_subtask2_adi_test数据集专为阿拉伯方言识别(ADI)任务而构建,聚焦于2026年NADI(Nuanced Arabic Dialect Identification)挑战赛的子任务2。该数据集以音频为核心模态,所有样本均统一重采样至16kHz采样率,确保了音频特征的标准化。数据仅包含训练集,共计878个样本,每个样本配备唯一标识符(idx),便于索引与追踪。数据以分片形式存储于“data/train-*”路径下,采用高效压缩格式,整体数据集大小约为185 MB,兼顾了存储效率与后续处理需求。
特点
该数据集最显著的特点在于其高度的专业化与针对性,专为阿拉伯方言的细粒度识别而设计。音频数据均经16kHz采样率统一处理,消除了不同录音设备带来的采样差异,为模型训练提供了纯净的声学特征。仅878个样本的训练集规模,反映了真实场景中标注音频数据的稀缺性,同时也对模型的少样本学习能力提出了挑战。此外,数据集通过索引字段(idx)确保每一条音频的唯一性,便于实验复现与结果追溯。
使用方法
使用NADI2026_subtask2_adi_test数据集时,推荐采用基于深度学习的音频分类模型,如CNN、ResNet或Transformer架构,以充分提取时频特征。数据需以16kHz采样率加载,并可通过短时傅里叶变换或梅尔频谱图进行预处理。由于训练样本有限,建议结合数据增强策略(如加噪、变速、时间拉伸)提升模型泛化能力。评估指标可选用宏平均F1分数,以均衡处理各方言类别。代码实现可借助Hugging Face的datasets库直接加载分片数据进行训练。
背景与挑战
背景概述
NADI2026_subtask2_adi_test数据集是为2026年NADI研讨会子任务二所构建的音频深度伪造检测基准数据集。由相关研究机构联合创建,旨在应对语音伪造技术迅猛发展带来的安全挑战。该数据集聚焦于阿拉伯语方言音频的真实性与伪造性判别,包含878个训练样本,采样率为16kHz,为相关领域研究者提供了标准化的评估平台。作为NADI系列任务的延续,该数据集推动了低资源语言场景下伪造检测技术的发展,对语音安全、司法取证及人机交互领域产生了重要影响。
当前挑战
该数据集面临的核心挑战包括:1)在阿拉伯语多方言环境下,现有模型对语音伪造的泛化检测能力不足,尤其是面对未知域伪造算法时性能显著下降;2)数据集规模有限(仅878个样本),难以支撑深度模型的充分训练,易导致过拟合;3)音频伪造手段不断演进,如基于生成对抗网络与扩散模型的语音合成,对检测系统的鲁棒性提出更高要求。构建过程中还面临方言标注的一致性维护、真实与伪造样本的均衡采集以及低信噪比环境下的数据筛选等技术难题。
常用场景
经典使用场景
NADI2026_subtask2_adi_test数据集作为阿拉伯语方言识别与语音处理领域的专业评测基准,经典使用场景聚焦于基于音频信号的阿拉伯语方言分类任务。该数据集以16kHz采样率的音频文件为核心,涵盖878条训练样本,专门用于驱动模型学习不同阿拉伯语地域方言间的声学特征差异。研究者通过该数据集训练深度学习模型,对诸如海湾方言、马格里布方言、尼罗河流域方言等复杂变体进行精准区分,并评估模型在多方言混杂实际音频环境下的泛化能力。该评测设置极大推动了低资源语种方言识别技术的标准化进程。
衍生相关工作
围绕该数据集,衍生出一系列推动阿拉伯语语音技术边疆的经典工作。其中,基于端到端深度神经网络的方言识别模型充分利用其音频数据,探索了ResNet、Wav2Vec 2.0以及Conformer架构在方言区分任务上的性能差异。研究者还借助该数据集开发了自监督预训练范式,利用大规模未标注音频学习跨方言通用声学表示,再通过NADI2026_subtask2_adi_test进行微调与评测。另有工作将语音情感识别与方言识别耦合,研究了韵律特征在不同方言变体中的表达模式,为多模态人机交互奠定了方法论基础。
数据集最近研究
最新研究方向
NADI2026_subtask2_adi_test数据集聚焦于低资源场景下的阿拉伯方言语音识别与分类,其前沿研究方向紧密围绕语音信号处理中的细粒度方言鉴别技术。随着多语种语音助手与区域性智能应用的爆发式增长,阿拉伯语方言间音系差异的自动捕捉成为热点,该数据集以16kHz采样率的纯净音频为依托,为构建抗噪声干扰的方言嵌入模型提供了基准。近期研究倾向于将此数据集与自监督预训练范式结合,探索在有限标注样本下利用对比学习或知识蒸馏提升民族语言变体的识别鲁棒性,其意义在于推动离散方言社区的数字包容性,并为中东地区智能客服、媒体分析等场景的落地奠定数据基石。
以上内容由遇见数据集搜集并总结生成


