
BigOBench
收藏官方服务:
资源简介:
BigO(Bench)是一个包含约300个Python代码问题和3,105个编程竞赛问题及其1,190,250个解决方案的数据集,用于评估大型语言模型是否能找到满足时间-空间复杂度要求的代码解决方案或生成这样的代码。数据集还包括一个复杂度推断框架,能够对任何Python代码片段进行运行时间和内存占用测量,并推断其算法的时间-空间复杂度。
BigO(Bench) is a dataset comprising approximately 300 Python coding problems, 3,105 programming contest problems, and 1,190,250 corresponding code solutions. It is developed to evaluate whether large language models (LLMs) can either find or generate code solutions that satisfy time-space complexity requirements. Furthermore, the dataset includes a complexity inference framework capable of measuring the runtime and memory footprint of any Python code snippet, as well as inferring the time-space complexity of the algorithms implemented in the snippet.
提供机构:
AI at Meta创建时间:
2025-03-15
搜集汇总
数据集介绍
构建方式
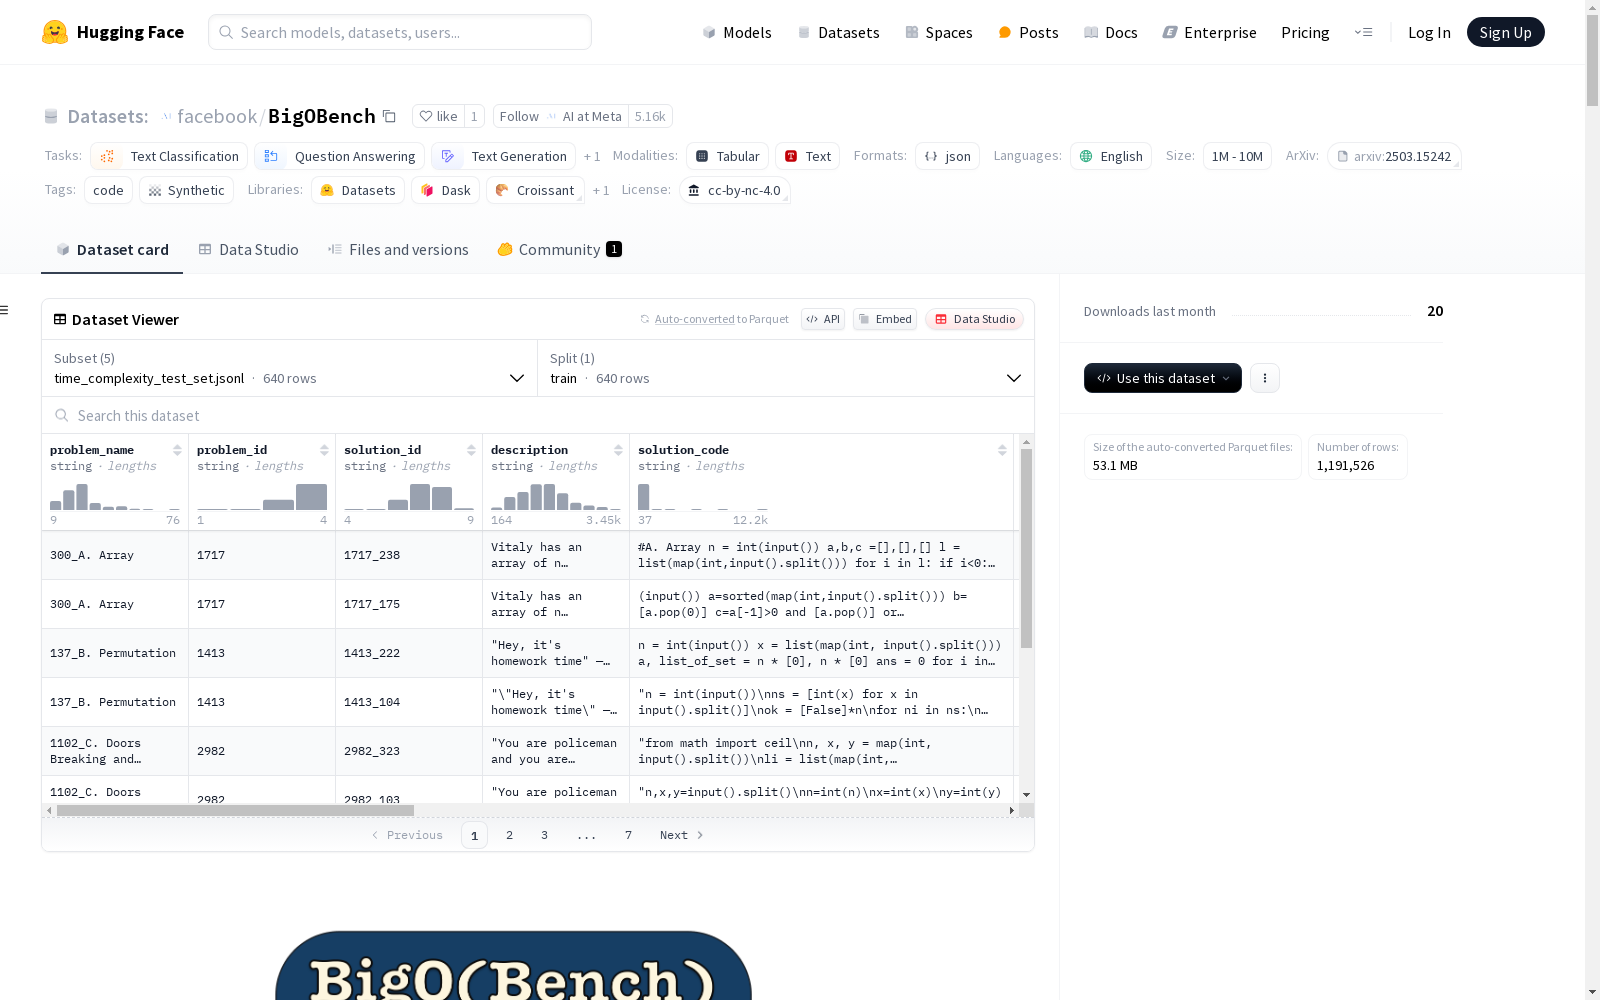
BigO(Bench)数据集的构建基于约300个Python编程问题及其解决方案,涵盖了3,105个编程问题和1,190,250个训练解决方案。该数据集通过一个复杂度推断框架,能够运行任何Python代码片段,测量多个运行时和内存占用值,并推断其算法的时间和空间复杂度。此外,数据集还包含从Code Contests中提取的3,105个编程问题和1,190,250个解决方案,这些解决方案被标注了推断出的时间和空间复杂度标签,并附有大量输入规模对应的运行时和内存占用值。
特点
BigO(Bench)数据集的特点在于其专注于评估大语言模型在理解和生成受计算复杂度约束的代码方面的能力。数据集不仅提供了丰富的编程问题和解决方案,还通过复杂度推断框架生成了详细的复杂度标签和性能测量数据。这些数据为研究模型在处理时间和空间复杂度方面的表现提供了坚实的基础。此外,数据集还包含了多种测试集,如时间复杂度和空间复杂度测试集,这些测试集经过精心筛选,覆盖了多种复杂度类别,确保了评估的全面性和准确性。
使用方法
BigO(Bench)数据集可通过HuggingFace平台直接下载,或使用CLI工具进行下载。用户还可以通过Python脚本加载数据集,选择特定的子数据集进行使用。数据集包含五个主要文件,分别提供了编程问题的基本信息、复杂度标签的轻量级和完整输出、以及时间和空间复杂度测试集。用户可以根据研究需求选择相应的文件,利用这些数据进行模型训练、评估和复杂度分析。
背景与挑战
背景概述
BigOBench数据集由Facebook Research于2025年推出,旨在评估大型语言模型(LLMs)在生成或理解代码时,是否能够满足特定的时间和空间复杂度要求。该数据集包含约300个Python编程问题,以及3,105个编程问题和1,190,250个训练解决方案,涵盖了从简单到复杂的多种算法复杂度类别。BigOBench的推出填补了当前评估体系中对模型在计算复杂度理解与生成能力上的空白,为研究者和开发者提供了一个全新的基准测试工具。
当前挑战
BigOBench数据集面临的主要挑战包括:1) 如何准确评估模型在生成代码时的时间和空间复杂度控制能力,这需要对算法的复杂度进行精确测量和推断;2) 在构建数据集过程中,如何确保代码问题的多样性和复杂性,以覆盖广泛的算法类别和复杂度级别;3) 如何有效地标注和验证大量代码解决方案的复杂度,确保数据集的准确性和可靠性。这些挑战不仅涉及技术层面的复杂性,还要求对算法和编程语言有深入的理解。
常用场景
经典使用场景
BigOBench数据集在评估大型语言模型(LLMs)生成代码时的时间与空间复杂度控制能力方面具有重要应用。通过提供约300个Python代码问题及其解决方案,该数据集能够帮助研究人员测试模型在生成符合特定复杂度要求的代码时的表现。其复杂度推断框架能够运行任何Python代码片段,测量多个运行时和内存占用值,并推断其算法的时间与空间复杂度。
实际应用
在实际应用中,BigOBench数据集可用于优化代码生成工具和自动化编程助手。通过评估模型在生成符合特定复杂度要求的代码时的表现,开发者可以改进这些工具,使其在实际编程任务中更加高效和可靠。此外,该数据集还可用于教育和培训,帮助学生和开发者更好地理解算法复杂度及其在实际编程中的应用。
衍生相关工作
BigOBench数据集已经衍生出多项相关研究,特别是在代码生成和复杂度分析领域。例如,基于该数据集的研究工作探讨了如何利用大型语言模型生成符合特定复杂度要求的代码,并提出了新的评估方法和框架。这些研究不仅推动了代码生成技术的发展,还为算法复杂度分析提供了新的工具和方法。
以上内容由遇见数据集搜集并总结生成


