
exact_2026_model1_fol_translator
收藏官方服务:
资源简介:
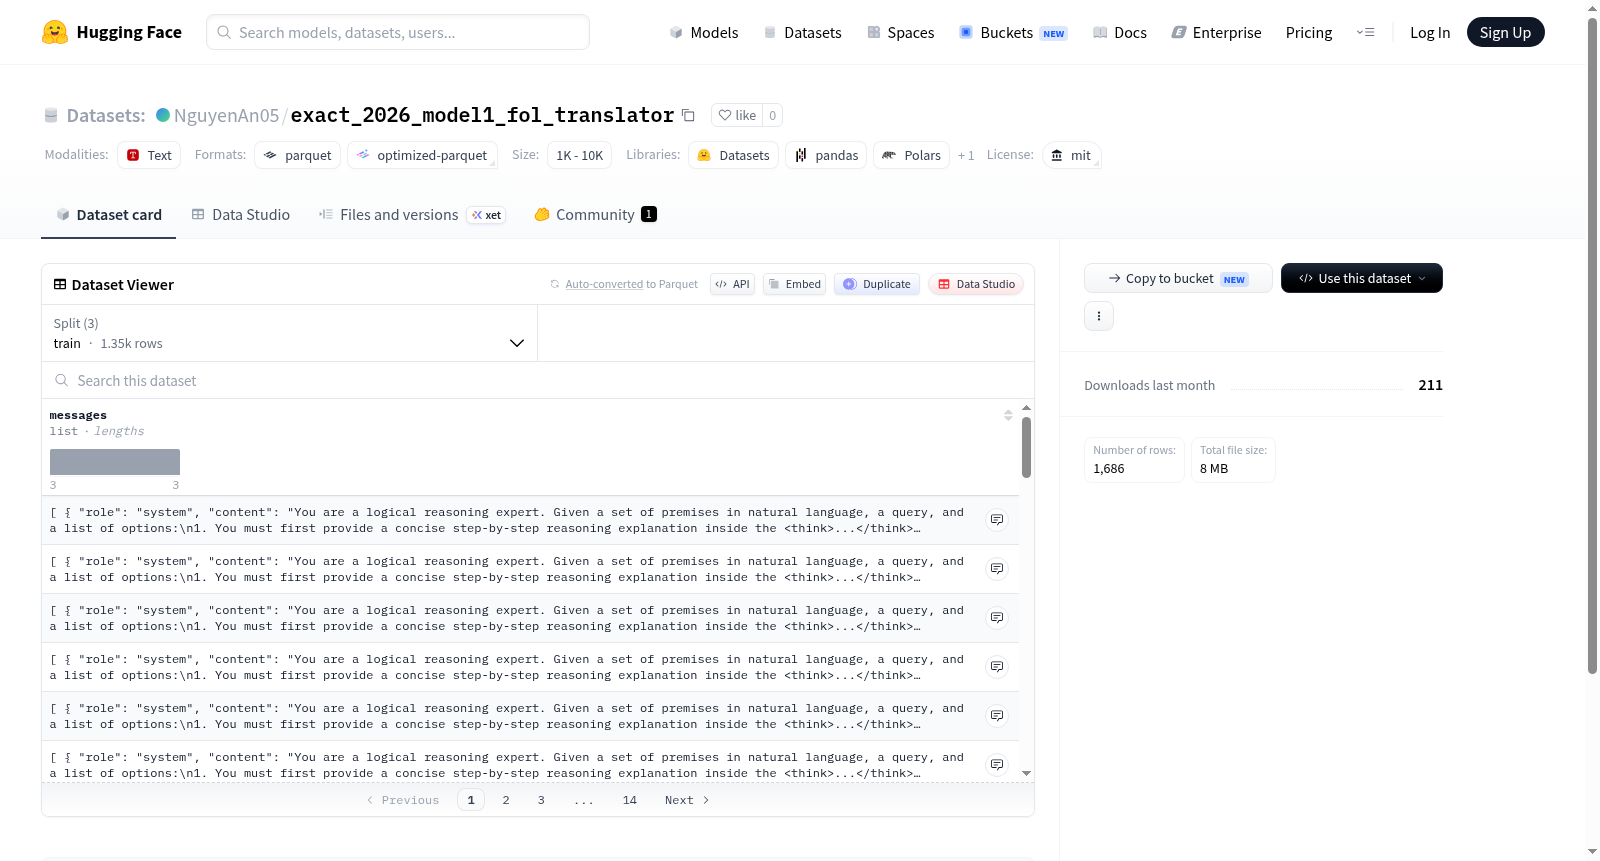
该数据集是一个对话格式的数据集,包含1686个样本,划分为训练集(1348条)、验证集(168条)和测试集(170条)。每个样本由消息列表构成,每条消息包含两个字段:role(表示发言者角色,如用户或助手)和content(表示消息的文本内容)。数据集以文本形式存储,适用于对话系统训练、聊天模型微调等自然语言处理任务。
This dataset is a dialogue-format dataset containing 1686 samples, divided into a training set (1348 entries), a validation set (168 entries), and a test set (170 entries). Each sample consists of a list of messages, with each message containing two fields: role (indicating the speakers role, such as user or assistant) and content (representing the text content of the message). The dataset is stored in text format and is suitable for natural language processing tasks such as dialogue system training and chat model fine-tuning.
创建时间:
2026-06-02
原始信息汇总
- 数据集名称:NguyenAn05/exact_2026_model1_fol_translator
- 许可证:MIT
- 数据集大小:下载大小约为 7.995 MB,数据集总大小约为 7.94 MB
- 特征:
messages:包含role(字符串)和content(字符串)字段
- 数据划分:
- 训练集:1348 个样本,6342875 字节
- 验证集:168 个样本,780183 字节
- 测试集:170 个样本,816878 字节
- 配置:
- default:包含训练集(data/train-)、验证集(data/validation-)和测试集(data/test-*)
搜集汇总
数据集介绍
构建方式
该数据集名为exact_2026_model1_fol_translator,是一个面向自然语言到一阶逻辑(First-Order Logic, FOL)翻译任务的高质量指令微调数据集。其构建基于精心设计的对话结构,每条数据以'messages'字段存储,包含'role'和'content'两个属性,分别用于标识对话角色(如用户或助手)及对应的文本内容。数据集被划分为训练集、验证集和测试集,样本数量分别为1348、168和170条,呈现出典型的少样本学习规模,适用于模型精调与评估。其MIT开源许可进一步降低了学术与工业应用门槛,鼓励研究者在逻辑推理与形式语义领域展开广泛探索。
特点
该数据集的核心特色在于其聚焦于数理逻辑中的一阶逻辑翻译任务,填补了自然语言处理与形式语义生成之间的鸿沟。每条样本以多轮对话形式呈现,模拟了用户提出自然语言描述、模型输出相应FOL公式的交互场景,体现了从非结构化语言到结构化逻辑表达的映射能力。数据集规模虽小但高度专业化,训练集与测试集比例约为8:1,设计上兼顾了模型训练的效率与泛化性能的验证需求。这种精炼的标注结构使其成为评估语言模型在逻辑推理任务中表现的重要基准。
使用方法
使用该数据集时,建议基于HuggingFace的datasets库进行加载,通过指定config_name为'default',并利用split参数区分训练、验证与测试集。典型应用场景包括对预训练语言模型进行指令微调,以增强其对一阶逻辑翻译的理解与生成能力。用户可将'messages'中的对话序列转化为监督学习范式:以用户角色(role为'user')的content作为输入,助手角色(role为'assistant')的content作为目标输出。此外,该数据集还可作为评估工具,在逻辑推理基准测试中衡量模型的形式语义转化精确度。
背景与挑战
背景概述
在自然语言处理与形式推理交汇的领域,将非结构化文本转化为结构化逻辑表达式是推动机器理解与推理能力的关键。exact_2026_model1_fol_translator数据集由相关研究机构于2026年创建,核心研究问题聚焦于如何高效且准确地实现从自然语言到一阶逻辑(FOL)的自动翻译。该数据集包含1348个训练样本、168个验证样本和170个测试样本,数据格式以消息对的形式呈现,旨在为机器翻译模型提供高质量的监督信号。通过填补自然语言表达与形式化逻辑表示之间的鸿沟,该数据集对知识库构建、语义解析及自动化推理等领域具有重要的推动作用。
当前挑战
该数据集面临的核心挑战在于所解决的领域问题:自然语言到一阶逻辑的翻译任务本身具有高度歧义性和结构性复杂性,自然语言中隐含的量化、模态和上下文依赖关系难以被模型精确捕捉。此外,构建过程中面临数据规模限制(总计仅1686条样本),且需要确保每条样本中角色(role)与内容(content)严格对应于源语言与目标逻辑表达式,人工标注的一致性和准确性成为重大瓶颈。同时,不同领域文本的逻辑转换需求差异显著,模型泛化能力受到严峻考验,如何在有限训练数据下实现鲁棒的语义理解与形式化生成,是当前研究亟需突破的难点。
常用场景
经典使用场景
在自然语言处理与形式逻辑交叉融合的前沿领域,exact_2026_model1_fol_translator数据集以其独特的‘句子到一阶逻辑’翻译任务,成为连接人类自然语言表达与机器可理解的形式化推理的桥梁。该数据集通过精心构建的对话式消息结构——每条数据包含role与content字段,模拟了从自然语言陈述到一阶逻辑公式的转换过程,为训练能够理解语义结构并生成逻辑表达的神经翻译模型提供了高质量的监督学习样本。研究者和工程师们通常利用这一数据集来微调预训练语言模型,使其掌握将诸如‘每个学生都读过一本书’这样的自然语句转化为∀x(Student(x)→∃y(Book(y)∧Read(x,y)))等价逻辑形式的复杂能力。
实际应用
在实际应用层面,该数据集所训练的模型能够为知识图谱的自动构建提供逻辑形式的注入,例如从海量科技文献中抽取出可查询、可推理的结构化知识。在智能问答系统中,它赋能机器将用户非形式化的问题实时翻译为一阶逻辑查询,从而在形式化知识库中执行精确的推理与检索,显著提升对话系统的准确性与可解释性。此外,在法律合同审查、医学诊断辅助等高风险领域,自然语言到逻辑形式的自动转换使得系统能够对文本进行自动化的形式验证,识别逻辑矛盾或漏洞,从而帮助专业人士做出更可靠的决策。这些应用场景无一不体现出语言形式化在提升AI系统安全性、可控性方面的革命性价值。
衍生相关工作
基于exact_2026_model1_fol_translator这一数据基准,衍生了一系列富有影响力的研究工作。一方面,该数据集被用作评估各种新颖神经架构在语义解析任务上的试金石,催生了诸如融合注意力增强的变换器模型以及结合符号推理与连接主义学习的混合方法。另一方面,受其启发,研究者开始探索跨语言和跨逻辑体系的形式翻译任务,构建了如多语言一阶逻辑翻译、或扩展至高阶逻辑表达的新数据集与评测基准。此外,一些经典工作还利用该数据集训练了能够自修正翻译错误的迭代解码模型,或引入强化学习来优化逻辑形式的生成策略,这些前沿探索共同推动着可解释人工智能与形式化验证技术的边界不断向前延伸。
以上内容由遇见数据集搜集并总结生成


