
遇见数据集

HiTZ/ALIA_syntethic_MT_V2

收藏
Hugging Face2026-06-26 更新2026-07-22 收录
官方服务:

资源简介:

ALIA Synthetic MT V2 是一个平行语料库,源自 Berria 新闻文章以及法律/行政领域的 BOPV 和 Parlamento 内容,包含2025年发布的内容和2023年的存档材料。该数据集提供了使用两种不同的大型语言模型(Qwen3.5-27B 和 LatxaQ)生成的英语和西班牙语合成翻译。数据集分为三个子集:Berria(新闻)、BOPV(巴斯克官方公报)和 Parliament(议会),每个子集包含原始巴斯克语文本、合成翻译文本以及相关元数据,如唯一标识符和相似度分数。数据集旨在用于机器翻译模型的训练和评估、合成数据实验以及多语言自然语言处理研究。

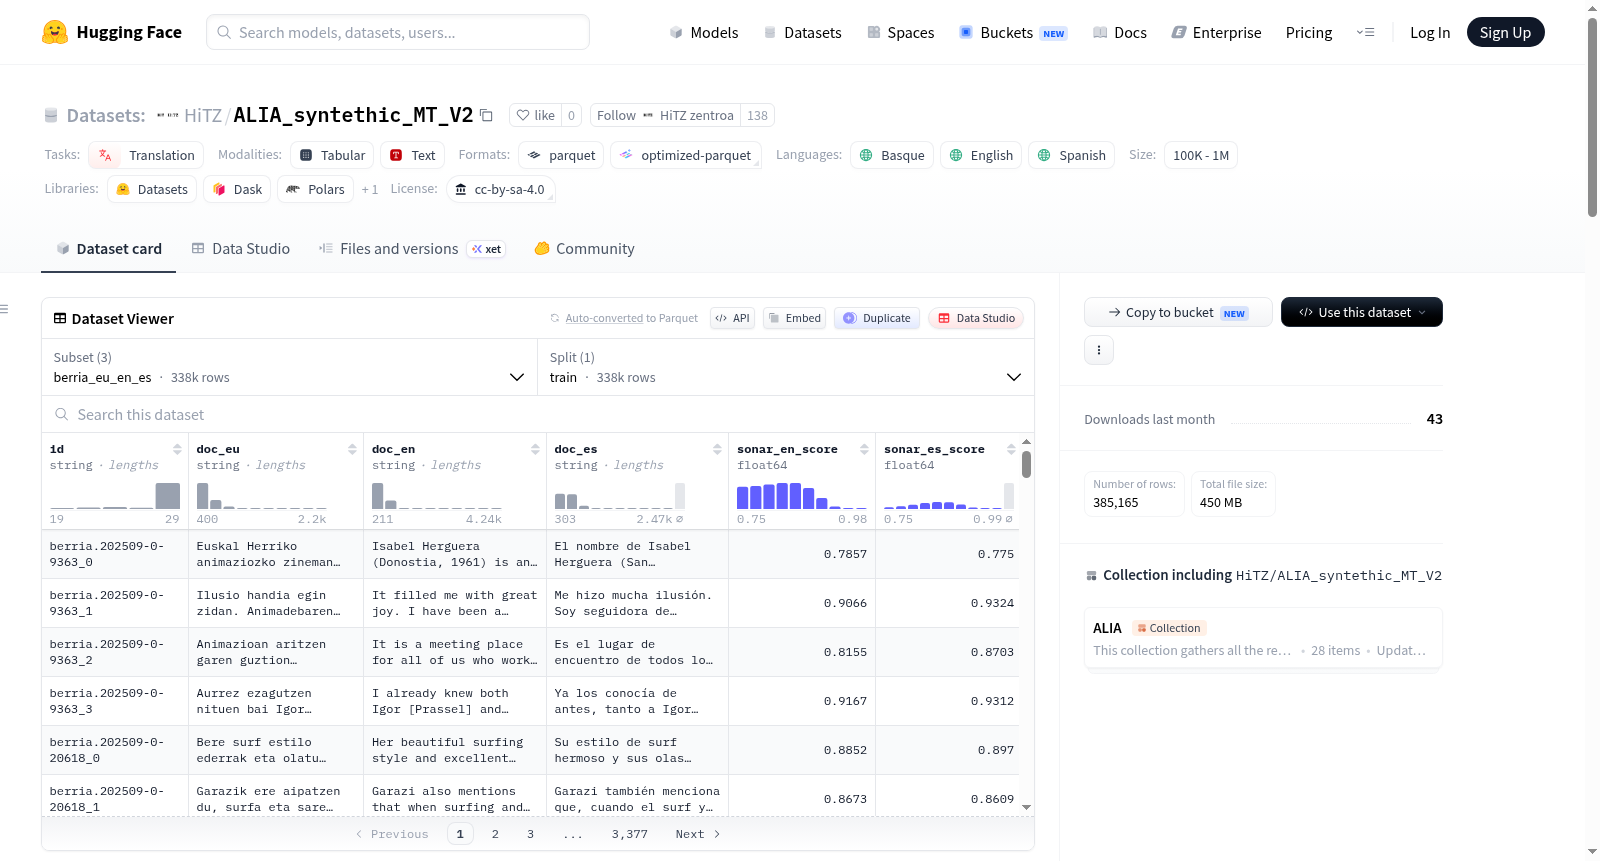
ALIA Synthetic MT V2 is a parallel corpus derived from Berria news articles and legal/administrative domains BOPV and Parlamento, comprising content published in 2025 as well as archived material from 2023. The dataset provides synthetic translations into English and Spanish, generated using two distinct Large Language Models: Qwen3.5-27B and LatxaQ. It includes three subsets: Berria (news), BOPV (official bulletin), and Parliament (parliamentary content), each with original Basque text, synthetic translations, and metadata such as unique identifiers and similarity scores. The dataset is intended for training and evaluation of machine translation models, synthetic data experiments, and multilingual NLP research.
提供机构:
HiTZ
搜集汇总
数据集介绍
HiTZ/ALIA_syntethic_MT_V2 数据集图片
构建方式
ALIA_syntethic_MT_V2 数据集是一个面向巴斯克语(Euskera)、英语和西班牙语三语平行语料库,其构建汇聚了来自新闻领域(Berria)与法律行政领域(BOPV、Parlamento)的多源文本。数据涵盖2023年至2025年间的原创内容,并借助两大先进大语言模型完成合成翻译:Qwen3.5-27B用于法律领域翻译,而LatxaQ-VL(基于Qwen3-32B领域适配)则应用于新闻领域。为确保翻译质量,所有译文均经过最低相似度阈值为0.75的Sonar评分筛选,失败案例被剔除并标记为空值。文本以JSONL格式存储,其中新闻数据通过顺序ID关联同一文章的连续段落,便于上下文重构。
特点
该数据集兼具规模与多样性,新闻子集包含337,650条巴斯克-西班牙语平行句对,其中193,337条附带英语翻译;法律行政子集则分别贡献了27,130条(BOPV)与20,385条(Parlamento)高质量语料。其独特之处在于引入LatxaQ模型,该模型保留了Latxa家族对巴斯克语言文化的深刻理解,同时融合Qwen架构的多语言优势,生成的译文更贴近本土语境。此外,数据集中保留了Sonar相似度原始得分,为用户提供灵活的过滤选项,便于根据任务需求调整质量门槛。每条数据还包含丰富的元数据字段,如新闻来源ID、法律文档的唯一标识符及词数统计,方便用户进行细粒度分析与筛选。
使用方法
本数据集专为机器翻译模型的训练与评估而设计,亦适用于合成数据实验及多语言自然语言处理研究。用户可通过Hugging Face Datasets库直接加载各子集(如'berria_eu_en_es'、'bopv_eu_en_es'、'parliament_eu_en_es'),并根据任务需求选择对应的源语言与目标语言字段。对于新闻数据,可利用'doc_eu'、'doc_en'与'doc_es'字段构建三语模型,或仅使用巴斯克-西班牙语对;法律数据则关注'eu_text'与'es_text'的源文本对及'translation'字段的英语合成译文。建议在训练前依据Sonar评分字段对低分样本进行过滤,以提升模型鲁棒性。需注意,合成翻译可能带有模型特定痕迹,研究结果应审慎解读。
背景与挑战
背景概述
ALIA_synthetic_MT_V2数据集由ALIA与HiTZ研究团队创建,发表于2025年,聚焦于巴斯克语(Euskera)的多语言机器翻译研究。该数据集的核心研究问题在于为低资源语言巴斯克语构建高质量的平行语料,涵盖新闻与法律行政两大领域,分别源自Berria新闻网站及巴斯克官方公报(BOPV)与议会记录(Parlamento)。通过利用Qwen3.5-27B与LatxaQ两种大语言模型生成到英语和西班牙语的合成翻译,该数据集不仅丰富了巴斯克语的翻译资源,还为多语言自然语言处理领域提供了宝贵的训练与评估数据。其在机器翻译模型训练与多语言NLP研究中的应用,有力推动了低资源语言的技术发展,成为相关领域的重要基准。
当前挑战
该数据集所解决的领域问题在于:低资源语言巴斯克语缺乏大规模、高质量的平行语料,严重制约了机器翻译模型的性能。ALIA_synthetic_MT_V2通过合成翻译生成技术,为其构建了多领域、双目标语言的平行数据,填补了这一空白。然而,数据集构建过程面临多重挑战:首先,合成翻译可能引入模型特有的伪影(artifacts),影响翻译质量与自然度;其次,确保跨语言对齐的准确性需依赖Sonar相似度分数(≥0.75)进行严格过滤,但部分文本在西班牙语翻译中因质量不合格而被剔除,导致数据稀疏;最后,不同领域(新闻vs.法律)的文本风格与术语差异要求翻译模型具备高度领域适应性,增加了生成一致语言的难度。
常用场景
经典使用场景
ALIA_synthetic_MT_V2 数据集的核心经典用途在于构建和评估巴斯克语、英语及西班牙语之间的机器翻译系统。该数据集以《Berria》新闻文章及BOPV与Parlamento法律行政文本为语料基底,通过Qwen3.5-27B与LatxaQ-VL两类大型语言模型生成的合成翻译,构建了高质量三语平行语料库。研究者常利用其新闻与法律领域的双语及三语对齐数据,训练神经机器翻译模型,尤其针对低资源语言巴斯克语的跨语言迁移学习。此外,数据集中提供的Sonar语义相似度评分,支持对合成翻译质量进行精细化筛选与评估,使得该数据集在鲁棒性翻译模型训练与翻译质量自动评估领域同样展现出不可替代的学术价值。
衍生相关工作
围绕ALIA_synthetic_MT_V2数据集,已衍生出一系列具有深远影响的经典学术工作。首先,基于该数据集揭示了合成数据应用于低资源翻译的可行性,催生了大量关于预训练语言模型作为翻译器质量评估基准的研究,尤其是Qwen与LatxaQ模型架构在跨语言生成任务中的表现差异分析。其次,数据集中提供的Sonar语义评分机制,启发了学者构建更具区分度的翻译质量自动评估指标,推动了基于语义相似度的合成数据过滤方法的发展。此外,在领域自适应翻译方面,该数据集的Berria新闻与BOPV法律行政两个子集,被广泛用于研究跨领域迁移学习策略,特别是在保留领域术语准确性与文体特征的同时提升翻译流利度。这些衍生工作不仅丰富了低资源机器翻译的理论框架,也为后续大规模合成语料库的构建范式树立了标杆。
数据集最近研究
最新研究方向
ALIA_syntethic_MT_V2数据集聚焦于低资源语言(巴斯克语)与高资源语言(英语、西班牙语)之间的机器翻译前沿探索,尤其在利用大型语言模型(如Qwen3.5-27B与LatxaQ)生成合成平行语料方面。该数据集融合了新闻(Berria)与法律行政(BOPV、Parlamento)领域的最新语料(2023-2025年),旨在缓解巴斯克语在神经机器翻译中数据稀缺的瓶颈。其引入的SONAR相似度评分机制(阈值0.75)为合成数据的质量控制提供了可量化基准,推动了多语言NLP研究中合成数据与真实数据混合训练的策略创新。这一工作不仅服务于欧盟多语言政策下的语言平等目标,也为跨领域机器翻译模型的鲁棒性评估提供了高覆盖度的测试床。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

