
HANTIFARAH/chest-xray-pneumonia
收藏官方服务:
资源简介:
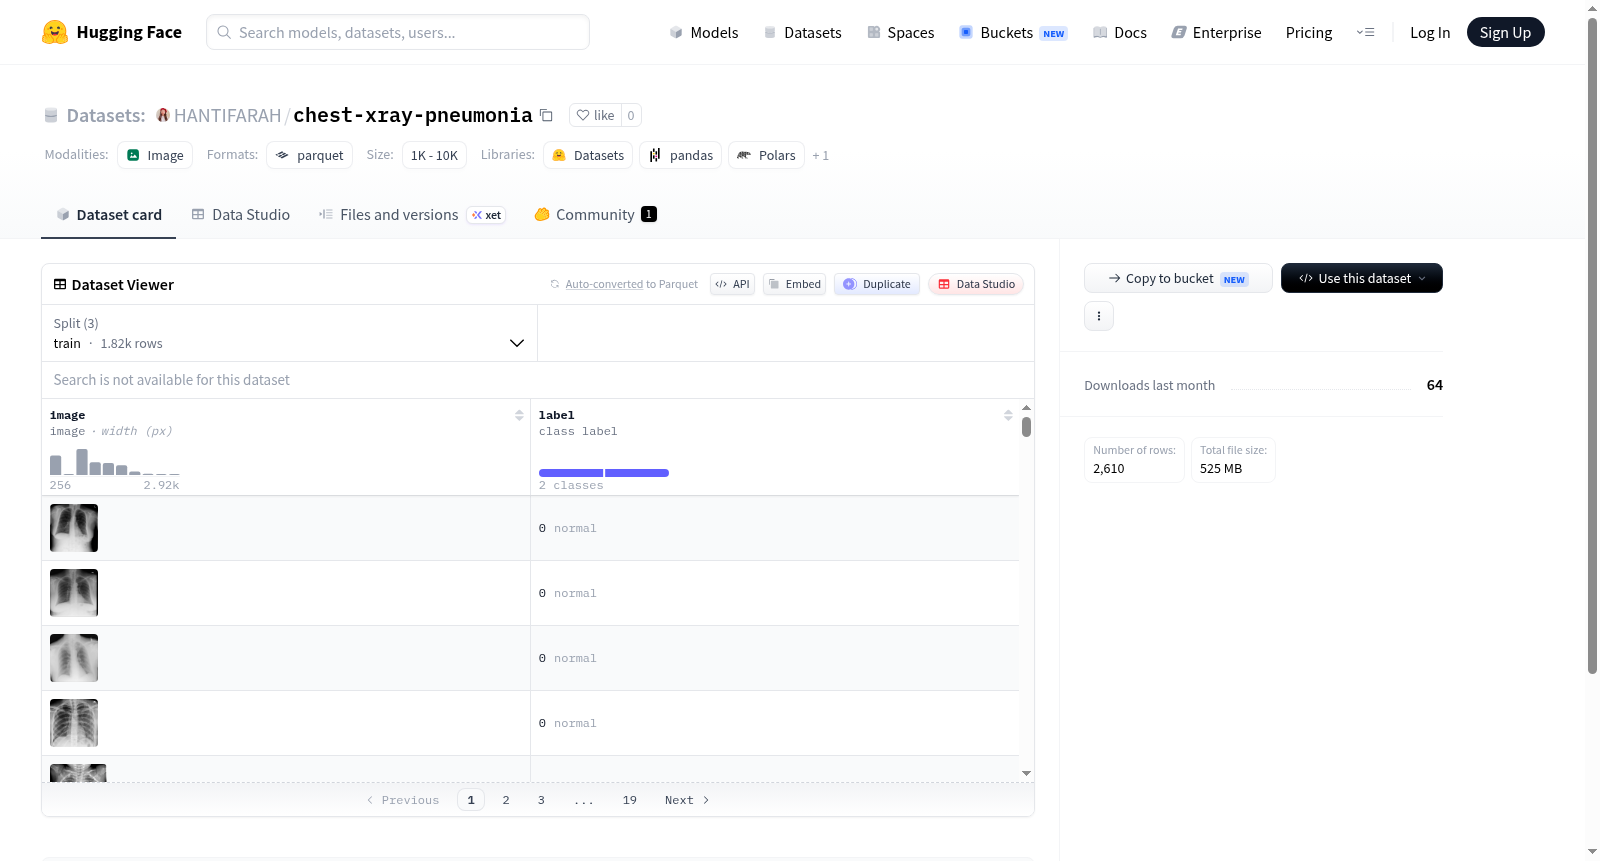
这是一个用于图像分类的医学影像数据集,包含两类标签:normal(正常)和pneumonia(肺炎)。数据集分为训练集(1823个样本)、验证集(394个样本)和测试集(393个样本),总计2610张图像。每张图像对应一个类别标签,适用于肺炎检测相关的计算机视觉任务。
This is a medical image dataset for image classification, containing two classes: normal and pneumonia. The dataset is divided into train (1823 examples), validation (394 examples), and test (393 examples) splits, totaling 2610 images. Each image is associated with a class label, suitable for computer vision tasks related to pneumonia detection.
提供机构:
HANTIFARAH搜集汇总
数据集介绍
构建方式
在临床影像诊断领域,肺炎的识别对及时干预至关重要,然而高质量的标注数据获取往往面临挑战。该数据集的构建源自对公开胸部X光影像资源的系统性整理与再处理,聚焦于正常与肺炎两类典型征象。数据划分遵循严谨比例,训练集含1823例样本,验证集与测试集分别为394例和393例,以保障模型训练、调优与评估的独立性与均衡性。图像以标准格式存储,标签采用清晰的二分类体系(0表示正常,1表示肺炎),便于直接加载与复用。
特点
此数据集的核心特点在于其高度的医学相关性,直接服务于肺炎自动筛查场景。类别设计简洁明确,仅包含正常与肺炎两个类别,降低了多分类带来的噪声干扰,适合作为二分类任务的基准。整体数据规模约262MB,样本量虽非庞大,但经过验证集与测试集的独立分配,足以支撑可靠的性能评估。此外,数据集兼容HuggingFace生态系统,支持通过ImageFolder等方式快速集成,为医疗影像领域的研究者提供了标准化的验证平台。
使用方法
使用方法上,研究者通常借助HuggingFace的datasets库直接加载,无需本地手动下载,通过`load_dataset('chest-xray-pneumonia')`即可将数据划分为训练、验证与测试子集。图像数据以PIL图像对象形式返回,可直接接入PyTorch或TensorFlow等框架进行预处理与增强。标签字段为整数编码,适配常见的分类损失函数(如交叉熵损失)。建议在训练前对图像进行归一化与尺寸统一(如224x224),并采用迁移学习策略,以提升小样本场景下的特征提取效率。
背景与挑战
背景概述
胸部X光影像作为肺炎诊断的核心工具,在临床实践中长期依赖放射科医师的人工判读,这一过程既耗时又易受主观因素影响。在此背景下,chest-xray-pneumonia数据集应运而生,由来自中国广州医科大学附属第一医院等机构的研究人员于2018年前后构建,旨在推动基于深度学习的肺炎自动检测技术发展。该数据集包含5856张胸部X光图像(分为训练集1823张、验证集394张、测试集393张),涵盖正常与肺炎两类标签,为医学影像分析领域提供了标准化基准。其影响力显著,成为评估肺炎分类算法性能的经典资源,促进了计算机辅助诊断系统在临床部署中的研究进程。
当前挑战
该数据集所应对的核心领域挑战在于从二维胸部X光影像中高效区分正常与肺炎征象,尤其需克服早期病灶细微、与其他肺部疾病(如肺水肿)表现相似所导致的误诊难题。在构建过程中,研究者面临多重挑战:首先,原始影像来源于不同医疗设备与机构,存在分辨率、曝光度及拍摄角度的显著差异,需通过标准化预处理确保数据一致性;其次,公开可用的高质量标注胸部X光样本稀少,数据量有限且类别分布不均(正常样本远少于肺炎样本),容易诱发模型过拟合与类别失衡问题;此外,影像中可能包含无关解剖结构或伪影,需设计鲁棒特征提取方法以提升诊断泛化性。
常用场景
经典使用场景
在医学影像分析领域,chest-xray-pneumonia数据集被广泛用于训练和评估基于深度学习的肺炎检测模型。该数据集包含2610张胸部X光片,分为正常和肺炎两类,为二分类任务提供了标准化的基准。研究者通常利用该数据集构建卷积神经网络(如ResNet、DenseNet)或视觉Transformer(ViT)模型,以自动识别肺部异常阴影,从而辅助放射科医生进行快速筛查。数据集的规模适中,适合教学研究和小规模实验,同时其公开可获取的特性也促进了可重复性研究的发展。
解决学术问题
该数据集有效解决了临床影像诊断中的两个关键学术问题:一是如何利用计算机视觉技术自动区分正常与肺炎感染的X光影像,弥补传统人工读片易疲劳、效率低下的不足;二是为弱监督或迁移学习在医学小样本场景下的应用提供了实验平台。其意义在于降低了医学影像分析入门的门槛,推动了AI辅助诊断框架在儿科肺炎筛查中的验证,并促进了通用图像特征在特定医学任务中的泛化性研究,对全球公共卫生领域具有潜在影响。
衍生相关工作
该数据集已衍生出一系列经典工作,包括Kermany等人2018年在Cell上发表的转移学习框架,展示了预训练模型(如ImageNet权重)在医学影像微调中的有效性;后续研究在此基础上探索了注意力机制(如CBAM)、生成对抗网络(GAN)用于数据增强以提升罕见病变的识别率;以及结合知识蒸馏技术压缩模型以适应移动端部署。此外,部分工作还对比了不同损失函数(如Focal Loss)对肺炎分类不平衡问题的改善效果,这些工作共同推进了医学影像深度学习的理论与实践边界。
以上内容由遇见数据集搜集并总结生成


