
遇见数据集

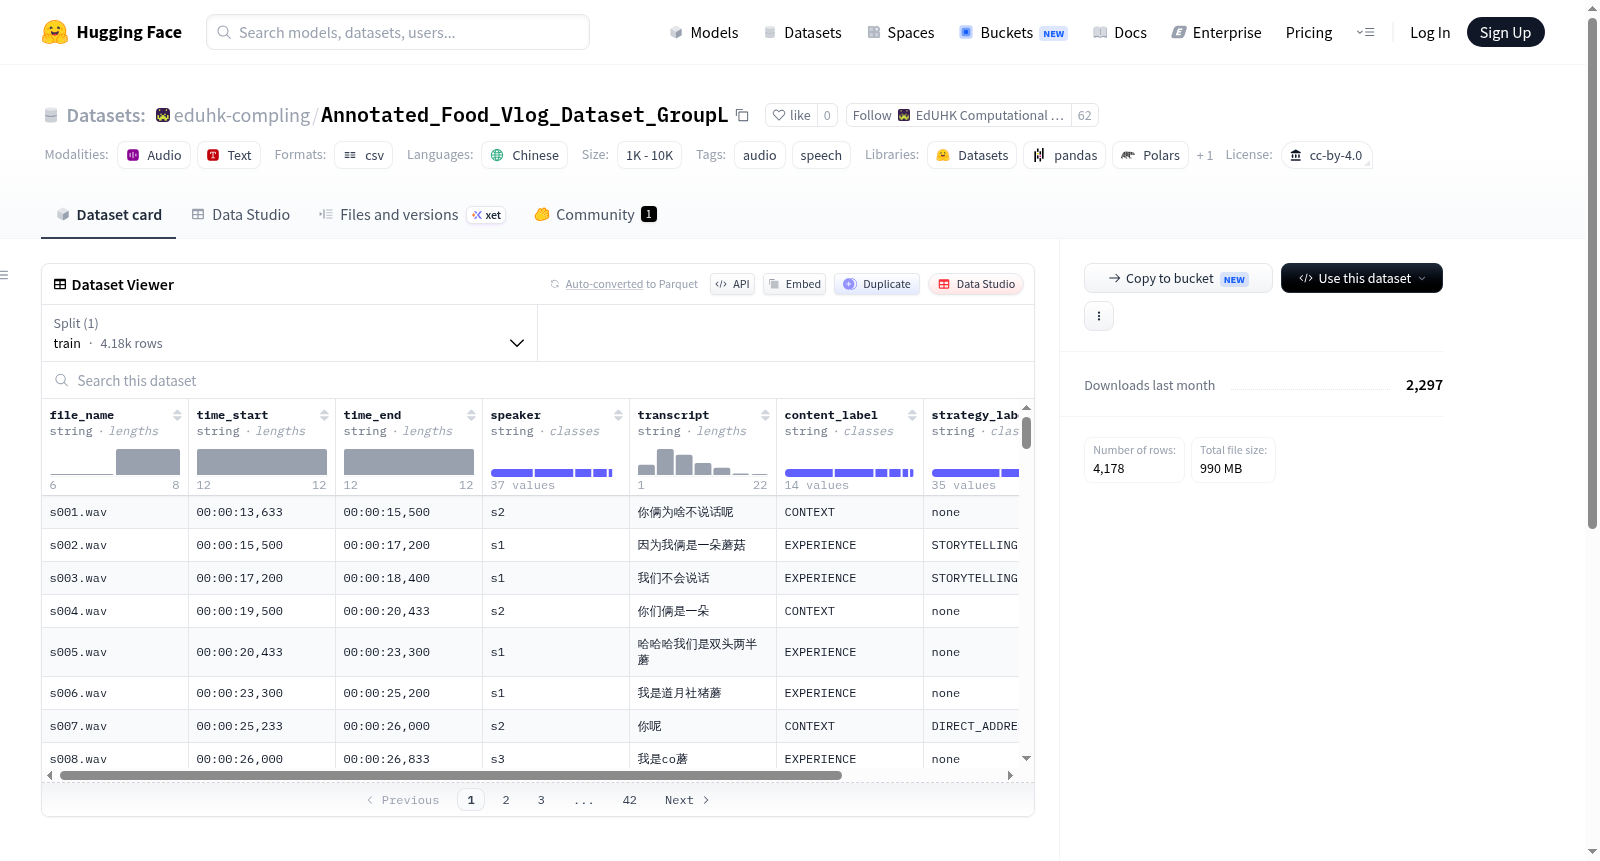
eduhk-compling/Annotated_Food_Vlog_Dataset_GroupL

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

该项目构建了一个围绕中国社交媒体上美食探索视频语言策略的多模态语料库。数据集以知名博主Diao Yueshe Shi Yu Ji的视频为核心,包含约1,000条条目,总计90分钟的转录视频内容,存储为CSV格式。数据集详细记录了原始对话、大型语言模型(LLM)生成的合成文本、修辞策略标签(如悬念、焦虑构建、仪式补偿)和感官描述词。在构建过程中,团队使用了Whisper等工具进行自动转录,并辅以人工校对,确保标注一致性达到85%。数据集采用对比抽样策略,将内容分为高流量和普通两组,旨在揭示不同话语模式如何影响观众参与和消费心理。尽管聚焦于单一顶级博主,但其语言风格被视为行业标杆,具有高度代表性。该资源不仅支持自然语言处理(NLP)中的意图识别任务,还可应用于数字营销、社会学和语料库语言学等跨学科研究,有助于理解数字时代说服性话语对消费者行为的塑造作用。

This project has constructed a multimodal corpus of language strategies for food exploration videos on Chinese social media. The dataset is centered around the videos of the well-known blogger Diao Yueshe Shi Yu Ji, containing approximately 1,000 entries with a total of 90 minutes of transcribed video content. The dataset is stored in CSV format and meticulously records the original dialogue, synthetic text generated by large language models (LLMs), rhetorical strategy labels (such as suspense, anxiety construction, ritual compensation), and sensory description words. During the construction process, the team utilized tools like Whisper for automatic transcription and supplemented with manual proofreading to ensure a consistency of 85% in the annotations. The dataset adopts a contrastive sampling strategy, dividing the content into high-traffic and ordinary groups, aiming to reveal how different discourse patterns influence audience engagement and consumer psychology. Although focused on a single top blogger, their language style is regarded as an industry benchmark and highly representative. This resource not only supports intent recognition tasks in natural language processing (NLP) but also can be applied to interdisciplinary research in digital marketing, sociology, and corpus linguistics, facilitating an understanding of the shaping effect of persuasive discourse on consumer behavior in the digital age.
提供机构:
eduhk-compling
搜集汇总
数据集介绍
eduhk-compling/Annotated_Food_Vlog_Dataset_GroupL 数据集图片
构建方式
本数据集以中国社交媒体知名博主“叨叨射手食语记”的探店视频为核心,精心构建了一个多模态语料库。团队采用Whisper等工具进行自动语音转写,并辅以人工校对,确保标注一致性达到85%。数据以CSV格式存储,共收录约1000条条目,涵盖90分钟转写视频内容。构建过程中,数据集采用对比采样策略,将内容划分为“高流量”与“普通”两组,旨在揭示不同话语模式对受众参与度及消费心理的影响。此外,还利用大语言模型生成合成文本,并与原始对话、修辞策略标签(如悬念、焦虑构建、仪式补偿)及感官描述词一同记录。
使用方法
本数据集适用于多种研究与开发场景。在自然语言处理领域,可直接用于意图识别任务的模型训练与评估。研究者可基于CSV格式的数据,利用其中提供的修辞标签、感官描述等特征,开展话语分析或生成式模型的微调。数字营销、社会学及语料库语言学领域的学者,可借助对比组设计,探究说服性话语对在线互动与消费行为的影响机制。数据集在HuggingFace平台以CC-BY-4.0许可公开,用户可通过加载metadata.csv文件便捷获取,便于直接集成到各类分析流水线中。
背景与挑战
背景概述
该数据集名为Annotated_Food_Vlog_Dataset_GroupL,创建于近期,由研究团队基于中国社交媒体平台上知名博主“吊爷食遇记”的视频内容构建。核心研究问题在于揭示数字时代下,美食类视频中语言策略如何影响观众参与度与消费心理。数据集聚焦于多模态语料,涵盖约1000条、总计90分钟转写视频,包含原始对话、大语言模型生成文本、修辞策略标签及感官描述词。作为针对单一头部博主的语料资源,其语言风格被视为行业标杆,具有高度代表性。该数据集不仅支持自然语言处理中的意图识别任务,还推动数字营销、社会学及语料库语言学等跨学科研究,深化对说服性话语在塑造消费者行为中作用的理解。
当前挑战
该数据集面临的核心挑战包括:首先,在领域问题层面,需应对社交媒体上多模态、口语化且充满修辞策略的语料对自然语言处理意图识别与语义分析带来的复杂性,尤其是如何从高流量与普通内容的对比采样中准确建模不同话语模式对受众心理的影响。其次,在构建过程中,团队遭遇了自动转录工具(如Whisper)与人工校验一致性仅达85%的瓶颈,标注质量受限于修辞策略标签(如悬念、焦虑构建)的主观性界定,以及单一博主样本的代表性可能限制模型泛化能力。此外,90分钟音视频转写与95万条数据标注的规模虽小但精细,平衡标注粒度与效率成为主要技术挑战。
常用场景
经典使用场景
该数据集的核心应用场景在于多模态语言策略分析与意图识别,尤其聚焦于中文社交媒体中美食探索类视频的语料解构。研究人员可借助该资源,对博主“吊爷食遇记”的视频对话进行精细化标注,结合自述文本与大语言模型生成的合成文本,深入剖析修辞策略标签(如悬念营造、焦虑构建、仪式补偿)与感官描述词的分布规律。通过对比“高流量”与“普通”两类样本,数据集为揭示语言模式如何影响受众参与度提供了量化基础,成为自然语言处理领域探究说服性话语结构的经典基准。
解决学术问题
该数据集针对数字时代消费心理学与话语交互的交叉学术难题,系统揭示了不同修辞模式对观众情感卷入及消费行为的潜在驱动机制。它填补了中文美食视频领域系统性标注语料的空白,使研究者得以量化分析焦虑诱导、仪式感补偿等策略在促成用户粘性中的作用。结合对比采样设计,数据集帮助学界厘清高传播内容与普通内容在语言特征上的统计学差异,为理解说服性话语如何塑造数字环境下的消费者决策过程提供了可复现的实证支撑,推动了语料语言学与营销学理论的深度融合。
实际应用
在实际应用中,该数据集可直接服务于社交媒体平台的算法优化与内容生态治理。平台方基于其修辞策略标签,可训练模型自动识别视频中的说服性语言强度,进而调节推荐算法的权重分配,帮助抑制过度焦虑营销或强化健康内容传播。此外,数字营销团队能利用数据集中的高流量模式样例,提炼出受众偏好规律,用于指导广告投放策略与品牌叙事设计。在跨文化传播领域,该资源还可作为验证中国本土社交媒体语言风格的参考试样,提升算法对中文语境的适应能力。
数据集最近研究
最新研究方向
在数字营销与计算社会语言学交叉领域,该数据集聚焦于剖析社交媒体美食视频中说服性话语对消费者心理与行为的塑造机制。前沿研究依托其对比采样策略(高流量vs普通内容),结合大语言模型(LLM)生成文本与修辞策略标签,探索焦虑构建、仪式补偿等话语模式如何驱动用户参与度。当前热点关联“算法推荐与内容消费”议题,数据集通过量化多模态语言策略(如悬念设置、感官描述词)与互动数据的关联,为理解数字时代“话语—注意力—购买决策”的级联效应提供实证基础,尤其对揭示网红经济中情感动员的底层逻辑具有跨学科方法论价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

