
glossAPI/heinrich_boell_stiftung
收藏官方服务:
资源简介:
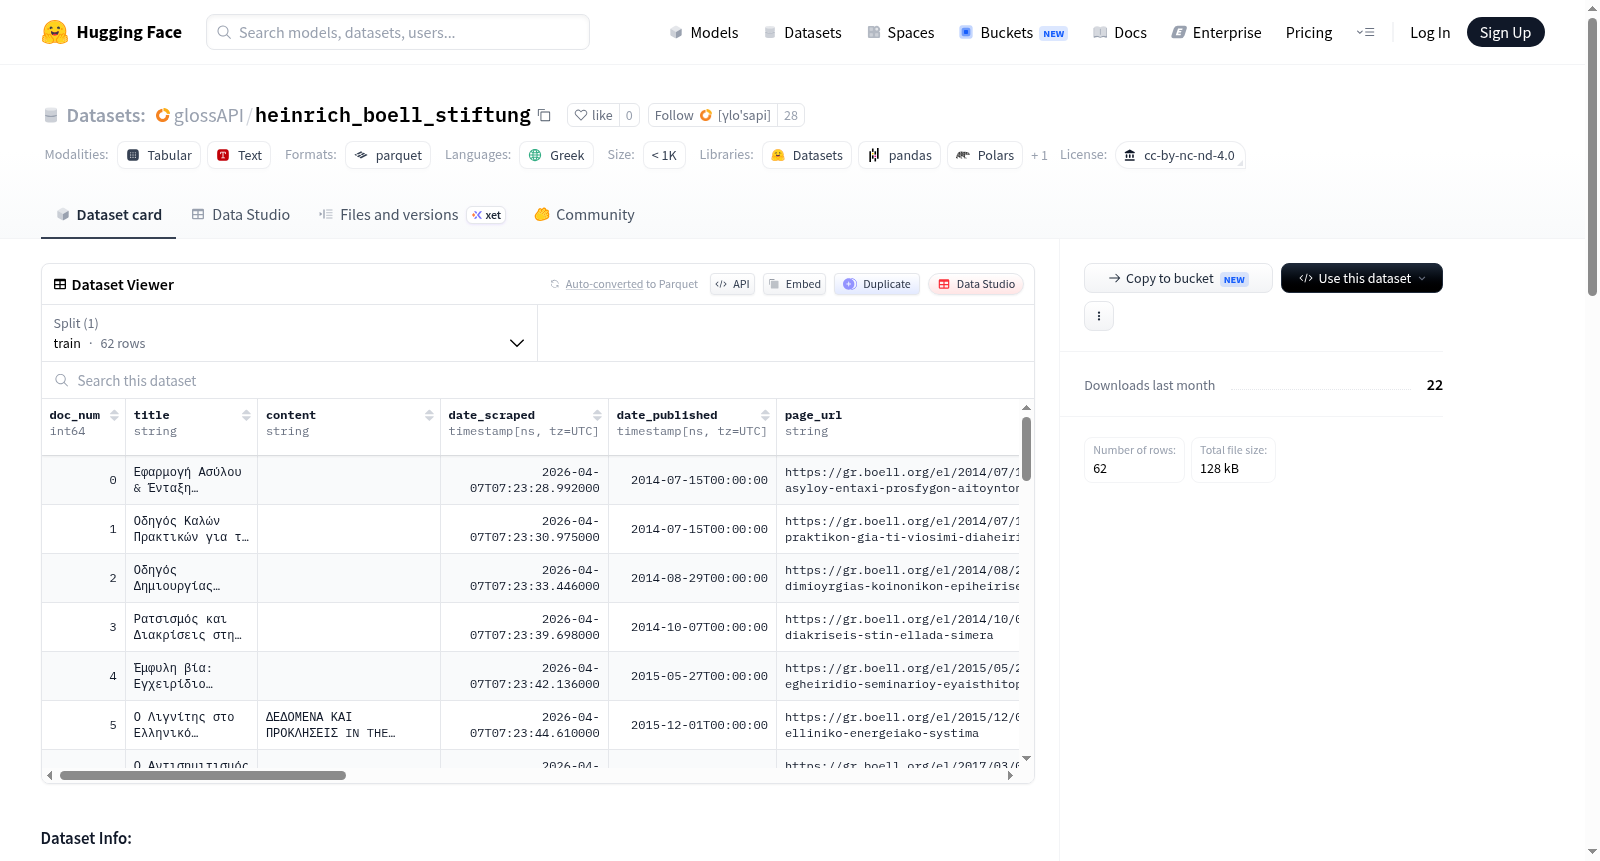
该数据集包含从希腊海因里希·伯尔基金会(Heinrich Böll Foundation)希腊办公室的出版物档案(https://gr.boell.org/el)中提取的文本信息。该收藏包括报告、研究、政策文件、手册和其他出版物,涵盖生态、民主、移民、社会和团结经济、能源转型、住房、性别平等、人权和欧洲政策等主题。数据集提供了丰富的元数据,如文档标识符、标题、内容、发布日期、URL等,并包含统计信息,例如记录数、磁盘大小、单词数和令牌数。数据集仅用于非商业研究、学术和教育用途,遵循CC BY-NC-ND 4.0许可。
This dataset contains textual information extracted from the publications archive of the Greek office of the Heinrich Böll Foundation (https://gr.boell.org/el). The collection includes reports, studies, policy papers, handbooks and other publications covering topics such as ecology, democracy, migration, social and solidarity economy, energy transition, housing, gender equality, human rights, and European policy.
提供机构:
glossAPI搜集汇总
数据集介绍
构建方式
该数据集源自德国海因里希·伯尔基金会希腊办事处公开发布的出版物档案,通过自动化网页抓取技术系统性地采集PDF文档,并运用OCR技术提取其中的文本内容。数据收录了该机构在生态、民主、移民、社会与团结经济、能源转型、住房、性别平等、人权及欧洲政策等领域的报告、研究论文、政策手册与出版物,共计62条记录。每条记录包含标题、完整文本、元数据如出版日期、文件校验码以及主题分类等十六个字段,以Parquet格式存储,确保高效存取与结构化处理。
特点
数据集特色在于其多学科交叉的文档主题覆盖,聚焦当代欧洲社会与环境议题,为研究生态政治、社会公正与民主治理提供了丰富的希腊语语料。所有文本均经过标准化处理,并提供了基于希腊语BERT分词器的词元统计(总计约46,995词元),便于自然语言处理任务中使用。此外,数据集严格遵循CC BY-NC-ND 4.0许可协议,明确限定为非商业研究用途,保障了原始版权所有者的知识产权。
使用方法
使用者可通过Hugging Face Datasets库轻松加载该数据集,指定'heinrich_boell_stiftung'名称即可获取包含标题、文本内容及完整元数据的DataFrame。文本字段主要集中于'title'与'content'列,适用于文本分类、主题建模、信息检索以及希腊语语言模型微调等任务。鉴于其知识共享许可限制,使用者不得进行商业利用或派生创作,并需在研究中正确引用海因里希·伯尔基金会为数据来源。
背景与挑战
背景概述
该数据集由希腊开源技术团队(GFOSS)与海因里希·伯尔基金会希腊办公室合作构建,创建时间不详但反映了近年希腊语社会政治文献的数字存档需求。核心研究问题聚焦于从非商业视角系统收集和分析关于生态、民主、移民及欧洲政策等多元议题的出版物文本。作为希腊语NLP领域少有的专题性非商业语料库,该数据集为研究小型语言社区中的政策话语分析、能量转型及社会正义等交叉领域提供了结构化文本资源,填补了相关区域研究的数据空白。
当前挑战
所解决的领域问题涵盖两个方面:一是希腊语社会政治类文献的数字化与结构化不足,现有资源多以商业新闻为主而缺乏专题报告和学术论文的深度覆盖;二是非商业许可(CC BY-NC-ND 4.0)限制了数据集的广泛复用与衍生工作,尤其禁止商业应用且要求非衍生使用,增加了跨机构协作的壁垒。构建过程中主要面临OCR技术对希腊语PDF档案的识别准确率挑战、多源文档格式(报告、手册、政策文件)的标准化提取难题,以及62条记录的小规模样本可能导致的模型泛化能力不足。
常用场景
经典使用场景
heinrich_boell_stiftung数据集收录了海因里希·伯尔基金会希腊办事处出版物档案中的报告、研究、政策文件与手册等文本资料,涵盖生态、民主、移民、社会与团结经济、能源转型、住房、性别平等、人权及欧洲政策等多元议题。该数据集最经典的使用场景在于为跨学科的欧洲政策研究提供高质量、多主题的希腊语文本语料,尤其适用于基于希腊语的环保政策、社会正义与可持续发展议题的文本挖掘、主题建模与语义分析,助力研究者从非政府组织视角洞察欧盟边缘区域的政策话语演变。
解决学术问题
该数据集有效解决了学术研究中希腊语非营利组织文本资源匮乏的问题,为自然语言处理与社会科学交叉领域提供了稀缺的结构化语料。它使得研究者能够基于真实出版物开展关于欧洲南部政策导向的量化文本分析,如通过词频统计与共现网络揭示移民议题中的话语框架,或利用潜在狄利克雷分配模型识别能源转型政策中的核心主题。其意义在于填补了东南欧公民社会文本数据集的空白,推动了区域政策研究从零散的案例描述向可复现的文献计量分析转型,为比较政治学与生态人文主义研究提供了实证基础。
衍生相关工作
基于该数据集已衍生出一系列重要工作,包括为希腊语BERT模型(如nlpaueb/bert-base-greek-uncased-v1)提供领域特定的微调语料,提升模型在环保政策文本上的语义理解能力。研究者亦利用其metadata中的时间戳与主题标签构建了动态主题演化器,揭示2015年欧洲难民危机前后移民话语的变迁规律。该数据集还与OpenAI的GPT系列模型结合,实验出基于检索增强生成的非营利组织年报自动摘要工具,显著降低了政策文件的处理成本。更有一项开源项目将其纳入OCR校正管道,验证了混合语言文档中的跨语种术语对齐算法,推动了低资源语言场景下的数字人文方法论创新。
以上内容由遇见数据集搜集并总结生成


