
LL-Bench
收藏数据链接:
官方服务:
资源简介:
LL-Bench是一个用于低层视觉评估的大规模人类偏好基准数据集,覆盖16个低层视觉任务。它包括28,919张恢复图像和2,469张真实世界退化源图像,以及152,020对偏好标注、28,334个Bradley-Terry质量分数和28,919个幻觉标签。
LL-Bench is a large-scale human preference benchmark dataset for low-level vision evaluation, covering 16 low-level vision tasks. It comprises 28,919 restored images, 2,469 real-world degraded source images, along with 152,020 preference annotation pairs, 28,334 Bradley-Terry quality scores, and 28,919 hallucination labels.
创建时间:
2026-05-29
原始信息汇总
数据集概述
LL-Bench 是一个大规模、基于人类偏好的低层级视觉评估基准数据集,旨在支持对大规模生成模型在低层级视觉任务上的表现进行评价。
覆盖任务
- 涵盖 16 种低层级视觉任务,包括但不限于:
- 去雨滴(Raindrop Removal)
- 高动态范围成像(HDR Imaging)
- 老照片修复(Old Photo Restoration)
数据规模
- 图像资产:
- 恢复后的图像:28,919 张(涵盖 16 项任务)
- 真实世界退化源图像:2,469 张(涵盖 16 项任务)
- 人类偏好资产:
- 成对偏好标注:152,020 条
- Bradley-Terry 质量分数:28,334 个
- 幻觉标签:28,919 个
配套评估模型:LL-Score
- 基于 Qwen3-VL 构建的评估器。
- 输入:退化图像、恢复后图像、任务名称。
- 输出:
- 与人类偏好对齐的质量分数
- 幻觉概率
项目状态
- 数据集和完整代码将在论文发表后公开,当前待发布内容包括:
- 数据集
- 模型检查点
- 推理代码
- 训练代码
搜集汇总
数据集介绍
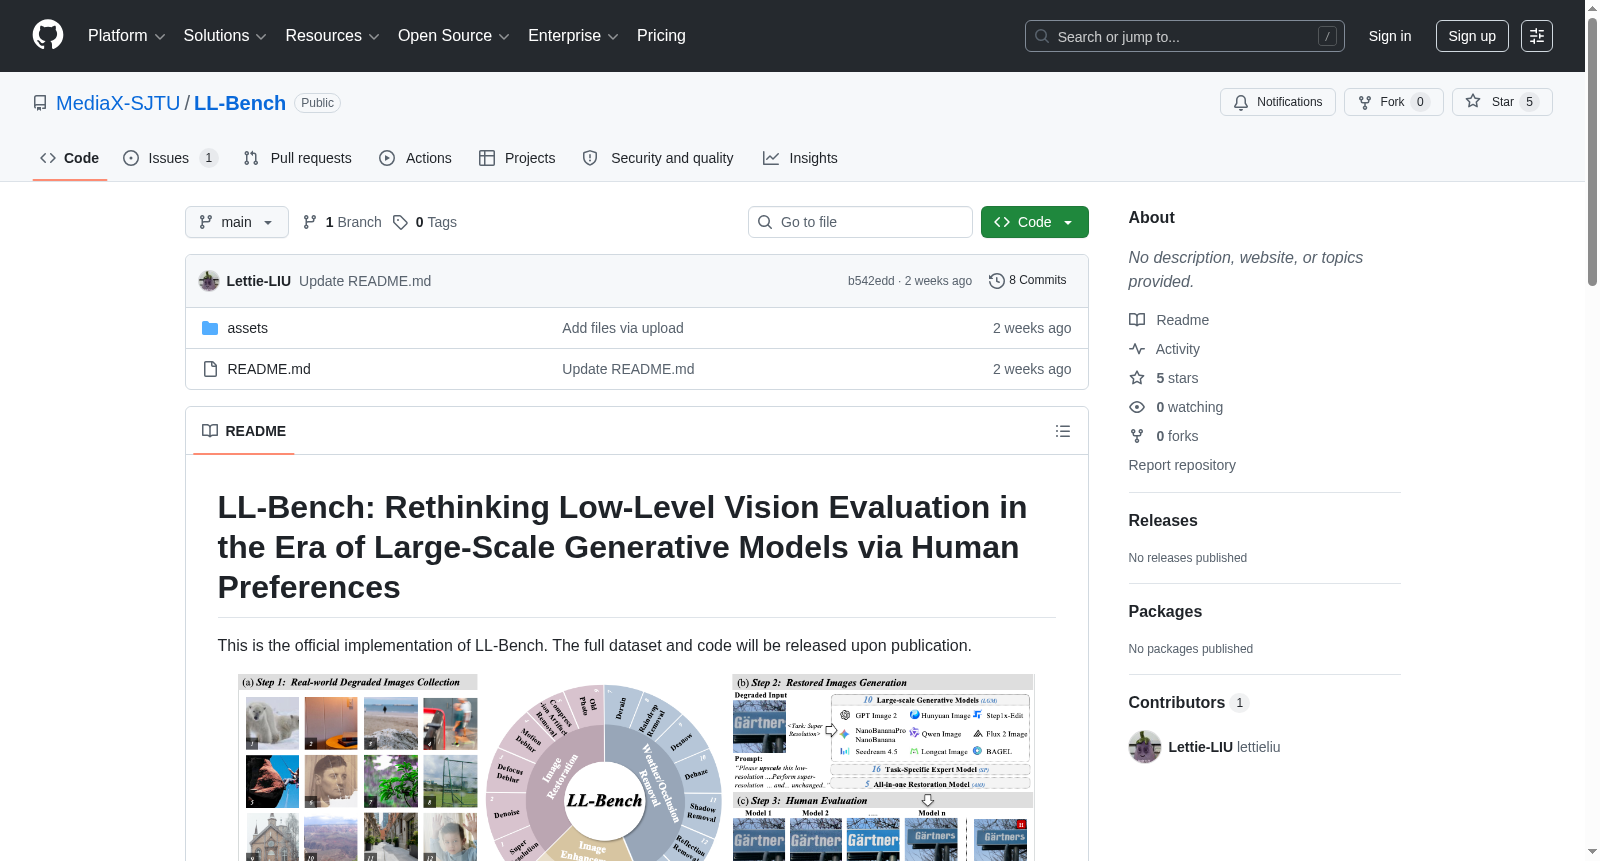
构建方式
LL-Bench数据集专为低层级视觉任务设计,旨在应对大规模生成模型时代对评估基准的迫切需求。该数据集通过系统性地收集16项低层级视觉任务的图像素材构建而成,包含28,919张修复后的图像和2,469张真实世界退化源图像。为捕捉人类偏好,研究团队开展了大规模主观偏好标注,共收集152,020对成对偏好注释,并基于Bradley-Terry模型计算出28,334个质量得分,同时为每张修复图像标注了幻觉标签(共28,919个),形成了多维度、细粒度的偏好感知评估体系。
特点
LL-Bench的核心特色在于其全面覆盖低层级视觉领域16项任务,从图像去雨、高动态范围成像到老照片修复,展现了任务多样性。数据集不仅包含大量真实退化图像,还首次以人类偏好为导向,提供成对比较注释和连续质量分数,突破了传统客观指标(如PSNR、SSIM)与人类视觉感知脱节的局限。此外,幻觉标签的引入使得模型在生成质量与真实性之间可实现平衡评估,为鲁棒性分析提供了独特视角。
使用方法
LL-Bench的使用围绕其配套评估器LL-Score展开,该评估器基于Qwen3-VL多模态大模型构建。使用时,用户需输入退化图像、修复后图像及任务名称,LL-Score会自动将任务信息封装至评估指令中,联合预测与人类偏好对齐的质量分数和幻觉概率。数据集计划开源,未来用户可通过下载完整数据、模型检查点及推理代码,轻松复现评估流程,并利用训练代码微调自定义评估器,实现特定任务的偏好校准。
背景与挑战
背景概述
在生成式大规模模型蓬勃发展的时代背景下,低层视觉任务(如图像恢复、增强与重建)的评估体系正面临深刻变革。传统基于像素级或感知度量的自动评价方法,如PSNR、SSIM或LPIPS,虽能捕获部分信号差异,却难以精准反映人类对视觉质量的真实偏好。为弥补这一鸿沟,LL-Bench数据集应运而生,由研究团队于近期精心构建,旨在为低层视觉领域提供一个大规模、以人类偏好为核心的全新评估基准。该数据集覆盖去雨、高动态范围成像、老照片修复等16项典型低层视觉任务,汇集了28,919张恢复图像、152,020对成对偏好标注及28,334个Bradley-Terry质量分数,为模型性能的公正衡量与人类感知对齐研究奠定了坚实的数据基础,有望引领该领域评估范式的转变。
当前挑战
LL-Bench所面对的挑战是多层次的。在领域问题层面,现有自动评价指标与人类视觉感知之间存在显著错位,导致模型在真实场景中的表现难以被准确度量,而大规模生成模型引入的伪影与幻觉现象进一步加剧了评估的复杂性。因此,构建一个能够忠实反映人类主观偏好的评估体系成为核心难题。在数据集构建过程中,挑战同样严峻:需要从真实世界中采集2,469张涵盖丰富退化类型的原始图像,并针对16个任务生成高质量的恢复结果;同时,需组织大规模人工标注,完成超过15万对偏好比较,并通过Bradley-Terry模型推导出连续的品质分数,确保标注的一致性与可靠性。此外,为每个样本标注幻觉标签以捕捉生成式模型的典型失真,亦是一项精细且耗时的工作。
常用场景
经典使用场景
在生成式模型席卷计算机视觉领域的当下,低层视觉任务的评测仍多依赖于PSNR、SSIM等传统指标,这些指标与人类主观感知之间存在显著错位。LL-Bench数据集正是为了弥合这一鸿沟而生,它涵盖了超分辨率、去雨、HDR成像、老照片修复等16项经典低层视觉任务,包含超过2.8万张由多种生成模型恢复的图像以及15万条成对偏好标注。其最核心的使用场景在于作为评估基准,用以衡量各类生成模型在低层视觉任务上的表现是否真正符合人类审美偏好,从而替代或补充传统的客观评价体系。
衍生相关工作
基于LL-Bench的数据与评估框架,研究者已衍生出多项高影响力工作。一方面,LL-Score作为一种Qwen3-VL驱动的评估器,开创了视觉语言模型在低层视觉质量评价中的应用先河,激励了后续将多模态大模型适配至图像质量评估的研究方向。另一方面,数据集中提供的3万条幻觉标注为检测生成图像中的不真实伪影提供了标准基准,催生了面向生成模型幻觉抑制的算法设计工作。此外,其跨任务统一评估的范式也被后续的通用图像恢复评测基准所借鉴和拓展。
数据集最近研究
最新研究方向
在大规模生成模型蓬勃发展的时代背景下,低层视觉评估正经历从传统指标向人类偏好对齐的深刻范式转变。LL-Bench数据集的提出,标志着该领域迈入了一个基于大规模人工偏好标注的系统化评估新阶段。该基准覆盖了超分辨率、去雨、HDR成像及老照片修复等16项低层视觉任务,囊括近2.9万张复原图像与超过15万对成对偏好标注,为模型性能的客观衡量提供了丰富的行为数据支撑。尤其值得关注的是,其配套的LL-Score评估器借助Qwen3-VL多模态大模型,实现了对复原图像质量与幻觉概率的联合预测,这一思路有望推动生成模型在安保监控、影视修复与移动摄影等前沿应用场景中的可信部署。LL-Bench的发布,不仅是低层视觉评估标准的重大革新,也可能成为相关热点事件如AI生成内容合规性讨论与图像复原技术可解释性研究的重要参考基准。
以上内容由遇见数据集搜集并总结生成


