
遇见数据集

vikhram-labs/IndicConBench

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

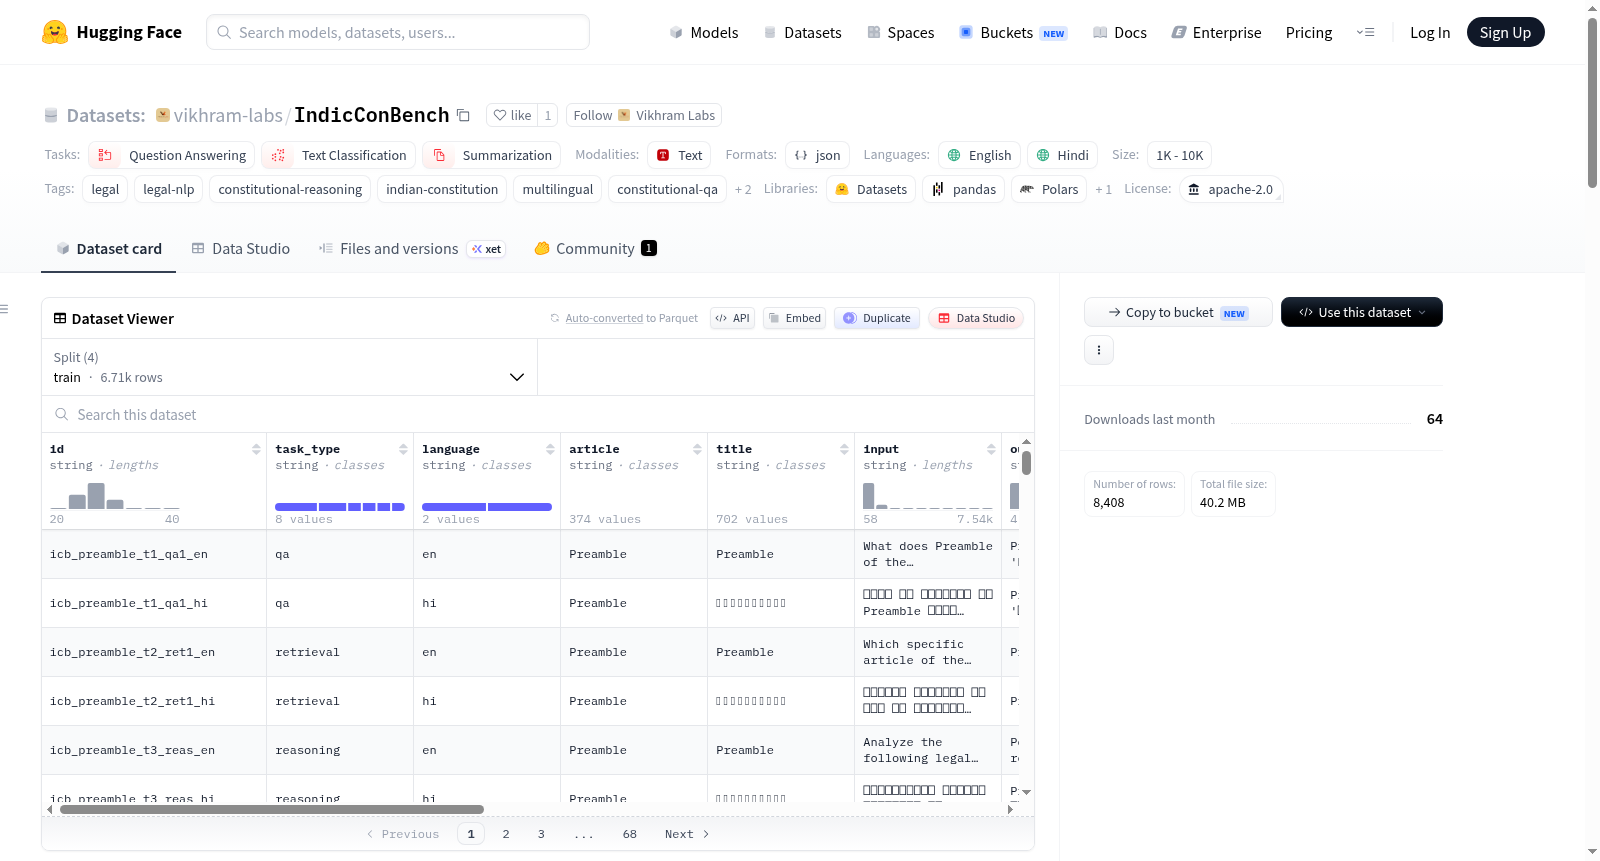
IndicConBench是一个针对印度的多语言宪法推理基准数据集,具有出版级和研究质量。它专门设计用于评估大语言模型在印度宪法上的事实准确性、推理能力、结构检索能力和法律智能,支持英语和印地语两种语言。该数据集由Vikhram S开发,Vikhram Labs发布,作为多语言法律AI领域的严格科学工具。它覆盖了465篇文章,包含8408个并行示例,总令牌数估计为1050651,并分为训练集(6708个示例)、验证集(832个示例)、测试集(848个示例)和GPQA集(20个示例,由专家编写的多项选择题)。数据集包含9个不同的任务家族,包括宪法问答、文章检索、宪法推理、摘要、蕴含、多跳推理、原则分类、文章链接和IndicConBench-GPQA,旨在全面评估法律AI的各个方面。数据集采用文章级分割以防止数据泄漏,并提供了科学的评估协议。

IndicConBench is a publication-grade, research-quality multilingual constitutional reasoning benchmark for India. It is specifically designed to evaluate the factual accuracy, reasoning capacity, structural retrieval capability, and legal intelligence of Large Language Models (LLMs) on the Constitution of India in both English and Hindi. Developed by Vikhram S and published under Vikhram Labs, this dataset serves as a rigorous scientific instrument for the multilingual legal AI domain. It covers 465 articles, with 8408 parallel examples, an estimated total of 1050651 tokens, and splits into train (6708 examples), validation (832 examples), test (848 examples), and GPQA (20 expert-authored multiple-choice examples). The dataset includes 9 diverse task families such as Constitutional QA, Article Retrieval, Constitutional Reasoning, Summarization, Entailment, Multi-hop Reasoning, Principle Classification, Article Linking, and IndicConBench-GPQA, aimed at evaluating distinct aspects of legal AI. It employs article-level partitioning to prevent data leakage and provides a scientific evaluation protocol.
提供机构:
vikhram-labs
搜集汇总
数据集介绍
vikhram-labs/IndicConBench 数据集图片
构建方式
IndicConBench的构建基于严格的学术规范,围绕印度宪法中的465条条款,以英文和印地文双语平行方式生成8408个样本。为确保数据无泄漏,采用条款级别的划分策略,将同一条款衍生的所有问答、摘要、推理等样本分配至相同的训练、验证或测试集(80%训练、10%验证、10%测试)。此外,还包含20个由专家撰写的Graduate-level多项选择题(IndicConBench-GPQA),作为独立的诊断性评估集。数据集由九大任务族构成,涵盖宪法问答、条款检索、法律推理、摘要生成、自然语言推理、多跳推理、原则分类、条款关联及高级推理,全面覆盖宪法知识的理解与运用维度。
特点
该数据集的核心特色在于其多语言、多任务与零泄漏的科学设计。双语并行语料(英语与印地语)支持对模型跨语言法律推理能力的公正评估。九大任务族从事实记忆、逻辑推理到结构检索,系统性地检验大语言模型在宪法领域的综合智能。条款级严格划分杜绝了数据污染,确保评估结果的可靠性。IndicConBench-GPQA子集尤其注重高阶推理能力,要求模型排除干扰项并整合多重法律原则,为前沿模型的能力边界提供严苛的度量标准。
使用方法
使用者可通过Hugging Face datasets库直接加载该数据集,例如调用load_dataset("vikhram-labs/IndicConBench")即可获取训练、验证、测试及gpqa四个拆分。数据集支持问答、分类、摘要等多种任务类型,适配常见的多任务训练与评估流程。官方提供结构化的评估脚本(evaluate.py),支持精确匹配(EM)、宏F1分数及ROUGE-L等指标的自动计算,便于研究者标准化地比较模型性能。建议在使用时将预测结果按任务和语言分组,以全面分析模型在不同维度的表现。
背景与挑战
背景概述
近年来,随着法律人工智能的蓬勃发展,如何使大语言模型具备对宪法文本的精确理解与逻辑推演能力,已成为自然语言处理领域的重要前沿课题。IndicConBench是一个面向印度宪法的多语言推理基准数据集,由Vikhram S于2026年在Vikhram Labs主导创建,旨在系统性评估大语言模型在处理宪法条文时的事实准确性、推理能力、结构检索能力及法律智能水平。该数据集覆盖英语与印地语两种语言,涵盖465项宪法条文,包含8408个并行样例,并构建了包括宪法问答、文章检索、多跳推理、蕴含判定、原则分类等在内的九大任务族。作为首个聚焦印度宪法语境的多语言评测基准,IndicConBench为跨国法律NLP研究提供了关键评测工具,对推动法律智能评估体系的完善具有重要引领意义。
当前挑战
IndicConBench的构建与所解决的领域问题均面临显著挑战。在领域应用层面,该数据集主要应对大语言模型在宪法推理时易产生的实体幻觉、条文误引及多语言语义对齐困难等问题。例如,模型需在跨语言场景下准确判别宪法条文之间的支持、扩展与限定关系,并在复杂法律情境中识别隐含的宪法原则。在数据集构建过程中,挑战尤显突出:其一,设计零泄漏的条文级数据划分机制,确保训练集与测试集之间不存在内容重叠;其二,构建包含专家撰写的、需要多步推理与干扰项消除的IndicConBench-GPQA子集,对数据质量提出了极高要求;其三,在九大任务族中实现语法与语义层面的跨任务一致性,以确保评测的科学性与可重复性。这些挑战共同使IndicConBench成为法律AI评测领域中的高质量基准。
常用场景
经典使用场景
IndicConBench作为首个面向印度宪法的多语言推理基准数据集,其经典使用场景聚焦于对大型语言模型(LLM)在宪法智能方面的系统性评估。该数据集涵盖九大任务族,包括宪法问答、文章检索、复杂法律场景下的宪法推理、多跳推理、文本蕴含及原则分类等,能够全面检验模型在事实准确性、逻辑推理、结构性检索和法律知识整合上的能力。研究者常利用其严格的零泄露分割设计和包含专家撰写多选题的GPQA子集,对模型进行从基础事实到高级推理的多层次评测,是衡量多语言法律AI系统性能的权威工具。
实际应用
在实际应用层面,IndicConBench为法律科技赋能提供了坚实的实证基础。法律调查、案例文书自动分析、宪法知识辅助检索系统以及多语言法律咨询服务等场景可直接受益于该数据集训练的模型。例如,面向公众的宪法问答机器人可利用其学习准确提取并解释条款,辅助公民理解自身权利;法律从业者则可借助基于该基准优化的检索系统快速定位相关宪法条文及判例关联。此外,鉴于其英语与印地语双语设计,IndicConBench在促进印度多语言司法信息平等获取、支持法律教育工具开发等方面展现出重要的应用价值。
衍生相关工作
围绕IndicConBench已衍生出一系列具有影响力的学术工作。部分研究聚焦于将其在预训练-微调范式下用于比较不同双语LLM(如Llama、Gemma的印地语变体)的宪法推理水平,并针对其GPQA子集分析模型在复杂多步推理与干扰项排除上的瓶颈。另一些工作则利用该数据集的文章链接与原则分类任务,开发用于自动构建法律知识图谱的模块,探索宪法条文的语义关系网络。此外,有研究者基于其蕴含任务设计跨域迁移学习框架,证明基于IndicConBench学到的法律逻辑特性可部分迁移至其他法律体系的文本分析任务中,拓展了该数据集的学术辐射范围。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

