
遇见数据集

chcaa/eno-newspapers-enriched

收藏
Hugging Face2026-05-22 更新2026-05-31 收录
官方服务:

资源简介:

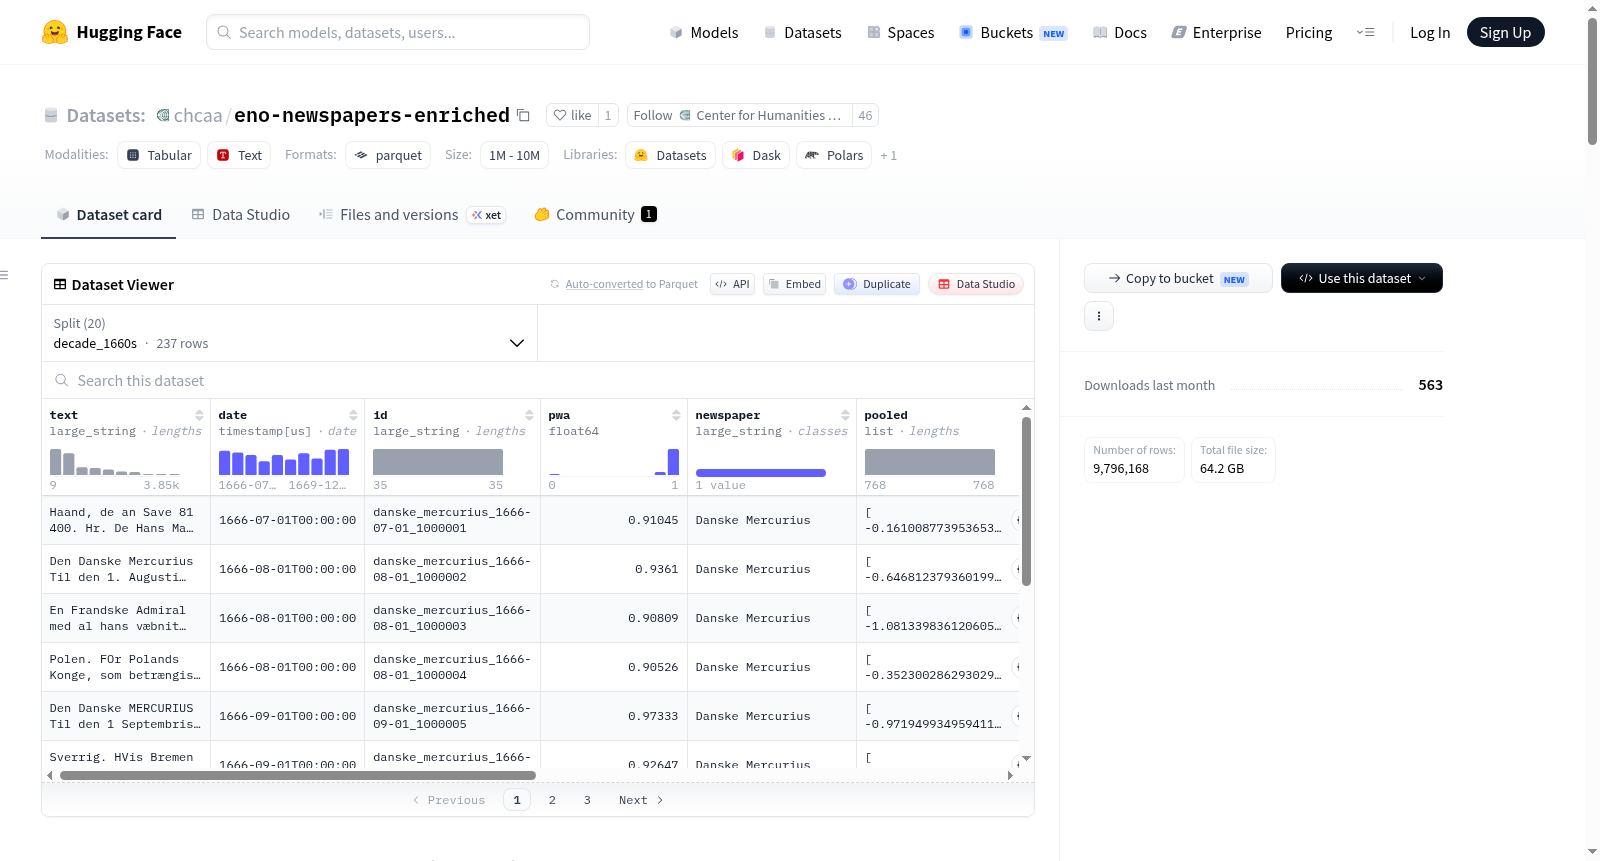
该数据集包含约490万篇丹麦历史报纸文章(1666年至1850年),带有文档嵌入和分配的虚构性标签,为通过主要新闻来源研究丹麦语言、文化和历史提供了全面资源。数据集包括丹麦报纸的数字化文章,包含全文内容以及元数据,如发布日期、报纸标题和自动分类。该集合涵盖28种丹麦历史报纸和期刊,在1666年至1850年间在丹麦-挪威出版。数据集包含使用Old_News_Segmentation_SBERT_V0.1模型创建的文档嵌入(汇集表示)。关键统计:总文章数4,898,084;数据集大小约33.7 GB(未压缩),约25.1 GB(下载);语言:丹麦语;格式:Parquet文件。

This dataset contains approximately 4.9 million Danish historical newspaper articles (1666–1850) with document embeddings and assigned fictionality tags, providing a comprehensive resource for studying Danish language, culture, and history through primary journalistic sources. The dataset comprises digitized newspaper articles from Danish newspapers, featuring full-text content along with metadata including publication dates, newspaper titles, and automated category classifications. The collection spans 28 Danish historical newspapers and periodicals, published between 1666 and 1850 in Denmark-Norway. The dataset includes document embeddings (pooled representations) created with the Old_News_Segmentation_SBERT_V0.1 model. Key statistics: Total articles: 4,898,084; Dataset size: ~33.7 GB (uncompressed), ~25.1 GB (download); Language: Danish (da); Format: Parquet files.
提供机构:
chcaa
搜集汇总
数据集介绍
chcaa/eno-newspapers-enriched 数据集图片
构建方式
该数据集源自丹麦与挪威国家图书馆珍藏的历史报纸典藏,经数字化处理后,依托基于SBERT架构的Old_News模型提取文档嵌入表示,并借助逻辑回归分类器自动标注内容类别(国内新闻、国际新闻、广告、杂项)与虚构性标签(虚构/非虚构)。分类模型经80/20训练测试划分的50次迭代验证,F1分数达0.93至0.97;虚构性判定通过分层分组k折交叉验证,精确率与召回率约0.88至0.89,且概率校准可靠(Brier分数0.024)。最终形成涵盖约490万篇丹麦语新闻文章的语料库。
使用方法
数据集以Parquet格式存储,可通过HuggingFace Datasets库便捷加载。用户可按十年切片(如decade_1700s)高效抽样,也可直接加载全部训练数据。支持跨十年拼接,例如通过concatenate_datasets串联指定年代区间,适用于时间序列分析与历时性研究。各样本可供下游任务如文本分类、嵌入空间探勘、虚构性检测模型训练等场景直接使用,代码范式简洁灵活。
背景与挑战
背景概述
该数据集由奥尔胡斯大学人文学科计算中心的Alie Lassche、Pascale Feldkamp、Rie Eriksen及Johan Heinsen等学者于2026年构建,旨在为丹麦历史报纸研究提供大规模、语料增强的数字化资源。数据集收录了1666年至1850年间丹麦-挪威地区的28种报纸,包含约490万篇文章,并附有基于Old_News模型生成的文档嵌入和虚构性标签。其核心研究问题在于利用自然语言处理技术挖掘早期新闻文本中的语义结构与文体特征,为历史学、语言学及媒体研究提供量化分析基础。该数据集在数字人文领域具有重要影响力,尤其在推动历史报纸语料的开放获取与自动化标注方面树立了标杆,并为后续研究提供了可复现的基准资源。
当前挑战
该数据集所应对的领域挑战在于历史新闻文本的自动分类与语义解析,尤其是跨越近两百年语言演变的多类别内容识别。构建过程中面临的具体困难包括:光学字符识别因纸张老化、印刷质量参差而引入大量噪音;文章边界分割算法不完善导致部分内容合并或拆分;数据集反映的时代偏见与社会态度需谨慎解读;数字化覆盖存在时间与地域不均衡性;丹麦语在正字法与词汇上的历史变迁增加了标注难度。此外,模型训练依赖有限的人工标注,虚构性标签标注仅占数据集1.58%,其泛化能力有待验证,而不同报纸类型的代表性偏差进一步限制了结论的普适性。
常用场景
经典使用场景
在数字人文与历史语言学研究领域,eno-newspapers-enriched数据集作为一部跨越近两个世纪的丹麦语历史报纸语料库,为探索早期现代公共领域的语言演变与文化传播提供了珍贵素材。研究者可基于其丰富的元数据,如出版日期、报纸来源及自动标注的内容类别,对1666年至1850年间丹麦社会的信息流通模式进行系统性分析。该数据集的经典使用方式包括利用预计算的文档嵌入进行语义相似度检索,追踪特定主题在时间轴上的兴衰,或是借助虚构性标签区分新闻事实与文学创作,从而揭示新闻业与文学在公共话语空间中的交织关系。
解决学术问题
该数据集的核心学术贡献在于填补了丹麦历史报纸数字化资源的空白,并解决了历史文本分析中语料标注与语义表征的瓶颈问题。通过提供高精度的内容分类标签(F1-score达0.93-0.97)和可靠的虚构性判别模型(精确率与召回率约0.89),研究者得以量化考察新闻话语中虚构性内容的占比及其历时变化,进而探讨18至19世纪丹麦公共领域的形成机制。此外,其嵌入表示支持跨文档的语义计算,使得探讨“民族新闻”与“国际新闻”在舆论建构中的权重成为可能,为历史社会学与传播学提供了可复现的数据基础设施。
实际应用
在实际应用中,eno-newspapers-enriched数据集被广泛部署于文化遗产数字化保护与智能信息提取场景。自然语言处理团队可凭借其预训练的句子嵌入模型,开发历史丹麦语的词义消歧与文本分割工具,提升OCR后处理的质量。图书馆与档案馆利用其按十年划分的数据分片,高效构建主题演变的可视化平台,辅助公众理解历史语境中的社会变迁。同时,该数据集的虚构性概率过滤功能,为文学史研究者筛选早期报纸中的小品文与连载小说提供了自动化手段,助力跨媒体的文学档案重建与数字策展实践。
数据集最近研究
最新研究方向
基于丹麦历史报纸语料的计算文体学与公共领域演化研究。该数据集凭借其跨越1666至1850年的巨量报纸文本、预计算文档嵌入与虚构性标签,为计算人文学者探索早期现代公众舆论的生成机制提供了前所未有的量化基石。近期前沿方向聚焦于利用其嵌入特征与高精度分类结果(虚构性分类F1达0.88-0.89),系统追踪非虚构与虚构类新闻在社会转型期中的分布变迁,进而揭示印刷媒介如何塑造了十八至十九世纪北欧的公共话语空间。研究团队正借助该资源将历史新闻学分析与自然语言处理深度融合,推动对大西洋世界知识传播与舆论形成的跨时代计量理解。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

