
meetween/mumospee_gigaspeech
收藏官方服务:
资源简介:
该数据集是gigaspeech语料库的修改版本,已转换为parquet格式,以便在高性能和分布式计算环境中优化I/O操作。GigaSpeech是一个不断发展的多领域英语语音识别语料库,包含10,000小时的高质量标注音频,适用于监督训练。转录的音频数据收集自有声读物、播客和YouTube,涵盖朗读和自发说话风格,以及多种主题,如艺术、科学、体育等。
This dataset is a modified version of the gigaspeech corpus, converted into parquet format to facilitate optimized I/O operations in high-performance and distributed computing environments. GigaSpeech is an evolving, multi-domain English speech recognition corpus with 10,000 hours of high quality labeled audio suitable for supervised training. The transcribed audio data is collected from audiobooks, podcasts and YouTube, covering both read and spontaneous speaking styles, and a variety of topics, such as arts, science, sports, etc.
提供机构:
meetween搜集汇总
数据集介绍
构建方式
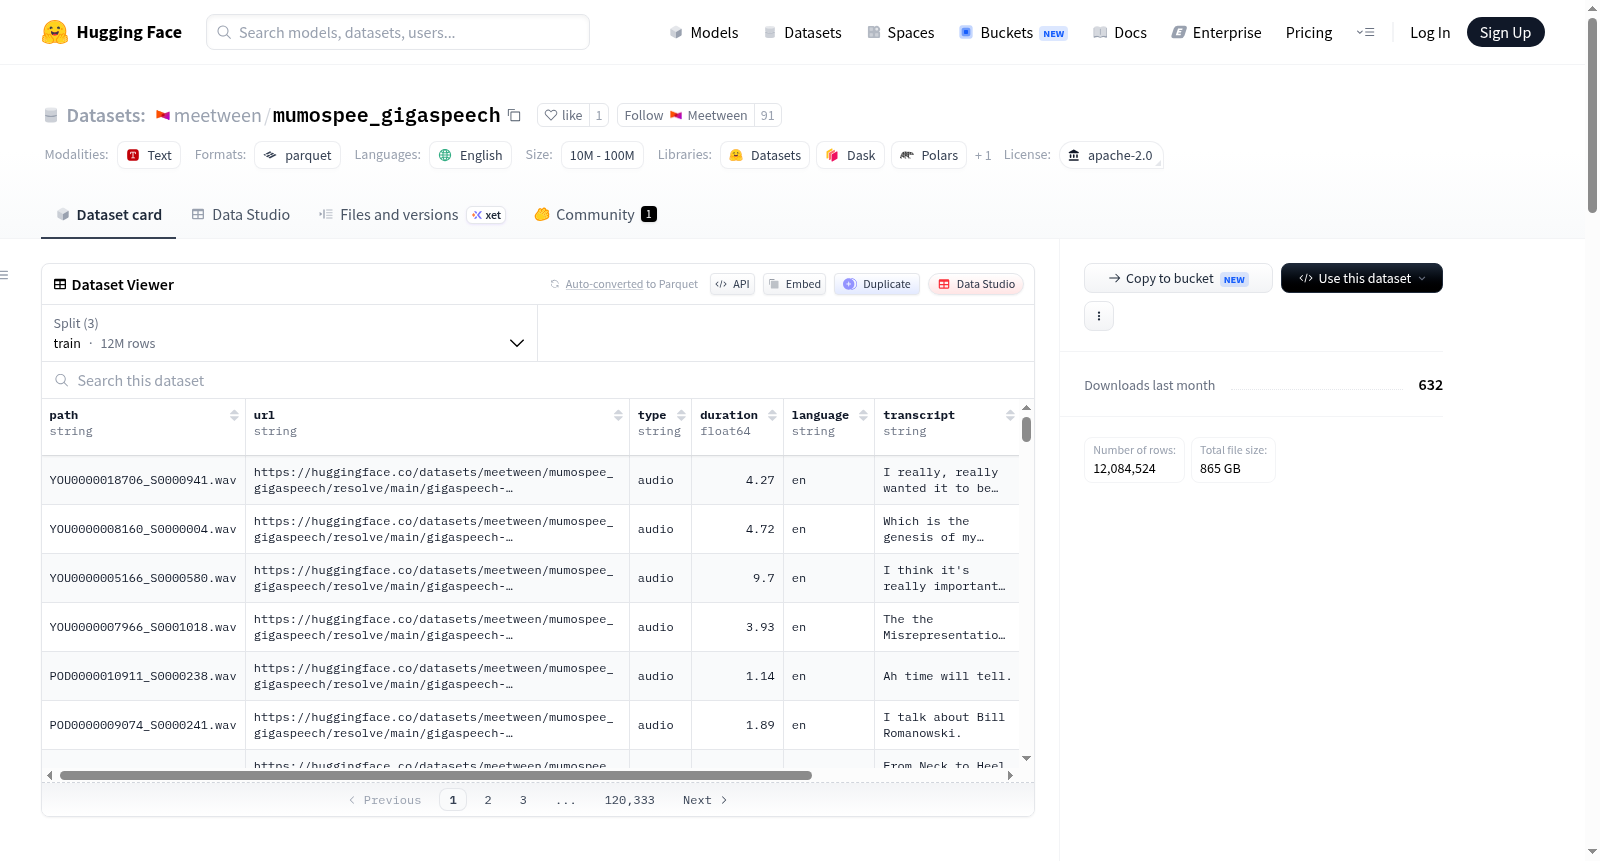
本数据集源于GigaSpeech语料库,一个涵盖有声读物、播客和YouTube视频等多元领域的10,000小时英文语音识别数据集,兼具朗读与自发言语风格及艺术、科学、体育等多主题。为适应高性能分布式计算环境,原始数据被转换为Parquet格式,通过列式存储和高效压缩算法,显著降低存储空间并提升I/O吞吐量。数据集包含61个训练分片、测试与验证集,每个分片以Parquet文件存储完整音频及源字段。同时,为每个划分生成轻量级元数据索引,记录音频段路径、来源URL、时长、转写文本和标签,便于高效检索与加载。
使用方法
用户可通过Hugging Face Datasets库直接加载该数据集,指定Parquet路径即可高效读取。在分布式训练框架中,利用Parquet的压缩特性可降低存储带宽需求,通过元数据索引的url列快速分片加载音频段。数据集适用于大规模语音识别或语音转文本任务,尤其是需高吞吐数据管道的场景。使用时需引用原始GigaSpeech论文,并在数据加载代码中指定gigaspeech-parquet目录下的训练、测试或验证Parquet文件。对于自定义分片,可基于metadata/中的索引按需过滤,如选择特定时长或语言的音频段进行微调。
背景与挑战
背景概述
在大规模语音识别领域,数据集的规模与多样性直接影响模型的泛化能力。GigaSpeech是由Guoguo Chen等众多知名学者于2021年提出的多领域英语语音识别语料库,涵盖了有声读物、播客和YouTube等多种来源,包含约10,000小时高质量标注音频。该数据集囊括了朗读与自发性语音风格,并覆盖艺术、科学、体育等多种主题,极大地推动了端到端语音识别系统的研究。mumospee_gigaspeech作为其衍生版本,由研究人员进一步转换为Parquet格式,旨在优化分布式高性能计算环境下的数据加载效率,降低了存储占用并提升了I/O性能,为大规模型训练提供了基础设施支持。
当前挑战
该数据集核心挑战在于解决语音识别系统对大规模、多领域标注数据的需求。原始GigaSpeech虽包含海量音频,但传统数据格式在分布式训练时存在I/O瓶颈,影响训练吞吐量。为此,mumospee_gigaspeech通过转换为Parquet列式存储格式,并重构元数据索引,显著减少了存储开销与数据加载延迟。此外,构建过程中需处理海量音频的分片与一致性校验,确保超过600万个语音段的结构化索引正确,同时剔除纯非语音片段,以保障训练数据的质量与可靠性。
常用场景
经典使用场景
GigaSpeech作为大规模、多领域英语语音识别语料库,汇聚了来自有声书、播客和YouTube的丰富音频资源,涵盖了朗读与即兴口语风格,主题横跨艺术、科学、体育等多元领域。经典使用场景聚焦于端到端语音识别系统的训练与评估,凭借其高达10,000小时的高质量标注数据,能够显著提升模型在嘈杂环境、不同口音及多风格口语下的鲁棒性和泛化能力。研究者通常将其作为大规模基准数据集,用以验证新型神经网络架构(如Transformer、Conformer)在纯英文转写任务中的性能上限。
解决学术问题
该数据集有效解决了传统英文语音识别语料库规模有限、领域覆盖狭窄及风格单一等核心瓶颈,为学术界提供了一个兼具广度与深度的标准化训练资源。它支撑了对说话风格、主题领域及背景噪声对识别精度影响的系统性研究,推动了半监督与无监督预训练方法的探索。经由GigaSpeech的广泛应用,研究者得以深入分析数据规模与模型表现之间的挛生关系,并确立了基于大规模多领域数据构建通用语音识别系统的新范式,对提升跨场景迁移能力具有里程碑式的意义。
实际应用
实际上,GigaSpeech已成为智能语音助手、自动字幕生成、会议记录转录及有声内容索引等商业化产品的核心训练基石。其多样化的音频源使得在真实世界场景中部署的语音系统能够从容应对复杂的声学环境与口音差异。此外,经MumoSpect格式优化后的版本凭借高效列式存储设计,大幅提升了分布式计算环境下的数据吞吐能力,尤其适合云端大规模模型训练工程,加速了从实验室研究到实际产品的落地进程。
数据集最近研究
最新研究方向
当前,大规模多领域语音识别语料库的研究正朝着高效存储与分布式训练优化的方向演进。mumospee_gigaspeech作为GigaSpeech的衍生版本,通过将传统音频数据转换为Parquet列式存储格式,显著降低了I/O延迟与存储开销,为高性能计算集群下的超大规模语音模型训练提供了关键基础设施。这一改进顺应了语音领域对万小时级标注数据高效利用的迫切需求,尤其在自监督预训练、多任务联合学习等前沿范式中,数据加载效率成为制约模型规模化扩展的瓶颈。mumospee_gigaspeech的技术路线不仅延续了GigaSpeech在多领域、多风格语音覆盖上的优势,更通过工程优化推动了语音识别从实验室研究向工业级应用的跨越,为下一代端到端语音系统的快速迭代奠定了数据基石。
以上内容由遇见数据集搜集并总结生成


