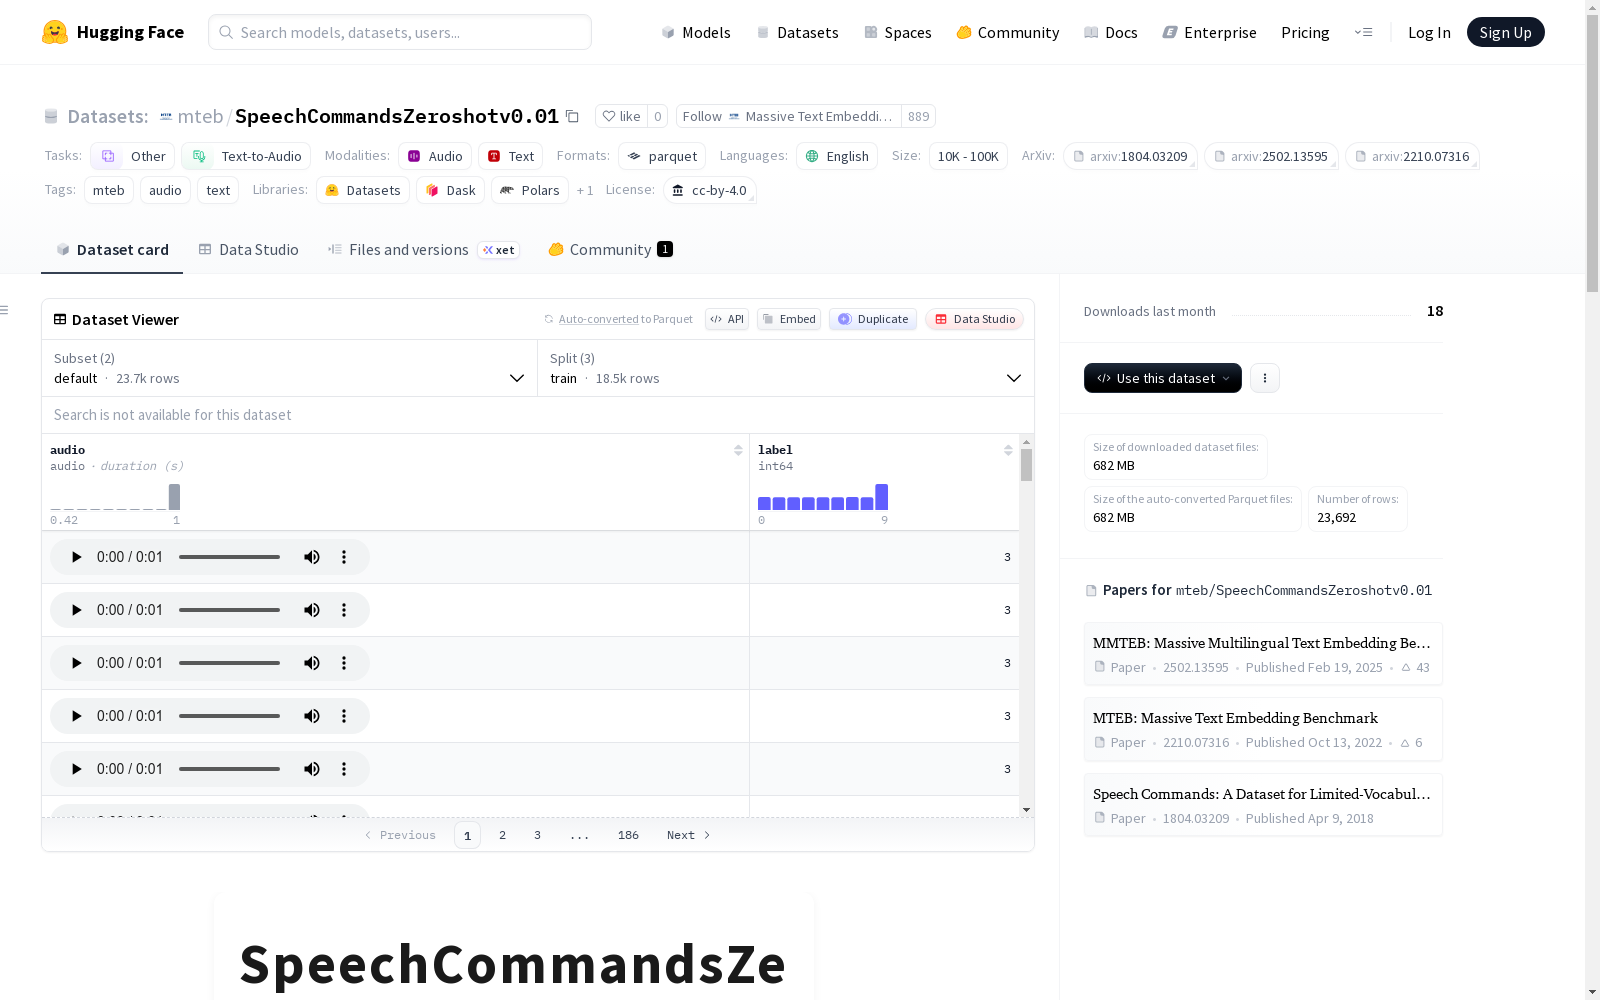
SpeechCommandsZeroshotv0.01
收藏资源简介:
声音分类/关键词识别数据集。这是一组包含单个英语单词或背景噪声的一秒钟音频片段。这些单词来自一小部分命令,如'yes'、'no'和'stop'等,由不同的说话者发音。数据集共有10个标签/命令用于关键词识别,以及30个标签用于其他辅助任务。
Sound Classification/Keyword Recognition Dataset. This dataset consists of 1-second audio clips containing single English words or background noise. These words are derived from a small set of commands such as 'yes', 'no', 'stop', etc., and pronounced by different speakers. The dataset has a total of 10 labels/commands for keyword recognition, plus another 30 labels for other auxiliary tasks.
SpeechCommandsZeroshotv0.01 数据集概述
基本信息
- 数据集名称: SpeechCommandsZeroshotv0.01
- 创建者: 人工标注
- 语言: 英语
- 许可证: CC-BY-4.0
- 多语言性: 单语言
- 来源数据集: google/speech_commands
- 任务类别: 其他、文本到音频
- 标签: mteb、audio、text
数据集描述
这是一个用于声音分类/关键词检测的数据集。数据包含一系列时长为一秒的音频片段,每个片段包含一个单独的英语口语单词或背景噪音。这些单词来自一小部分命令,例如“yes”、“no”和“stop”,由不同的说话者说出。该数据集包含10个用于关键词检测的标签/命令,以及总共30个用于其他辅助任务的标签。
- 任务类别: a2t
- 领域: 口语
- 参考: https://huggingface.co/datasets/google/speech_commands
数据集结构与规模
数据集包含两种配置:
配置一:default
- 特征:
audio: 音频数据label: 标签(int64类型)
- 数据划分与规模:
- 训练集: 18,538 个样本,584,484,004.75 字节
- 验证集: 2,577 个样本,81,329,884.875 字节
- 测试集: 2,567 个样本,82,287,752.125 字节
- 下载大小: 682,401,908 字节
- 数据集总大小: 748,101,641.75 字节
配置二:labels
- 特征:
labels: 标签(string类型)
- 数据划分与规模:
- 训练集: 10 个样本,71 字节
- 下载大小: 832 字节
- 数据集总大小: 71 字节
评估方法
可以使用MTEB库对嵌入模型在该数据集上进行评估。
引用信息
如果使用此数据集,请引用原始Speech Commands数据集、MMTEB论文以及MTEB基准测试论文。