遇见数据集

NADI2026_subtask3_TTS_test

收藏
Hugging Face2026-07-20 更新2026-07-21 收录
官方服务:

资源简介:

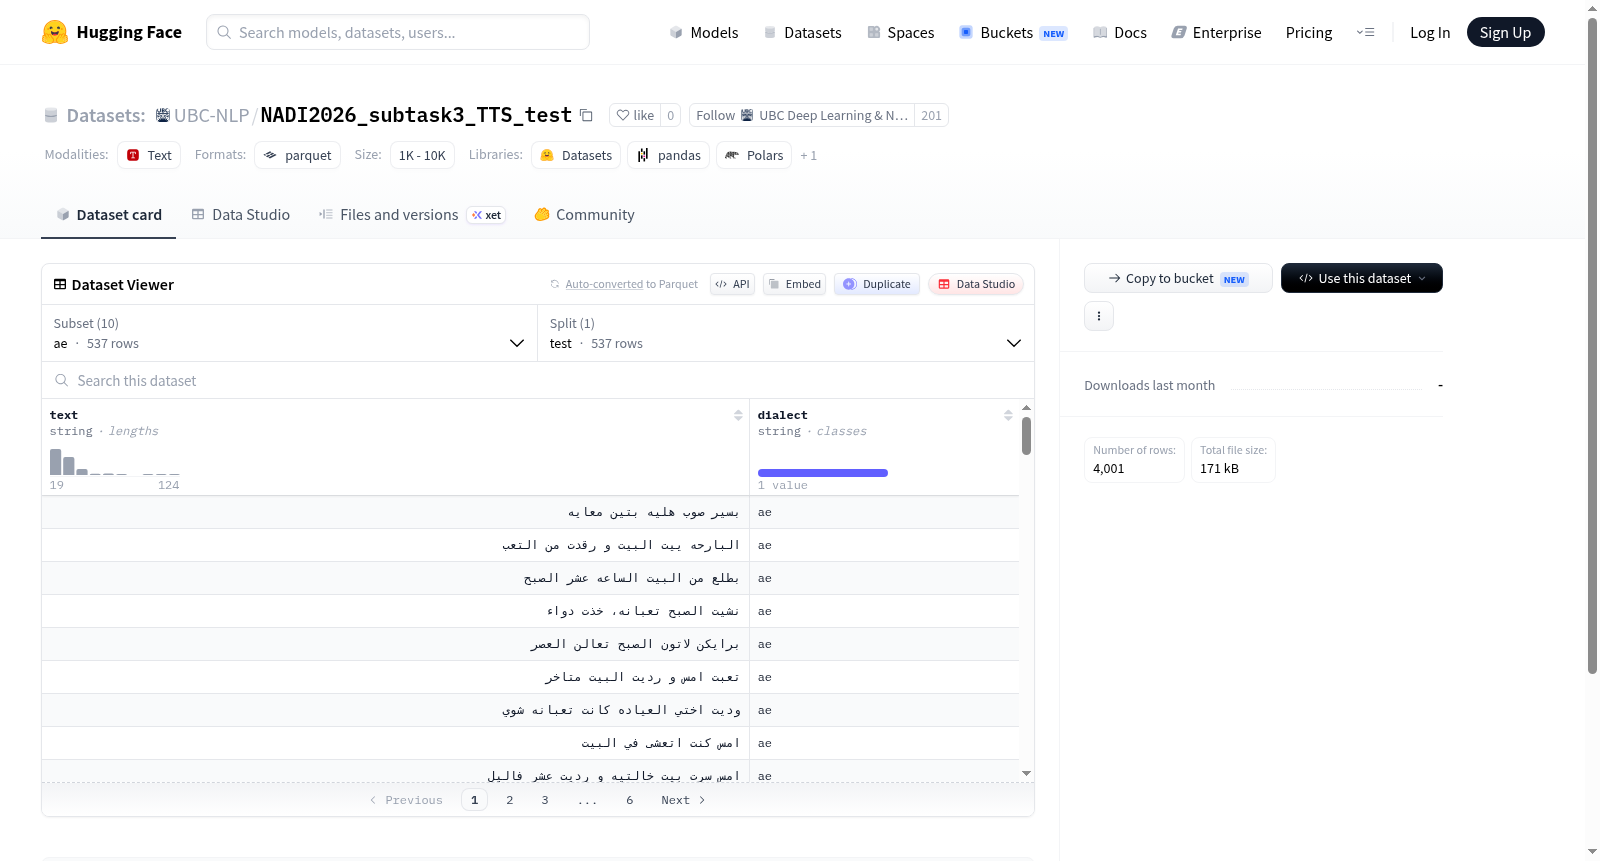
本数据集是一个多方言文本数据集,包含10种不同方言类别(ae、dz、eg、jo、ma、ps、sa、sd、tn、ye)的样本,总规模为4001个文本样本,所有样本仅划分为测试集。每个样本包含text字段存储原始文本内容和dialect字段标注方言类别,适用于方言识别、方言文本分类和方言自然语言处理等任务的研究与评估。

This dataset is a multi-dialect text dataset containing samples from 10 different dialect categories (ae, dz, eg, jo, ma, ps, sa, sd, tn, ye), with a total size of 4001 text samples, all of which are divided only into a test set. Each sample includes two fields: the text field stores the original text content, and the dialect field annotates the dialect category of the text. The dataset is suitable for research and evaluation in tasks such as dialect identification, dialect text classification, and dialect natural language processing.

创建时间:
2026-07-20
原始信息汇总

数据集名称

NADI2026_subtask3_TTS_test

数据集概述

该数据集是NADI2026挑战赛子任务3的测试集,专注于阿拉伯语音频到文本的跨方言任务,包含多个阿拉伯方言的文本和方言标签数据。

数据集结构

  • 特征:每个样本包含两个字段:
    • text(字符串类型):文本内容。
    • dialect(字符串类型):对应的方言标签。
  • 数据划分:仅提供测试集(test)划分。

方言配置与规模

数据集包含10个方言配置,每个配置对应一个独立的测试集文件,具体如下:

配置名称 方言 测试样本数 测试集大小
ae 阿联酋方言 537 39,853 字节
dz 阿尔及利亚方言 293 29,816 字节
eg 埃及方言 424 40,174 字节
jo 约旦方言 631 60,770 字节
ma 摩洛哥方言 201 23,456 字节
ps 巴勒斯坦方言 750 66,539 字节
sa 沙特阿拉伯方言 100 8,072 字节
sd 苏丹方言 114 8,876 字节
tn 突尼斯方言 623 58,645 字节
ye 也门方言 100 31,164 字节

总计:全数据集共包含4,001个测试样本,总数据大小约377,365字节

搜集汇总
数据集介绍
NADI2026_subtask3_TTS_test 数据集图片
构建方式
NADI2026_subtask3_TTS_test数据集是针对阿拉伯语方言文本转语音任务设计的测试集,涵盖了十种阿拉伯语区域变体,包括阿联酋、阿尔及利亚、埃及、约旦、摩洛哥、巴勒斯坦、沙特阿拉伯、苏丹、突尼斯和也门方言。每个方言子集均以独立配置形式组织,存储了文本及其对应的方言标签。数据以test split形式提供,记录了每个方言子集的样本数量和字节大小,便于评估模型在不同方言上的表现。构建过程中,文本数据经过标准化处理,并附带了方言属性标注,确保数据在方言多样性和语言一致性上的平衡。
特点
该数据集的核心特征在于其方言覆盖的广泛性和细粒度标注能力。十个方言子集大小从100到750个样本不等,总样本数超过3800条,为评估多方言TTS模型提供了真实且均衡的测试资源。每个样本均包含纯文本和方言标签两列,简化了数据加载和预处理流程。数据集仅包含测试集,避免了训练/验证泄漏风险,特别适合用于零样本或少样本方言TTS系统的性能评测。此外,不同方言的字长和样本分布差异也反映了各区域方言的实际使用频率和文本复杂性。
使用方法
使用该数据集时,用户可通过HuggingFace Datasets库按方言配置名加载指定子集,例如'ae'或'eg',并指定split为'test'。加载后,数据以字典形式提供'text'和'dialect'字段,可直接作为TTS模型的输入文本和方言条件。建议在评测前确认方言标签与模型支持的方言映射关系,以正确计算各方言的语言相似度或音系特征。数据集不包含音频,需配合外部声码器或声学模型使用。为确保公平比较,建议在所有方言子集上统一评测指标,如MOS或字错误率。
背景与挑战
背景概述
NADI2026_subtask3_TTS_test是由NADI(Nuanced Arabic Dialect Identification)挑战赛组织者于2026年发布的面向阿拉伯语方言文本到语音合成的测试数据集。该数据集汇聚了来自阿拉伯联合酋长国、阿尔及利亚、埃及、约旦、摩洛哥、巴勒斯坦、沙特阿拉伯、苏丹、突尼斯和也门等十个主要阿拉伯语方言区域的文本样本,总计超过4000条语句。核心研究问题在于推动多方言阿拉伯语TTS系统的发展,解决标准阿拉伯语与方言之间巨大的语音和文本差异。该数据集对自然语言处理和语音合成领域具有深远影响,为评估跨方言TTS模型提供了统一的基准测试平台,促进了北非和中东地区方言语音技术的进步。
当前挑战
该数据集所解决的领域问题之一是阿拉伯语方言在语音和文本层面缺乏标准化语料资源,现有TTS系统多集中于现代标准阿拉伯语,难以泛化至日常使用的方言变体。构建过程中面临的挑战包括:各方言区域的语言资料获取困难,需从网络、社交媒体等非结构化来源收集并清洗带有噪声的文本;方言标注一致性的维护,因为同一词汇在不同地区可能有拼写和发音差异;以及确保性别、年龄、语境等社会语言学因素的平衡,以避免生成模型偏向特定群体。此外,小方言样本量(如沙特阿拉伯100条、苏丹114条)与大方言(如巴勒斯坦750条)之间存在显著数量级差异,给模型的无偏训练带来额外困难。
常用场景
经典使用场景
NADI2026_subtask3_TTS_test数据集专为跨方言的文本转语音任务而设计,其核心价值在于覆盖阿拉伯语地区的十种主要方言变体,包括阿联酋、阿尔及利亚、埃及、约旦、摩洛哥、巴勒斯坦、沙特阿拉伯、苏丹、突尼斯和也门方言。每个样本均包含标准化的文本及其对应的方言标签,这使得研究者能够系统性地开发并评估面向低资源方言的语音合成模型。该数据集常被用于训练多方言TTS系统,通过联合建模不同方言的语音特征与语言韵律,实现从文本到流畅自然方言语音的端到端生成。
解决学术问题
该数据集有效回应了阿拉伯语方言语音合成中数据稀缺与方言多样性并存的学术挑战。传统TTS研究多聚焦于现代标准阿拉伯语,而对拥有数亿使用者的地缘方言鲜有涉足。NADI2026_subtask3_TTS_test提供了十个方言区域的标准化测试样本,为研究者构建跨方言发音模型、探索方言间的音位映射与韵律转换机制提供了基准资源。其深远意义在于推动了多方言一语多音现象的量化分析,并催生了方言感知的声学编码方法,从而弥合了方言语音处理与主流自然语言处理技术之间的鸿沟。
衍生相关工作
以NADI2026_subtask3_TTS_test为基石,一系列前沿工作应运而生。研究者基于该数据集提出了方言条件TTS框架,通过引入方言嵌入向量来控制合成语音的地域风格,实现了单一模型对十种方言的灵活切换。另有工作探索了基于元学习的少样本方言语音合成策略,利用数据集中的方言标签进行任务划分,使模型能从少量方言样本中快速适应新方言。此外,该数据集还催生了跨方言语音转换研究,即在不改变语义内容的前提下,将现代标准阿拉伯语语音转换为特定方言的语音输出,为个性化语音交互与方言保护提供了新的技术路径。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务