
遇见数据集

animelover/danbooru2022

收藏
Hugging Face2023-12-04 更新2024-03-04 收录
官方服务:

资源简介:

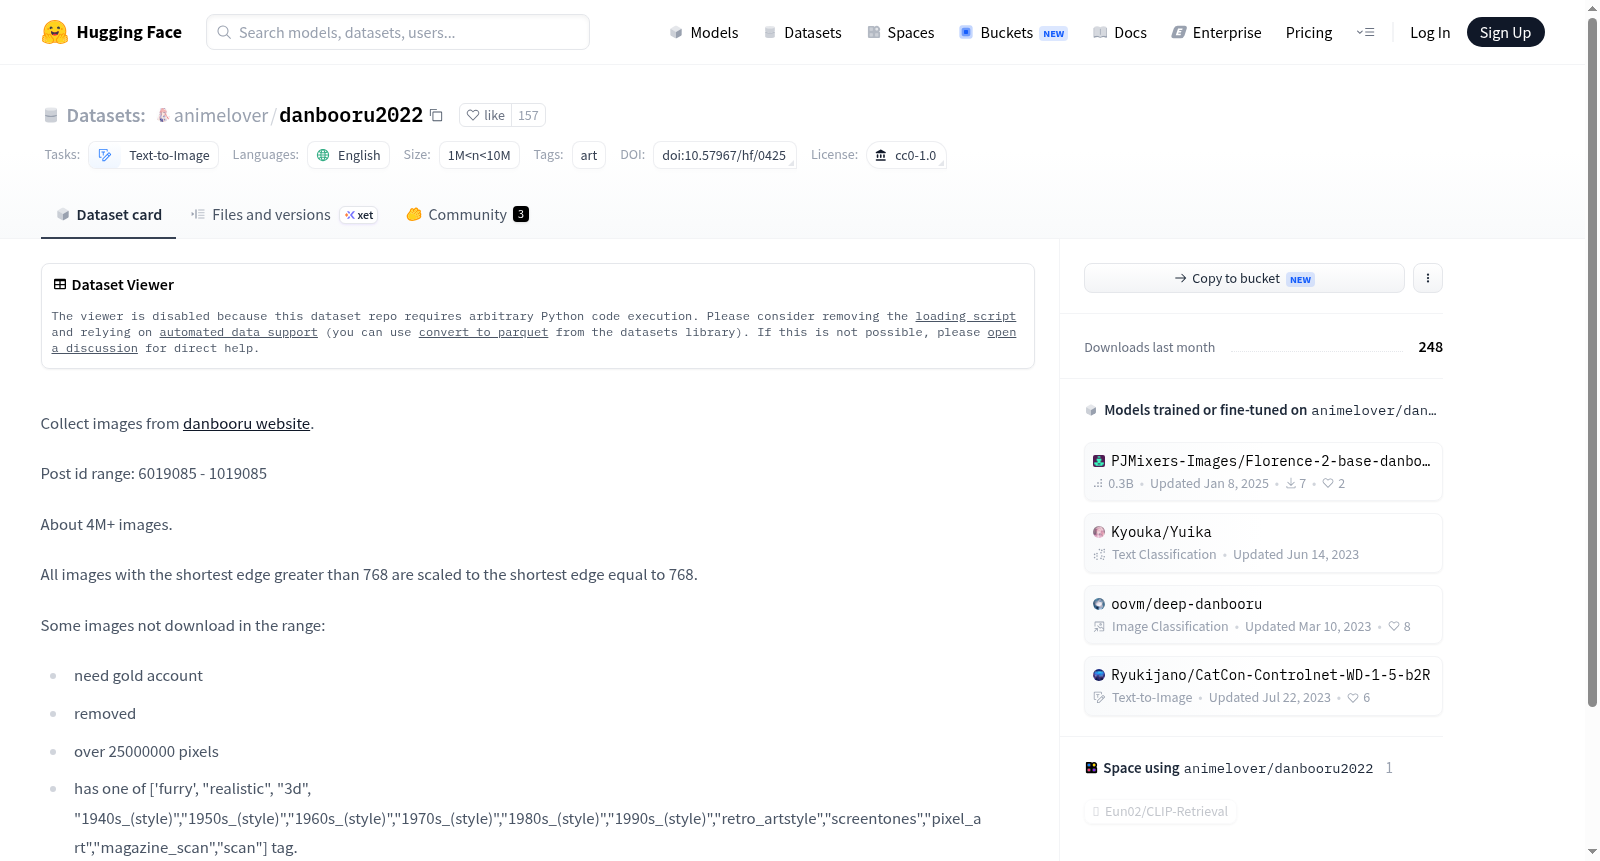
--- license: cc0-1.0 task_categories: - text-to-image language: - en pretty_name: Danbooru 2022 size_categories: - 1M<n<10M tags: - art --- Collect images from [danbooru website](https://danbooru.donmai.us/). Post id range: 6019085 - 1019085 About 4M+ images. All images with the shortest edge greater than 768 are scaled to the shortest edge equal to 768. Some images not download in the range: - need gold account - removed - over 25000000 pixels - has one of ['furry', "realistic", "3d", "1940s_(style)","1950s_(style)","1960s_(style)","1970s_(style)","1980s_(style)","1990s_(style)","retro_artstyle","screentones","pixel_art","magazine_scan","scan"] tag.

许可证:CC0 1.0协议 任务类别:文本到图像生成 语言:英语 展示名称:Danbooru 2022 规模类别:100万 < 样本量 < 1000万 标签:艺术 本数据集采集自Danbooru官方网站(https://danbooru.donmai.us/)。 帖子ID范围:6019085 至 1019085。 数据集共包含超400万张图像。 所有最短边尺寸大于768像素的图像,均被统一缩放至最短边为768像素。 以下范围内的图像无法下载: - 需要黄金会员账户 - 已被移除 - 总像素数超过2500万 - 包含以下任一标签:["兽人(furry)", "写实风格(realistic)", "3D", "1940年代风格(1940s_(style))", "1950年代风格(1950s_(style))", "1960年代风格(1960s_(style))", "1970年代风格(1970s_(style))", "1980年代风格(1980s_(style))", "1990年代风格(1990s_(style))", "复古艺术风格(retro_artstyle)", "网点纸风格(screentones)", "像素艺术(pixel_art)", "杂志扫描件(magazine_scan)", "扫描件(scan)"]

提供机构:
animelover
原始信息汇总

数据集概述

基本信息

  • 许可证: CC0-1.0
  • 任务类别: 文本到图像
  • 语言: 英语
  • 名称: Danbooru 2022
  • 大小: 1M<n<10M
  • 标签: 艺术

数据集详情

  • 来源: 从Danbooru网站收集图像
  • 图像数量: 约400万张
  • 图像处理: 所有短边大于768像素的图像被缩放到短边等于768像素
  • 排除图像:
    • 需要金账户
    • 已移除
    • 超过25000000像素
    • 包含特定标签(如furry, "realistic", "3d", "1940s_(style)"等)
搜集汇总
数据集介绍
animelover/danbooru2022 数据集图片
构建方式
在数字艺术与图像生成领域,高质量、大规模且标注精细的数据集是推动模型性能提升的关键基石。Danbooru 2022数据集源自知名的动漫插画社区Danbooru网站,通过系统性地爬取指定范围内的帖子(ID区间为6019085至1019085),构建了一个包含超过400万张图像的庞大规模集合。为确保数据质量与一致性,所有图像均经过预处理:最短边大于768像素的图像被等比缩放至最短边等于768像素。此外,在采集过程中剔除了需黄金账户访问、已被删除、分辨率超过2500万像素,以及包含特定标签(如毛茸茸、写实、3D、像素艺术等)的图像,从而过滤掉不符合艺术风格或质量要求的样本,最终形成纯净的动漫风格图像数据集。
使用方法
该数据集专为文本到图像生成任务设计,可直接用于训练或微调扩散模型、自回归模型等生成式架构。使用时,用户需加载图像文件及其对应的标签信息,其中标签源自Danbooru社区的标注系统,涵盖了角色、姿势、背景、画风等丰富语义。推荐将图像与标签配对构建训练样本,利用标签作为条件输入,引导模型学习从文本描述到视觉内容的映射关系。由于数据集已进行标准化缩放,无需额外预处理即可直接送入模型。对于需要更高分辨率输出的应用,可在此基础上进行超分辨率微调或后处理。建议采用随机打乱与批量加载策略,以充分利用其大规模优势,提升模型泛化能力。
背景与挑战
背景概述
Danbooru 2022数据集由动漫爱好者社区构建,于2022年发布,主要贡献者来自Danbooru图像托管平台。该数据集聚焦于文本到图像生成任务,收集了约400万张来自Danbooru网站的动漫风格图像,其核心研究问题在于为艺术创作和图像生成模型提供大规模、高质量的标注数据。通过筛选最短边大于768像素的图像并进行统一缩放,确保了图像的视觉一致性。该数据集对动漫领域的人工智能研究具有重要影响力,推动了二次元风格图像生成技术的进步,成为学术界和工业界探索文本引导图像合成的重要资源。
当前挑战
该数据集面临的挑战首先体现在领域问题的解决上:文本到图像生成任务需处理动漫风格的多样性,包括不同画风、角色类型和场景的复杂组合,而Danbooru 2022通过排除furry、realistic等标签,专注于纯二次元风格,但风格泛化能力仍受限于标签系统的覆盖范围。构建过程中,数据采集面临诸多困难,如部分图像需黄金账户权限、已被删除或像素超过2500万,导致约4M+图像中缺失特定ID范围的样本。此外,图像缩放至768像素虽统一尺寸,但可能损失细节,影响高分辨率生成效果。这些挑战制约了数据集在跨领域应用和细粒度控制上的潜力。
常用场景
经典使用场景
Danbooru 2022 数据集作为大规模二次元图像语料库,最经典的用途在于为文本到图像生成模型提供高质量的配对训练数据。其包含超过四百万张经过精心筛选的动漫风格图像,每张图像均附带丰富的英文标签,涵盖了角色、姿势、服装、场景等细粒度语义信息。研究者常利用该数据集训练能够根据自然语言描述精准生成动漫风格图像的条件扩散模型,例如 Stable Diffusion 的微调版本,从而在艺术创作与风格迁移领域实现高度可控的视觉生成。
解决学术问题
该数据集有效解决了动漫图像生成研究中训练数据匮乏且标注不一致的核心难题。通过统一过滤掉包含写实、像素艺术、3D 渲染等非典型动漫风格的内容,并剔除分辨率过高或已删除的样本,确保了数据集的纯净性与一致性。学术研究可借此探索多标签分类与细粒度视觉语义对齐问题,推动对动漫艺术风格的理解与建模,进而提升生成模型在风格保持与细节还原上的表现,为跨模态学习提供了坚实的基准。
实际应用
在实际应用中,Danbooru 2022 数据集被广泛用于构建动漫图像生成工具、角色设计辅助系统以及个性化壁纸与插画生成平台。基于该数据集训练的模型能够理解诸如“金发双马尾少女穿着水手服”之类的复杂描述,并输出符合动漫美学的高质量图像。此外,其标注体系也支持自动标签推荐与图像检索功能,在二次元社区、游戏美术资源生产以及虚拟偶像内容创作中扮演着重要角色,显著降低了专业与非专业人士的艺术创作门槛。
数据集最近研究
最新研究方向
Danbooru 2022数据集作为大规模、高质量动漫风格图像资源,正推动文本到图像生成模型在二次元艺术领域的精细化发展。当前前沿研究方向聚焦于利用其丰富的标签系统与超过400万张图像,训练能够精准理解动漫美学特征(如画风、角色姿势、背景细节)的扩散模型。该数据集与近期AI绘画工具(如Stable Diffusion的动漫微调版本)的爆发式增长紧密相关,成为验证提示词对齐能力和艺术风格迁移效果的核心基准。其CC0许可协议降低了版权壁垒,促进了学术界与创作者社区在可控图像生成、多模态理解等热点课题上的合作,对推动数字艺术创作的民主化与个性化具有重要影响。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

