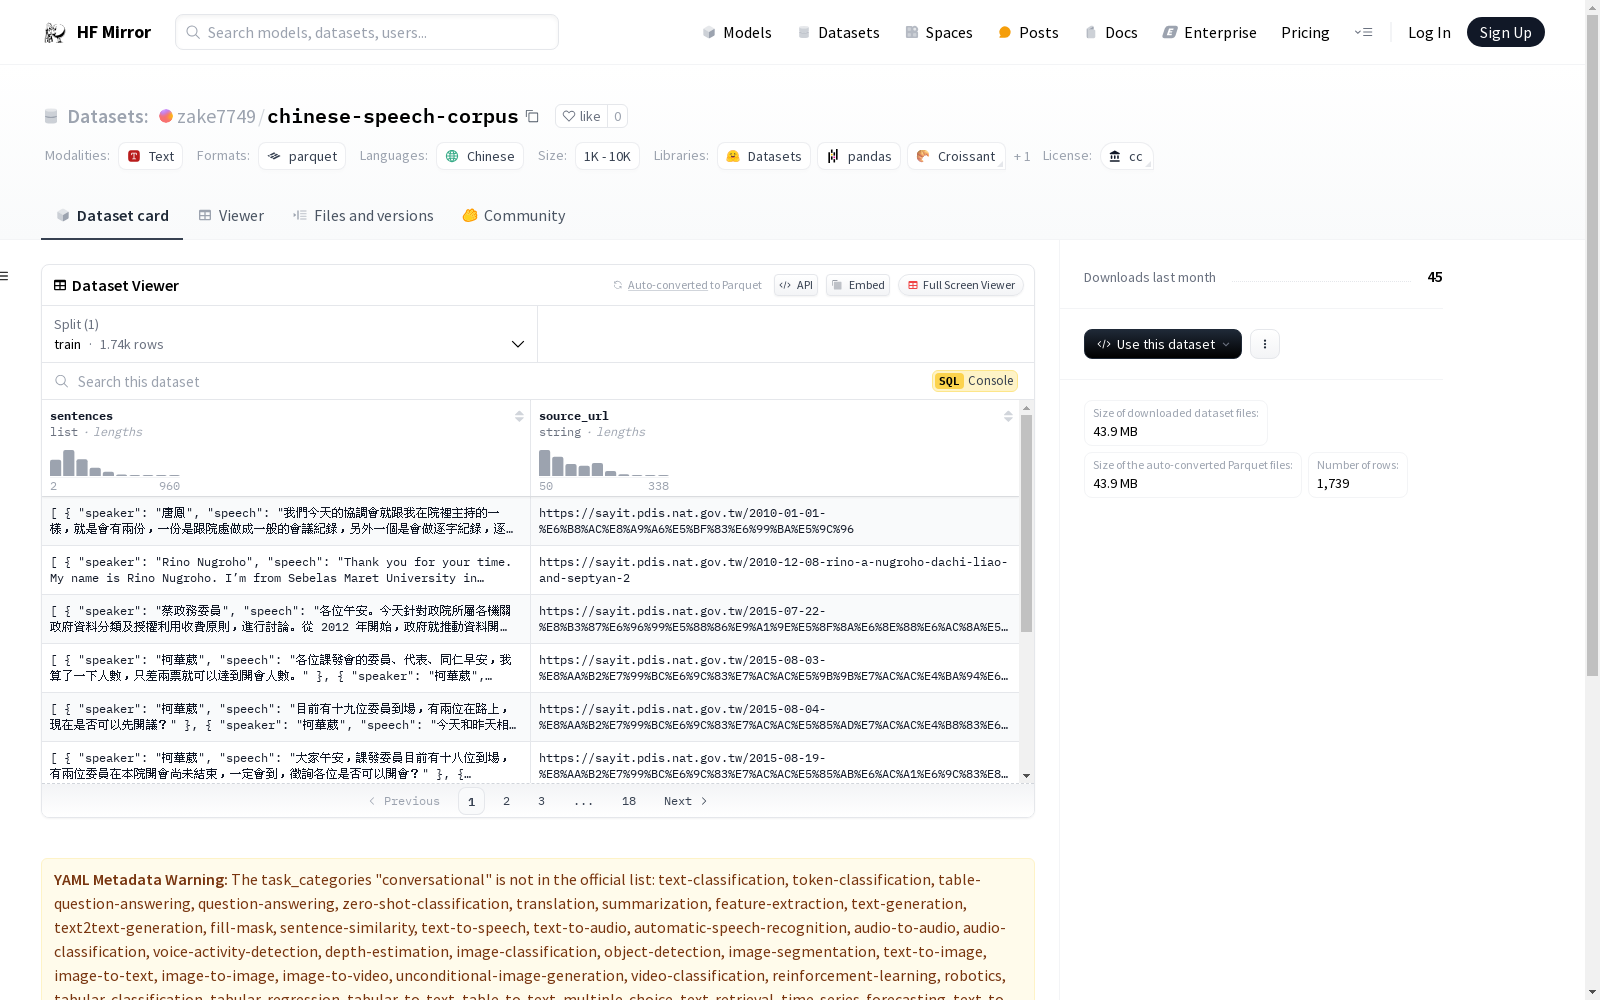
zake7749/chinese-speech-corpus
收藏资源简介:
--- language: - zh license: cc size_categories: - 1K<n<10K task_categories: - conversational dataset_info: features: - name: sentences list: - name: speaker dtype: string - name: speech dtype: string - name: source_url dtype: string splits: - name: train num_bytes: 77964319 num_examples: 1739 download_size: 43895652 dataset_size: 77964319 configs: - config_name: default data_files: - split: train path: data/train-* pretty_name: s --- # Chinese Speech Corpus This dataset has been sourced from [SayIt](https://sayit.pdis.nat.gov.tw/), a specialized website focused on preserving transcripts and meeting notes. Presently, it encompasses a compilation of 1739 dialogues, encompassing approximately 340,000 sentences along with their respective speakers. ## License [CC0 License](https://creativecommons.org/share-your-work/public-domain/cc0/)
语言: - 中文 许可协议:CC 样本规模类别: - 1000 < 样本数 < 10000 任务类别: - 对话式任务 数据集信息: 特征项: - 名称:sentences(语句列表) 子项: - 名称:speaker(说话人),数据类型:字符串 - 名称:speech(发言内容),数据类型:字符串 - 名称:source_url(来源链接),数据类型:字符串 数据划分: - 名称:train(训练集),字节大小:77964319,样本数量:1739 下载大小:43895652字节 数据集总大小:77964319字节 配置项: - 配置名称:default(默认配置) 数据文件: - 划分集:train(训练集) 文件路径:data/train-* 显示名称:s # 中文语音语料库 本数据集源自[SayIt](https://sayit.pdis.nat.gov.tw/),这是一家专注于保存会议纪要与对话转写文本的专业网站。目前,该数据集共收录1739段对话,包含约340000条语句及其对应的说话人信息。 ## 许可协议 [CC0协议](https://creativecommons.org/share-your-work/public-domain/cc0/)
中文对话语料库
数据集概述
- 语言: 中文
- 许可: CC
- 数据规模: 1K<n<10K
- 任务类别: 对话
数据集信息
- 特征:
- 句子:
- 说话者: 字符串类型
- 发言内容: 字符串类型
- 来源URL: 字符串类型
- 句子:
- 分割:
- 训练集:
- 字节数: 77964319
- 样本数: 1739
- 训练集:
- 下载大小: 43895652
- 数据集大小: 77964319
配置
- 默认配置:
- 数据文件:
- 分割: 训练
- 路径: data/train-*
- 数据文件:
数据集来源
该数据集来自SayIt,一个专注于保存会议记录和对话的网站。目前包含1739个对话,约340,000个句子及其对应的说话者。
许可