RaymondLi/perturbed_humaneval
收藏资源简介:
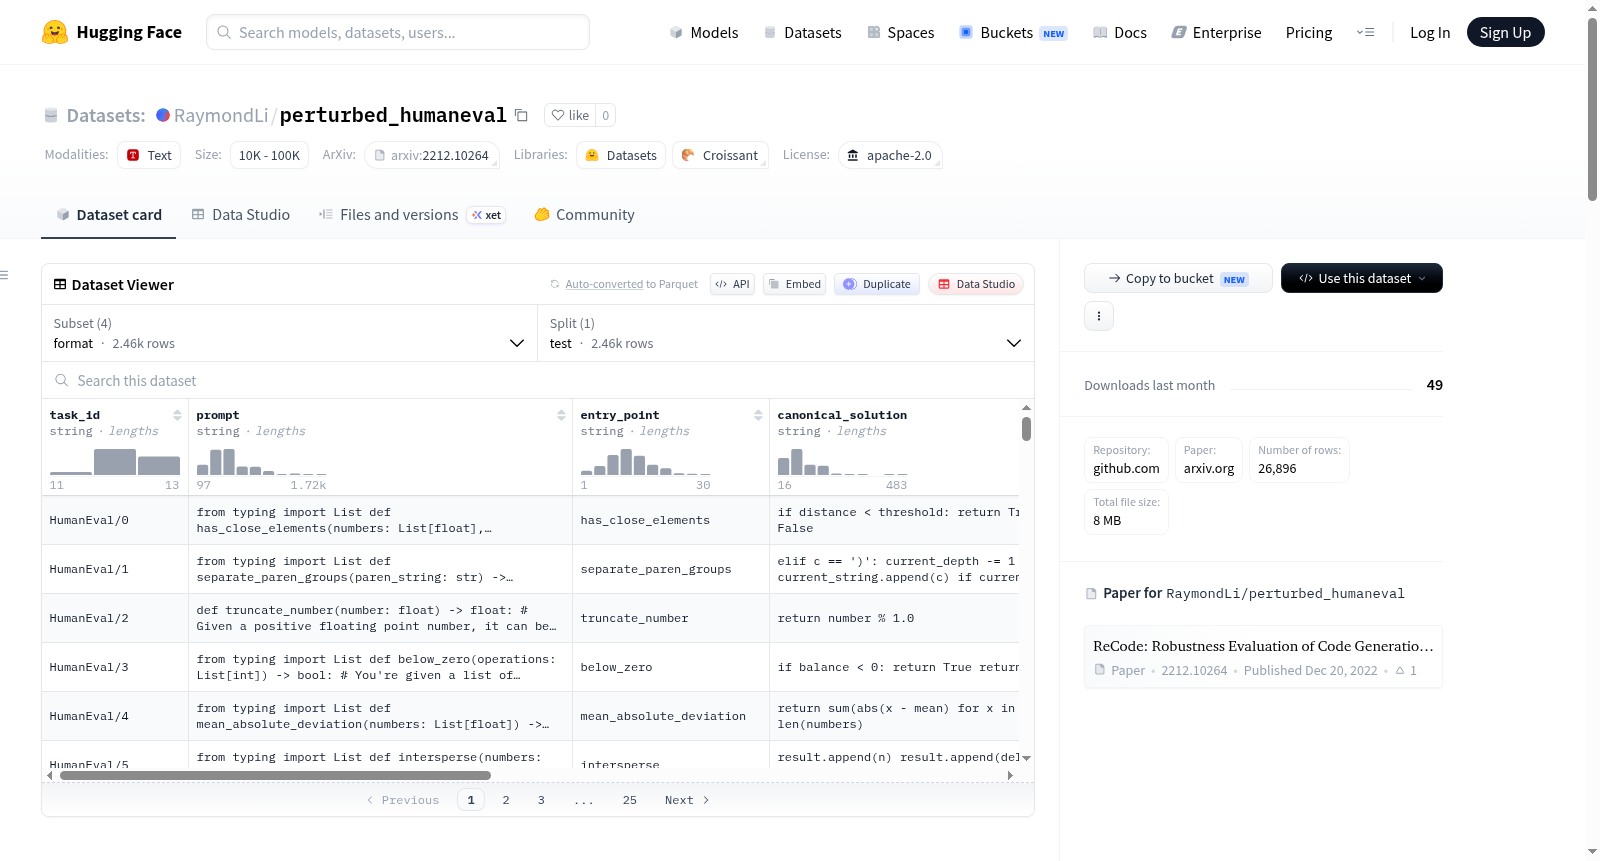
--- license: apache-2.0 --- # Dataset Card for Dataset Name ## Dataset Description - **Repository:** https://github.com/amazon-science/recode/tree/main - **Paper:** https://arxiv.org/abs/2212.10264 ### Dataset Summary The Recode benchmark proposes to apply code and natural language transformations to code-generation benchmarks to evaluate the robustness of code-generation models. This dataset contains the perturbed version of HumanEval that they released. It was automatically generated from the [HumanEval](https://huggingface.co/datasets/openai_humaneval) dataset. ### Subsets There are four transformation categories that form the subsets of this dataset: `func_name`, `nlaugmenter`, `natgen` and `format`. ### Languages The programming problems are written in Python and contains docstrings and comments in English. ## Dataset Structure ### Data Instances [More Information Needed] ### Data Fields - `task_id`: ID of the original HumanEval example - `prompt`: the perturbed prompt - `entry_point`: entry point for test - `canonical_solution`: solution for the problem in the `prompt` - `test`: contains function to test generated code for correctness - `seed`: seed of the perturbed prompt - `perturbation_name`: name of the perturbation - `partial`: partial solution to the problem. This field is only present for transformation categories that affect a partial solution: `natgen` and `format`. ### Data Splits The dataset only has a test split. ## Dataset Creation ### Curation Rationale [More Information Needed] ### Source Data #### Initial Data Collection and Normalization [More Information Needed] #### Who are the source language producers? [More Information Needed] ### Annotations #### Annotation process [More Information Needed] #### Who are the annotators? [More Information Needed] ### Personal and Sensitive Information [More Information Needed] ## Considerations for Using the Data ### Social Impact of Dataset [More Information Needed] ### Discussion of Biases [More Information Needed] ### Other Known Limitations [More Information Needed] ## Additional Information ### Dataset Curators [More Information Needed] ### Licensing Information [More Information Needed] ### Citation Information ``` @article{wang2022recode, title={ReCode: Robustness Evaluation of Code Generation Models}, author={Wang, Shiqi and Li, Zheng and Qian, Haifeng and Yang, Chenghao and Wang, Zijian and Shang, Mingyue and Kumar, Varun and Tan, Samson and Ray, Baishakhi and Bhatia, Parminder and others}, journal={arXiv preprint arXiv:2212.10264}, year={2022} } ``` ### Contributions [More Information Needed]
---许可证:Apache-2.0--- # 数据集卡片:Recode ## 数据集描述 - **代码仓库:** https://github.com/amazon-science/recode/tree/main - **相关论文:** https://arxiv.org/abs/2212.10264 ### 数据集概述 Recode基准测试旨在通过对代码生成基准测试集施加代码与自然语言变换,以评估代码生成模型的鲁棒性。本数据集包含其发布的经过扰动处理的HumanEval版本,该数据集自动源自[HumanEval](https://huggingface.co/datasets/openai_humaneval)数据集。 ### 数据集子集 本数据集包含四类变换类别作为其子集:`func_name`、`nlaugmenter`、`natgen` 与 `format`。 ### 语言说明 本数据集的编程问题采用Python编写,且包含英文的文档字符串与注释。 ## 数据集结构 ### 数据实例 [需补充更多信息] ### 数据字段 - `task_id`:原始HumanEval示例的唯一标识符 - `prompt`:经过扰动处理的提示文本 - `entry_point`:测试用例的入口点 - `canonical_solution`:对应`prompt`中问题的标准解决方案 - `test`:包含用于验证生成代码正确性的测试函数 - `seed`:生成该扰动提示文本的随机种子 - `perturbation_name`:所使用的扰动方法名称 - `partial`:该问题的部分解决方案。该字段仅在扰动类别为`natgen`与`format`时存在。 ### 数据划分 本数据集仅包含测试划分。 ## 数据集构建 ### 筛选逻辑 [需补充更多信息] ### 源数据 #### 原始数据收集与标准化 [需补充更多信息] #### 原始文本创作者 [需补充更多信息] ### 标注信息 #### 标注流程 [需补充更多信息] #### 标注人员 [需补充更多信息] ### 个人与敏感信息 [需补充更多信息] ## 数据使用注意事项 ### 数据集的社会影响 [需补充更多信息] ### 偏差分析 [需补充更多信息] ### 其他已知局限性 [需补充更多信息] ## 附加信息 ### 数据集整理者 [需补充更多信息] ### 许可证信息 [需补充更多信息] ### 引用信息 @article{wang2022recode, title={ReCode: Robustness Evaluation of Code Generation Models}, author={Wang, Shiqi and Li, Zheng and Qian, Haifeng and Yang, Chenghao and Wang, Zijian and Shang, Mingyue and Kumar, Varun and Tan, Samson and Ray, Baishakhi and Bhatia, Parminder and others}, journal={arXiv preprint arXiv:2212.10264}, year={2022} } ### 贡献情况 [需补充更多信息]
数据集概述
数据集描述
- 名称: Recode Benchmark
- 目的: 评估代码生成模型的鲁棒性
- 来源: 自动生成的扰动版本HumanEval数据集
- 语言: Python编程语言,包含英文的docstrings和comments
数据集结构
数据字段
task_id: 原始HumanEval示例的IDprompt: 扰动后的提示entry_point: 测试入口点canonical_solution: 问题的解决方案test: 用于测试生成代码正确性的函数seed: 扰动提示的种子perturbation_name: 扰动名称partial: 问题的部分解决方案(仅在natgen和format类别中存在)
数据分割
- 分割: 仅包含测试集
数据集创建
数据集子集
- 子集: 四个变换类别:
func_name,nlaugmenter,natgen,format
数据来源
- 原始数据: HumanEval数据集
- 扰动生成: 自动生成
许可证
- 许可证: Apache-2.0