SWE-agent-trajectories
收藏资源简介:
该数据集包含由软件工程代理基于SWE-agent框架生成的80,036个轨迹,使用各种模型作为动作生成器。这些轨迹用于解决来自[nebius/SWE-bench-extra](https://huggingface.co/datasets/nebius/SWE-bench-extra)和[princeton-nlp/SWE-bench](https://huggingface.co/datasets/princeton-nlp/SWE-bench)的dev分割的GitHub问题。数据集的创建是为了研究开发使用开放权重模型的软件工程代理,并在SWE-bench Verified基准测试中取得了40.6%的分数。数据集的收集分为两个阶段:收集问题解决实例和生成大量轨迹以解决收集到的问题。生成的代码补丁通过链接的拉取请求中的测试进行评估,以确定哪些补丁通过了测试。数据集的结构包括多个字段,如实例ID、模型名称、目标、轨迹、退出状态、生成的补丁和评估日志。数据集的统计信息涵盖了问题解决和补丁编辑的关键统计数据,如步骤数、上下文长度、编辑细节、退出率和正确性指标。
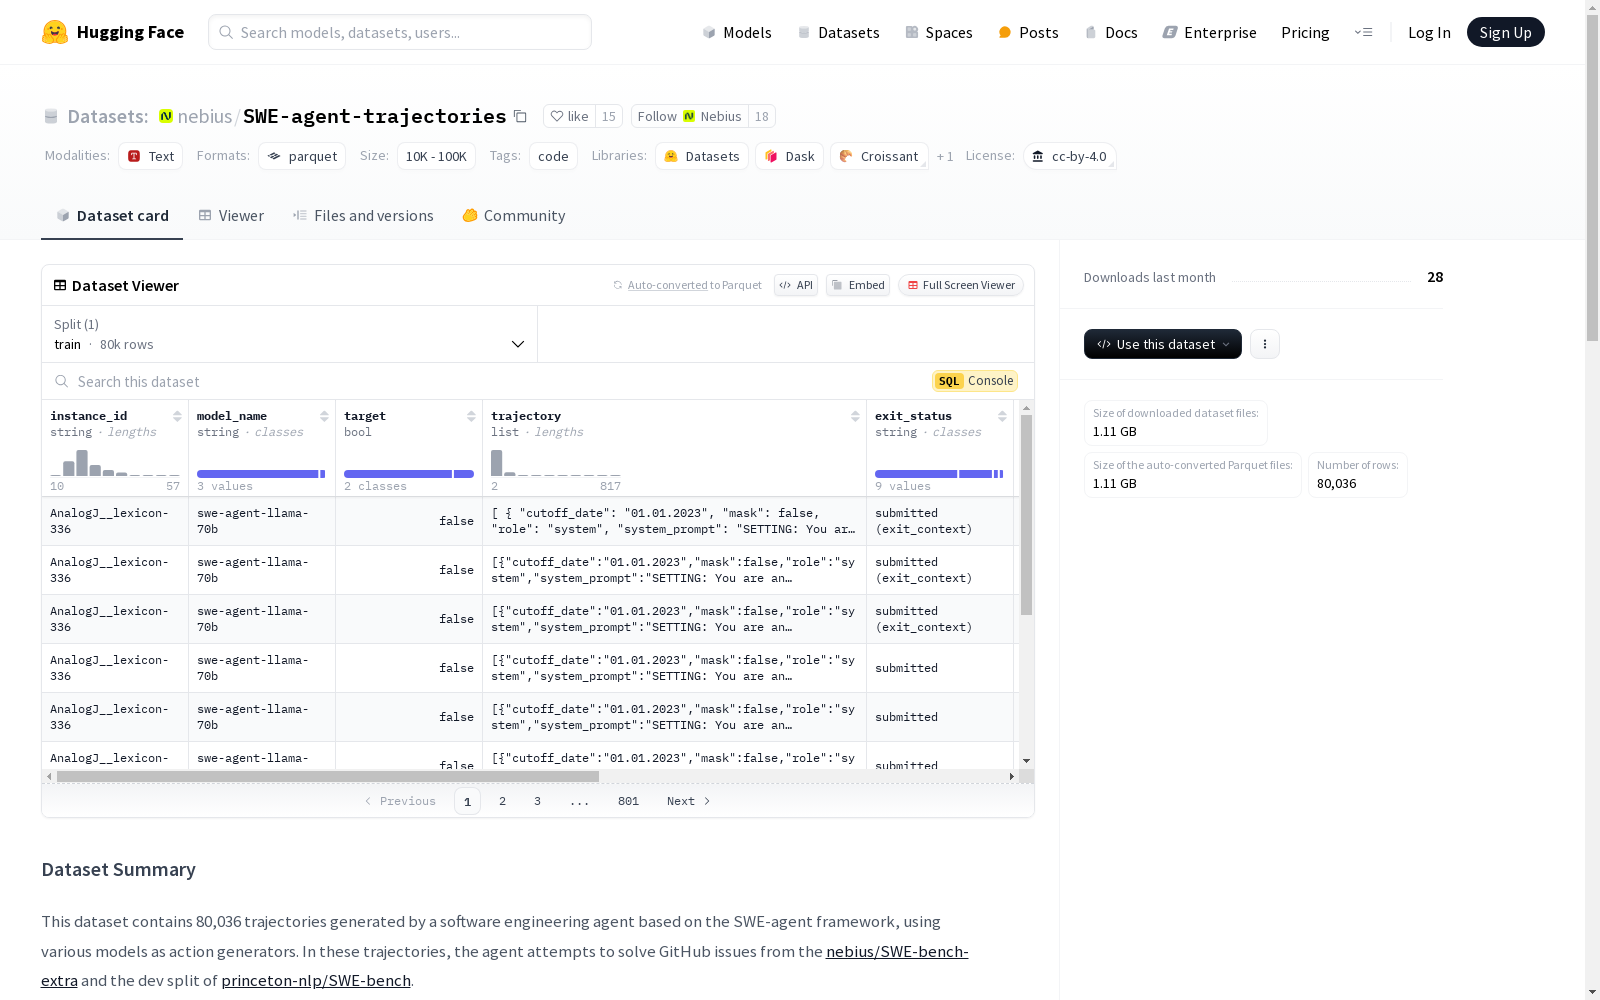
This dataset contains 80,036 trajectories generated by software engineering agents based on the SWE-agent framework, with various models acting as action generators. These trajectories are used to resolve GitHub issues from the dev splits of [nebius/SWE-bench-extra](https://huggingface.co/datasets/nebius/SWE-bench-extra) and [princeton-nlp/SWE-bench](https://huggingface.co/datasets/princeton-nlp/SWE-bench). This dataset was created to research software engineering agents that utilize open-weight models, and achieved a score of 40.6% on the SWE-bench Verified benchmark. The dataset collection process is divided into two stages: collecting problem-solving instances and generating a large number of trajectories to solve the collected issues. Generated code patches are evaluated via tests in the linked pull requests to identify which patches pass the tests. The dataset structure includes multiple fields such as instance ID, model name, target, trajectory, exit status, generated patch, and evaluation logs. The dataset's statistics cover key metrics for problem-solving and patch editing, including step count, context length, editing details, exit rate, and correctness metrics.
数据集概述
该数据集包含80,036条轨迹,这些轨迹由基于SWE-agent框架的软件工程代理生成,使用各种模型作为动作生成器。代理尝试解决来自nebius/SWE-bench-extra和princeton-nlp/SWE-bench的dev分区的GitHub问题。
数据集描述
该数据集是为一个研究项目创建的,该项目专注于开发使用开放权重模型的软件工程代理,该代理在SWE-bench Verified基准测试中获得了40.6%的分数。数据集的收集包括两个阶段:收集问题解决实例,类似于SWE-bench的方法,并生成大量轨迹以解决收集的问题。生成的代码补丁通过链接的拉取请求中的测试进行评估,以确定哪些补丁通过了测试。
数据集统计
关键统计数据包括问题解决和补丁编辑的步骤、上下文长度、编辑细节、退出率和正确性指标,汇总了80,036个实例。
| 问题已解决 | 问题未解决 | ||
|---|---|---|---|
| 轨迹 | 平均步骤数 | 31.3 | 58.4 |
| 平均上下文长度(Llama 3 tokenizer) | 8,352.4 | 15,241 | |
| 最终补丁 | 编辑的文件数 | 1.33 | 2.17 |
| 编辑的行数 | 20.7 | 61.0 | |
| 退出状态率(按目标分组) | 提交 | 94.6% | 57.6% |
| 退出上下文 | 5.31% | 30.4% | |
| 其他 | 0.37% | 12% | |
| 正确步骤 | 至少打开一个正确文件 | 83% | 40% |
| 总计 | 实例数 | 13,389 | 66,647 |
数据集结构
代理的轨迹包括以下信息:
| 字段名 | 类型 | 描述 |
|---|---|---|
| instance_id | str | 代理尝试解决的问题实例的标识符,由仓库名称和问题编号组成。 |
| model_name | str | 用于生成轨迹的模型名称。 |
| target | bool | 模型是否在此轨迹中解决了问题。 |
| trajectory | str | 包含模型推理和动作(角色:ai)以及环境观察(角色:user)的JSON列表。第一个条目是系统提示(角色:system)。 |
| exit_status | str | 代理完成的状态。 |
| generated_patch | str | 模型在修改项目文件时生成的最终补丁。 |
| eval_logs | str | 用于验证最终补丁的测试执行日志。 |
许可证
该数据集根据Creative Commons Attribution 4.0许可证授权。请尊重每个特定仓库的许可证,每个实例的仓库许可证在SWE-bench-extra中提供。
此外,用户须知:如果您打算使用这些模型的输出,您必须遵守Llama 3.1许可证。