
unigram/longlogic
收藏官方服务:
资源简介:
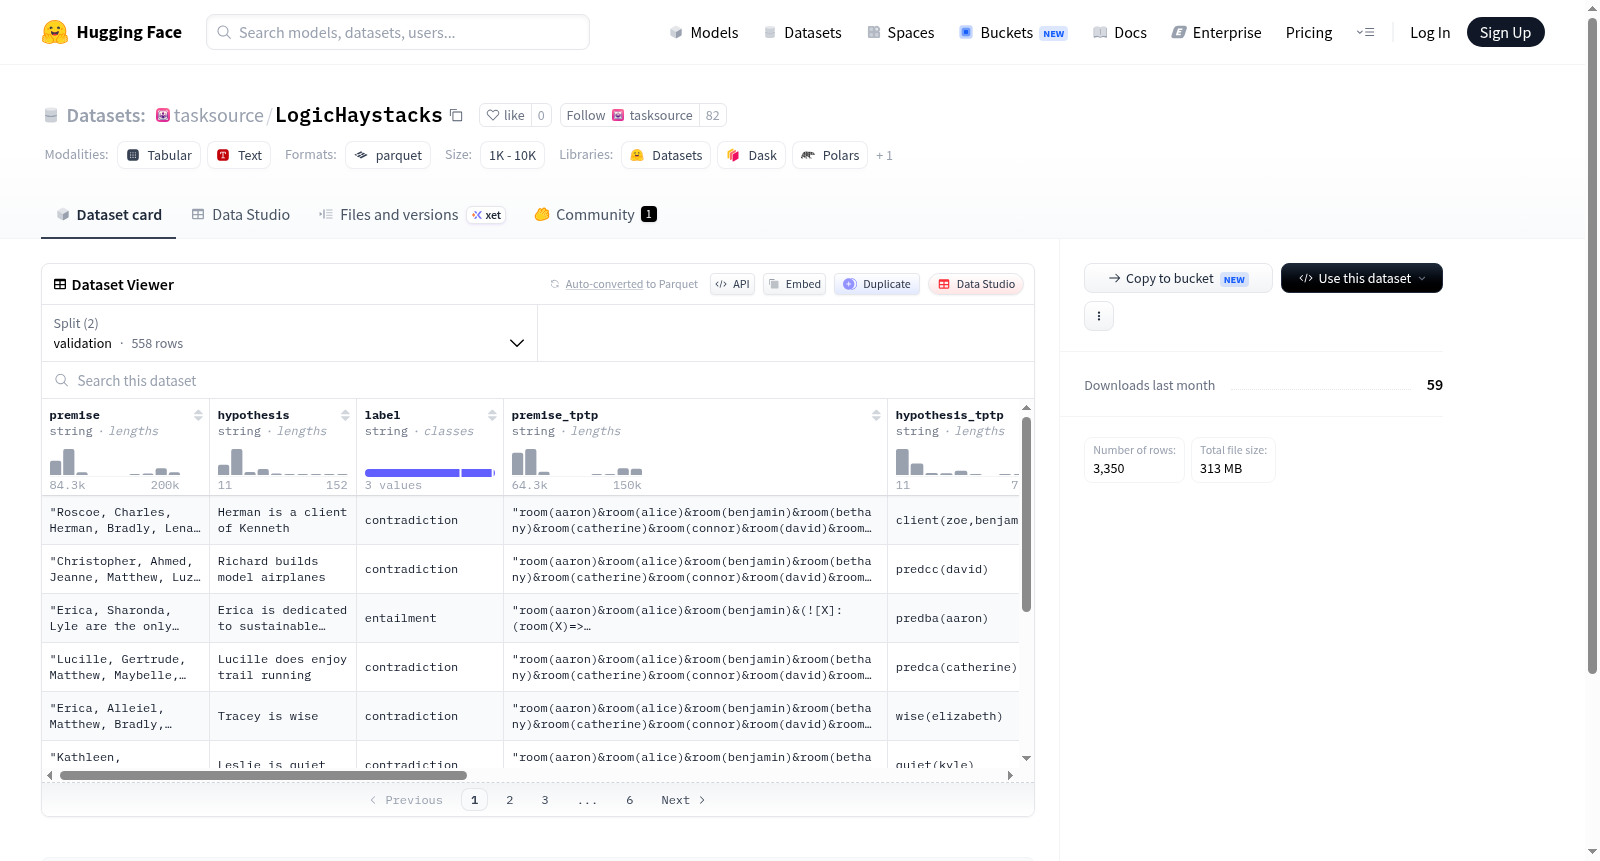
该数据集包含多个特征,如前提(premise)、假设(hypothesis)、标签(label)等,主要用于逻辑推理任务。数据集分为训练集、验证集和测试集,分别包含7533、942和942个样本。数据集的下载大小为108355596字节,总大小为921448804.9999999字节。
The dataset contains multiple features such as premise, hypothesis, label, etc., primarily used for logical reasoning tasks. The dataset is divided into training, validation, and test sets, containing 7533, 942, and 942 samples respectively. The download size of the dataset is 108355596 bytes, and the total size is 921448804.9999999 bytes.
提供机构:
unigram原始信息汇总
数据集概述
数据集特征
- premise: 类型为字符串
- hypothesis: 类型为字符串
- label: 类型为字符串
- premise_tptp: 类型为字符串
- hypothesis_tptp: 类型为字符串
- proof_inputs: 类型为字符串序列
- proof: 类型为字符串
- tc: 类型为整数(int64)
- tck: 类型为整数(int64)
数据集分割
- train: 包含7533个样本,大小为737100334.2959541字节
- validation: 包含942个样本,大小为92174235.35202293字节
- test: 包含942个样本,大小为92174235.35202293字节
数据集大小
- 下载大小: 108355596字节
- 总数据集大小: 921448804.9999999字节
配置
- config_name: default
- data_files:
- train: 路径为
data/train-* - validation: 路径为
data/validation-* - test: 路径为
data/test-*
- train: 路径为
- data_files:
搜集汇总
数据集介绍
构建方式
在自然语言推理领域,longlogic数据集致力于解决长距离逻辑推理这一挑战性问题。该数据集通过精心设计,将前提(premise)与假设(hypothesis)以字符串形式呈现,并利用TPTP(Thousands of Problems for Theorem Provers)格式分别标注其逻辑表达形式(premise_tptp与hypothesis_tptp)。每个样本均包含完整的证明过程(proof)及证明输入(proof_inputs),后者以序列形式存储。为增强推理的鲁棒性,数据集引入了反事实样本(counterfactuals)与证据必要性标记(evidences_necessity),并利用evidence_indices索引关键证据。此外,映射字段(mapping)记录了逻辑结构间的对应关系,而n与ni则分别表示推理步数与迭代次数,确保构建过程具备严谨的数学基础。
使用方法
使用longlogic数据集时,研究者可直接通过HuggingFace加载默认配置,其中test与validation分片已预先划分。每条数据包含前提、假设及其逻辑形式,适用于构建和评估自然语言推理模型。利用proof_inputs与proof字段,可训练模型生成逐步推理过程,或通过evidence_indices验证模型证据选择的准确性。反事实样本与必要性标记可用于因果推理任务,而mapping字段则支持语义对齐分析。建议在微调预训练语言模型时,将premise与hypothesis作为输入,label作为分类目标,并利用TPTP格式增强逻辑监督。对于高级应用,可设计多任务学习框架,同时预测标签、生成证明及识别必要证据,以全面提升模型的逻辑推理能力。
背景与挑战
背景概述
在自然语言推理与形式逻辑交叉研究的浪潮中,LongLogic数据集应运而生,由Unigram团队于近年精心构建。该数据集聚焦于长篇逻辑推理任务,旨在弥合自然语言理解与形式化证明之间的鸿沟。其核心研究问题在于:如何使机器在复杂、多步骤的推理过程中,不仅能够判断前提与假设的蕴含关系,还能生成可验证的符号化证明。数据集包含近3000个测试样本和500余个验证样本,每项样本均配备了TPTP格式的逻辑表述、完整证明步骤及反事实证据,为深度学习模型在逻辑严谨性上的评估提供了前所未有的标杆。这一资源的发布,显著推动了可解释人工智能与形式推理系统的研究进展,尤其在需要长程依赖与因果推理的场景中,成为衡量模型逻辑能力的关键基准。
当前挑战
LongLogic数据集所面临的挑战主要源于两大维度。在领域问题层面,其核心难点在于解决长序列逻辑推理的连贯性与正确性——传统自然语言推理模型往往在超过数步的推理链条中丢失上下文或产生谬误,而该数据集要求模型必须生成完整的、可校验的符号证明,这远超出简单分类任务的难度。在构建过程中,挑战则体现为数据标注的复杂性与一致性:每一条样本都需要专家手工将自然语言转化为TPTP格式,并确保证明步骤的无歧义性与反事实证据的合理性,这一过程耗时且极易引入主观偏差。此外,数据集规模的有限性使得模型难以充分学习逻辑模式,而证明输入序列的长度差异(从简短到数十步)进一步加剧了训练与评估的难度,对模型的泛化能力构成了严峻考验。
常用场景
经典使用场景
在自然语言推理与形式化验证的交汇领域,LongLogic数据集以其独特的结构为长链条逻辑推理研究提供了标杆性资源。该数据集包含前提与假设的成对文本,并辅以TPTP(Thousands of Problems for Theorem Provers)格式的严格形式化表达,使得研究者能够探索从自然语言到符号逻辑的映射能力。其经典使用场景集中于评估和训练模型在复杂、多步推理任务中的表现,尤其关注需要跨越多个证据片段才能得出正确结论的深层逻辑链条。通过引入反事实样本和必要性证据标注,该数据集还允许对推理路径的鲁棒性与可解释性进行系统剖析,从而推动了神经符号系统在长程依赖推理领域的基准测试发展。
解决学术问题
LongLogic数据集着力解决当前自然语言推理研究中长期存在的浅层匹配与表面语义依赖困境。传统数据集多聚焦于单步或短程推理,难以评估模型对多步骤逻辑推导的泛化能力。该数据集通过精心构造的样本,迫使模型必须整合多个证据片段、排除干扰信息,并遵循严格的演绎规则,从而暴露了现有模型在形式化推理上的结构性缺陷。其引入的证明输入与必要性验证机制,为探究推理过程中的信息冗余与因果必要性提供了量化工具,推动了可解释性推理与反事实分析在学术界的深入讨论,并促使研究者重新审视语言模型在逻辑完备性上的根本局限。
实际应用
在实际应用层面,LongLogic数据集所承载的长链条推理能力对智能文档审阅、法律条文解释及科学文献验证等场景具有直接赋能作用。例如,在合同合规性检查中,模型需跨越多个条款进行逻辑一致性校验;在临床诊断支持系统中,需综合多项检查结果与病史信息推导合理结论。该数据集提供的TPTP形式化标注,能够帮助构建从非结构化文本到可验证逻辑表达的转换管线,从而服务于自动化定理辅助证明、教育领域中的逻辑思维训练系统,以及需要严格因果推理的决策支持平台。其反事实样本设计还能有效提升系统在异常输入下的容错与纠偏能力。
数据集最近研究
最新研究方向
在自然语言推理与形式化逻辑验证的交叉前沿,LongLogic数据集通过引入TPTP格式的定理证明表示及完整证明链,为神经符号推理研究开辟了新路径。该数据集聚焦于长程逻辑推导的精确性评估,其核心创新在于将自然语言前提与假设映射为可机械验证的证明输入,并配套构建了反事实样本与证据必要性标注。这一设计直指当前大语言模型在复杂逻辑链条上易产生幻觉的痛点,尤其与近期关于AI形式化数学推理、可解释性证明生成等热点事件紧密关联。通过提供2792条测试样本及配套证明结构,LongLogic不仅为评估模型的多步演绎推理能力设立基准,更推动了从直觉式语言理解向可追溯逻辑推理范式的跃迁,对智能系统在法律论证、科学发现等需严格合规领域的可靠部署具有里程碑意义。
以上内容由遇见数据集搜集并总结生成


