
llama3_non_delete_rr40k_3ep_dpo_gen_augmath_1_type1
收藏数据链接:
官方服务:
资源简介:
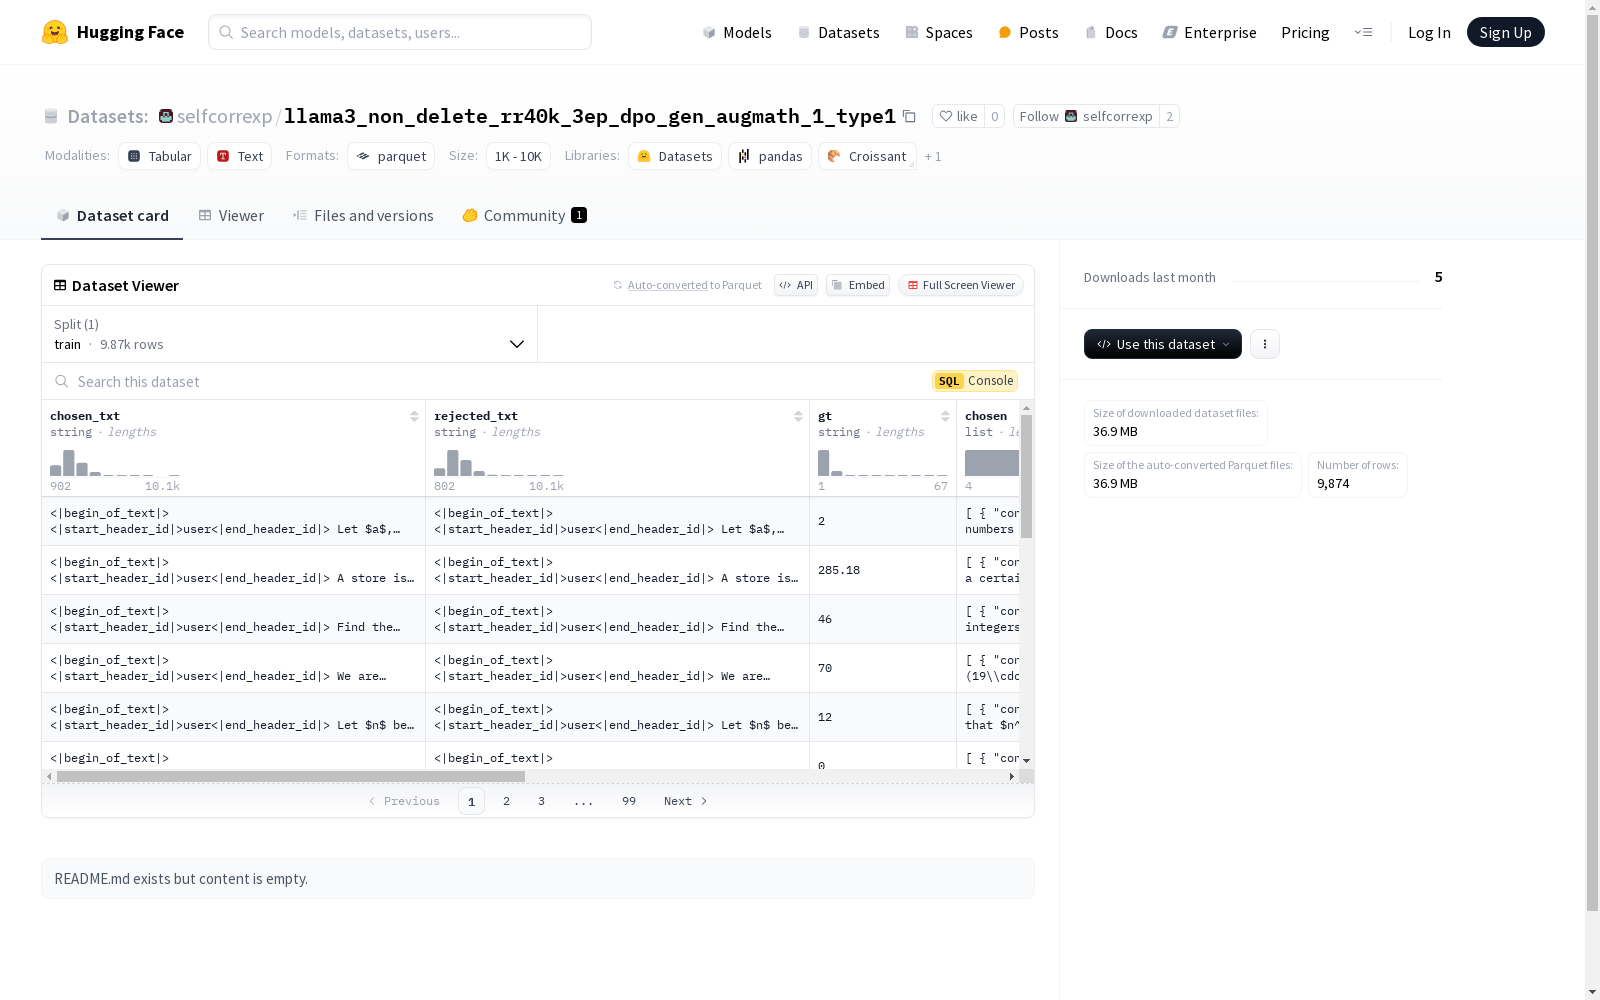
该数据集包含多个文本特征,主要用于比较和选择文本。每个样本包含被选中的文本(chosen_txt)、被拒绝的文本(rejected_txt)、真实标签(gt)、被选中的对话内容(chosen)、被拒绝的对话内容(rejected)、被选中的对话轮次(chosen_turn)和被拒绝的对话轮次(rejected_turn)。其中,'chosen'和'rejected'是列表类型,每个列表包含'content'(内容)和'role'(角色)两个字段。数据集分为训练集,包含9874个样本,总大小为98119311.67890555字节。
创建时间:
2025-01-10
搜集汇总
数据集介绍
构建方式
llama3_non_delete_rr40k_3ep_dpo_gen_augmath_1_type1数据集的构建基于对话偏好优化(DPO)技术,通过生成式增强方法对数学领域的数据进行扩展。该数据集包含了9874个训练样本,每个样本由chosen_txt和rejected_txt两个文本字段组成,分别代表模型选择的文本和被拒绝的文本。此外,每个样本还包含gt字段,用于存储真实答案,以及chosen和rejected两个列表,分别记录了对话中的内容和角色信息。数据集的构建过程注重对话的多样性和数学问题的复杂性,确保了数据的丰富性和实用性。
使用方法
使用llama3_non_delete_rr40k_3ep_dpo_gen_augmath_1_type1数据集时,研究人员可以通过对比chosen_txt和rejected_txt,分析模型在生成数学相关文本时的偏好和偏差。gt字段可用于评估模型的生成准确性,而chosen和rejected字段则提供了对话的上下文信息,有助于进一步优化模型的对话生成能力。数据集适用于训练和评估基于对话偏好优化的模型,特别是在数学领域的应用场景中,能够有效提升模型的生成质量和对话交互的自然性。
背景与挑战
背景概述
llama3_non_delete_rr40k_3ep_dpo_gen_augmath_1_type1数据集是一个专注于对话生成与优化的数据集,旨在通过对比学习的方式提升模型在生成任务中的表现。该数据集由多个对话对组成,每个对话对包含被选择的对话(chosen_txt)和被拒绝的对话(rejected_txt),以及对应的真实标签(gt)。通过这种方式,数据集为模型提供了明确的优化方向,帮助其在生成任务中更好地理解上下文并生成更符合预期的内容。该数据集的构建反映了近年来对话生成领域对模型优化和对比学习方法的重视,尤其是在多轮对话和复杂上下文场景下的应用。
当前挑战
该数据集在解决对话生成任务时面临的主要挑战包括如何有效区分被选择与被拒绝的对话,以及如何在多轮对话中保持上下文的一致性。由于对话生成任务本身具有高度的复杂性和多样性,模型需要具备强大的上下文理解能力,以确保生成的对话不仅符合语法规则,还能在语义上与上下文保持一致。此外,数据集的构建过程中也面临挑战,例如如何确保被选择与被拒绝的对话对具有足够的区分度,以及如何在大规模数据中保持标注的一致性和准确性。这些挑战对数据集的构建和模型的训练提出了更高的要求。
常用场景
经典使用场景
在自然语言处理领域,llama3_non_delete_rr40k_3ep_dpo_gen_augmath_1_type1数据集广泛应用于对话系统的训练与评估。该数据集通过提供成对的对话文本(chosen_txt和rejected_txt),能够有效支持对话生成模型的对比学习,帮助模型在生成回复时选择更符合上下文和用户意图的文本。
解决学术问题
该数据集解决了对话生成模型在训练过程中难以区分高质量回复与低质量回复的学术问题。通过引入对比学习机制,模型能够更好地理解对话上下文,从而生成更加连贯和准确的回复。这一方法显著提升了对话系统的性能,为自然语言处理领域的研究提供了新的思路。
实际应用
在实际应用中,llama3_non_delete_rr40k_3ep_dpo_gen_augmath_1_type1数据集被广泛用于智能客服、虚拟助手等场景。通过训练基于该数据集的模型,企业能够提供更加智能和个性化的服务,提升用户体验。同时,该数据集也为多轮对话系统的开发提供了重要的数据支持。
数据集最近研究
最新研究方向
在自然语言处理领域,llama3_non_delete_rr40k_3ep_dpo_gen_augmath_1_type1数据集的最新研究方向聚焦于对话系统的优化与增强。该数据集通过提供chosen_txt和rejected_txt的对比,以及详细的对话角色和内容信息,为研究者提供了丰富的训练素材。当前的研究热点包括利用该数据集进行对话策略的深度优化,特别是在多轮对话中的决策过程。此外,该数据集还被广泛应用于生成模型的训练,以提高模型在复杂对话场景中的表现。这些研究不仅推动了对话系统技术的发展,也为相关应用如智能客服和虚拟助手提供了强有力的支持。
以上内容由遇见数据集搜集并总结生成


