
electricsheepafrica/africa-mental-health-screening
收藏官方服务:
资源简介:
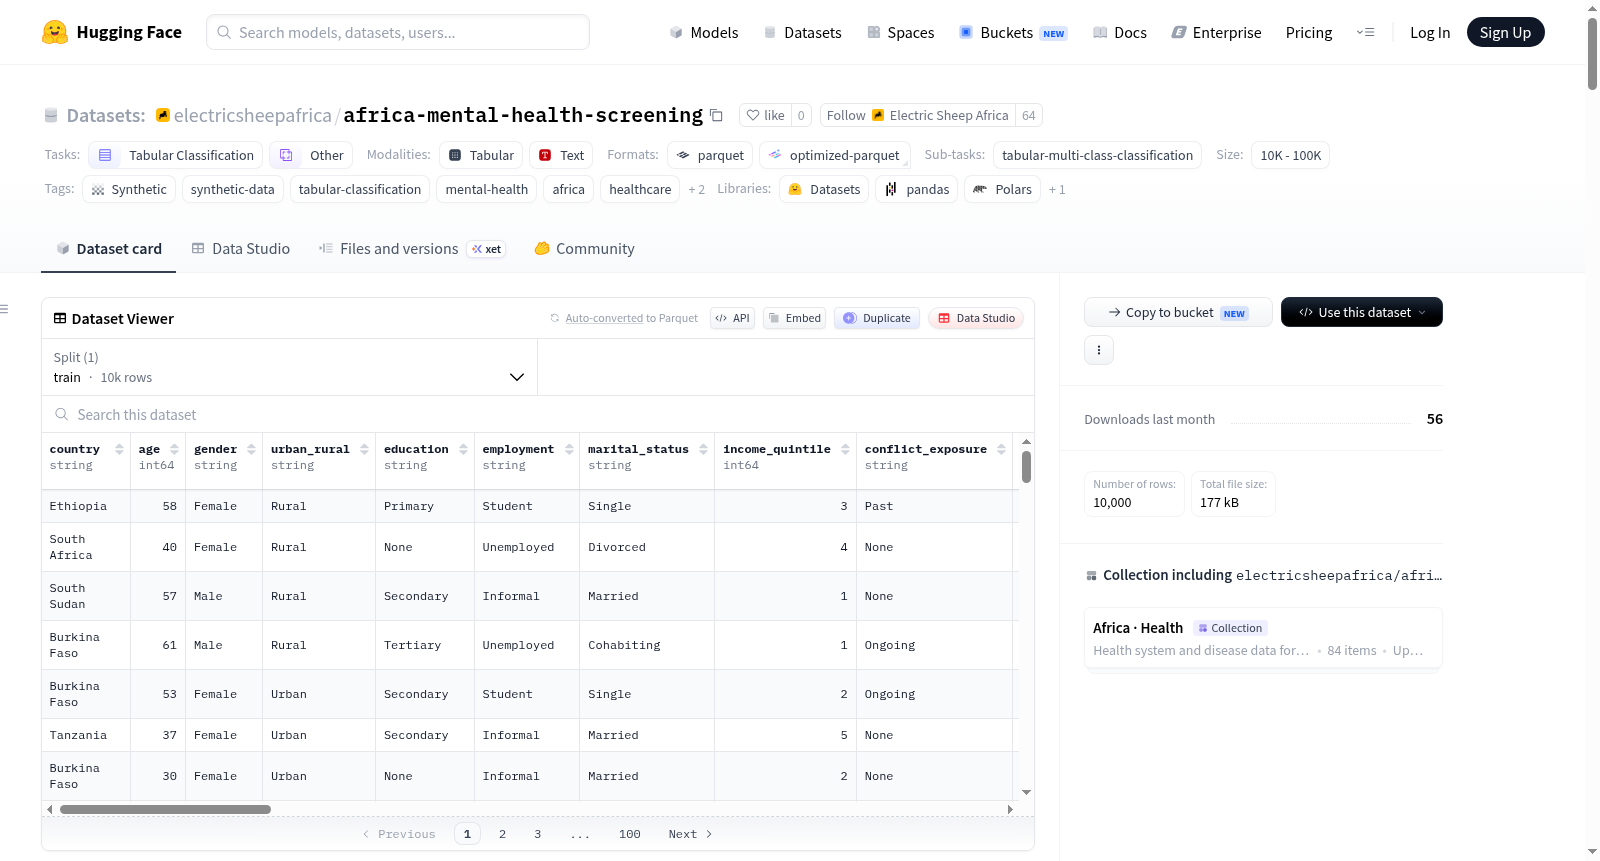
非洲心理健康筛查数据集是一个合成表格数据集,专门用于非洲医疗保健环境中的心理健康筛查。该数据集旨在解决非洲心理健康研究的关键数据缺口,因为在非洲,85%患有心理健康问题的人没有得到治疗。数据集包含10,000行数据,完美平衡了阳性病例(标签=1)和对照病例(标签=0),各5,000行。它覆盖了20个非洲国家,时间跨度为2019年至2024年,具有40多个特征(原始特征和工程特征),无缺失值。数据集包括人口统计信息(如国家、年龄、性别)、临床指标(如PHQ-9抑郁评分、GAD-7焦虑评分)、社会因素(如社会支持评分、耻辱感水平)以及工程特征(如症状严重程度评分、社会剥夺指数)。数据集支持多种使用案例,如抑郁/焦虑风险预测、高风险患者识别、治疗缺口分析和心理健康资源分配。数据是合成的,基于非洲特定的症状权重生成,并经过泄漏过滤以确保类别分离。数据集还提供了预处理建议、基准性能预期和伦理考虑,强调在临床验证和文化适应性方面的局限性。
A synthetic tabular dataset for mental health screening in African healthcare contexts. This dataset addresses the critical data gap for mental health research in Africa, where 85% of people with mental health conditions receive no treatment.
提供机构:
electricsheepafrica搜集汇总
数据集介绍
构建方式
该数据集以非洲精神卫生研究的现实困境为起点,旨在填补该地区严重缺失的数据空白。构建过程首先依据非洲特有的症状权重生成阳性病例,同时生成反映一般人群特征的对照样本,并通过泄露过滤机制剔除临床意义上归类的混淆记录。随后执行特征工程,基于临床指南与文献衍生出综合风险评分、社会剥夺指数等关键变量。最终通过平衡采样,获取5,000例阳性与5,000例对照,共计10,000条记录,并采用固定随机种子以保障完全可复现。
使用方法
用户可通过Hugging Face的datasets库直接加载,亦可读取CSV文件进行后续分析。数据适用于抑郁/焦虑风险预测、高风险患者识别及治疗差距分析等任务。预处理建议包括对类别特征进行独热编码、对连续变量进行标准化,并按国家分层划分训练集(70%)、验证集(15%)与测试集(15%)。模型评估可采用5折分层交叉验证,并关注跨国家的泛化表现,以避免过拟合于特定国家特征。
背景与挑战
背景概述
非洲大陆的精神健康研究长期受困于数据匮乏的窘境,全球现有数据集多聚焦于高收入国家,难以捕捉非洲特有的躯体化症状表现、冲突创伤交互作用、传统治疗师使用模式、污名化障碍及本土化物质滥用特征。该数据集由Electric Sheep Africa团队于2024年创建,旨在填补这一关键空白,通过合成10,000例涵盖20个非洲国家、基于2019至2024年流行病学权重采样的结构化表格数据,聚焦于抑郁与焦虑筛查任务。数据集平衡正负样本各5,000例,并设计了40余个特征与复合指数,为非洲精神健康领域的研究提供了稀缺的基础数据支撑,有望推动筛查工具的本地化适配与医疗资源优化配置。
当前挑战
数据构建面临的核心挑战在于如何真实还原非洲精神健康的多元临床面貌:非洲患者抑郁时常以躯体不适而非情绪低落为主诉,传统治疗师的首诊依赖率达80%,加之冲突与流离失所的高发(全球前十大脆弱国家中非洲占据九席),使得疾病表征与风险因素错综复杂。合成过程中需解决文化变异导致的症状权重校准难题,避免简化冲突与流离失所类别,并确保生成的特征间相关性符合临床实际,防止数据泄露与过拟合。此外,模型还需应对筛查场景中的高误报代价与跨国家、跨性别的公平性审计挑战,以确保研究成果能安全、有效地转化至资源匮乏的非洲社区。
常用场景
经典使用场景
非洲心理健康筛查数据集作为一个合成的表格分类数据集,专为非洲地区心理健康筛查场景设计。其经典用途在于训练和评估抑郁与焦虑风险预测模型,研究人员可利用其中包含的40余项特征(涵盖人口统计、临床评分、社会心理指标及冲突暴露等非洲特定变量)构建二分类或多分类算法,实现高风险个体的精准识别。该数据集完美平衡的正负样本分布有效避免了类别不平衡偏差,使其特别适合作为基准测试平台,用于比较逻辑回归、随机森林及XGBoost等模型在心理健康筛查任务中的性能表现。
解决学术问题
该数据集直面非洲心理健康研究中的核心困境——全球现有数据集过度依赖高收入国家人群,未能捕捉非洲特有的躯体化症状表现、冲突-创伤交互作用、传统医者使用模式及污名化障碍。通过合成数据填补这一关键鸿沟,它使学术界能够量化分析非洲背景下治疗缺口(85%患者未获治疗)、社会剥夺指数与就医障碍之间的复杂关联,并探索基础设施变量与患者层级特征的交互效应。这一开创性工作为理解和解决非洲心理健康领域系统性忽视问题提供了实证基础。
实际应用
在实际应用中,该数据集助力构建面向非洲社区的智能化心理健康筛查系统,支持资源匮乏地区的初级卫生保健机构开展早期干预。例如,基于该数据训练的模型可被部署于移动健康应用或社区诊疗点,通过评估患者的PHQ-9与GAD-7评分、社会支持水平及距最近精神卫生设施距离等指标,自动生成高风险预警并指导转诊决策。此外,它还能辅助政策制定者进行精神卫生资源优化配置,通过分析不同国家的疾病负担分布特征,有针对性地加强冲突频发区域的心理危机干预能力。
数据集最近研究
最新研究方向
该数据集聚焦于非洲心理健康筛查领域的数据稀缺问题,通过生成合成表格数据,填补了全球心理健康研究中高收入国家人口主导的空白。当前前沿研究方向包括利用机器学习模型(如随机森林、XGBoost)进行抑郁与焦虑风险预测,并结合非洲特有的躯体化症状、冲突创伤交互、传统疗法使用及污名化障碍等本地化特征,开发文化适应性筛查工具。热点事件如世界卫生组织发布的非洲心理健康报告及“大挑战非洲”计划,凸显了该数据集在资源分配、治疗差距量化及公平性审计中的关键作用。其意义在于为低资源环境下的精准心理健康干预提供可复现的基线,推动联邦学习、因果推断及可解释AI等先进方法论在非洲医疗场景中的应用,从而实质性地缩减85%患者未获治疗的严峻差距。
以上内容由遇见数据集搜集并总结生成


