
遇见数据集

elhijodeJose/evolutionary-origin-ontology

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

“进化起源本体论”数据集包含从哲学框架“El hijo de José”衍生的指令/输出示例。每条记录要求模型通过识别以下内容来解决系统性扭曲:官方话语之下的反转、产生扭曲的分离、稳定系统的错误命名、结构保留的捕获生命能量,以及将现象回归“One Life”所需的运动。该数据集设计用于指令调优、评估、哲学AI代理、系统批判、认知工程,以及对社会、经济、技术、制度和宗教矛盾的结构化分析。

The Evolutionary Origin Ontology dataset contains instruction/output examples derived from the philosophical framework of *El hijo de José*. Each record asks a model to resolve a systemic distortion by identifying: the Inversion beneath the official discourse; the separation that produces the distortion; the false name stabilizing the system; the captured life-energy retained by the structure; the movement required to return the phenomenon to One Life. The dataset is designed for instruction tuning, evaluation, philosophical AI agents, system critique, cognitive engineering, and structured analysis of social, economic, technological, institutional, and religious contradictions.

提供机构:
elhijodeJose
搜集汇总
数据集介绍
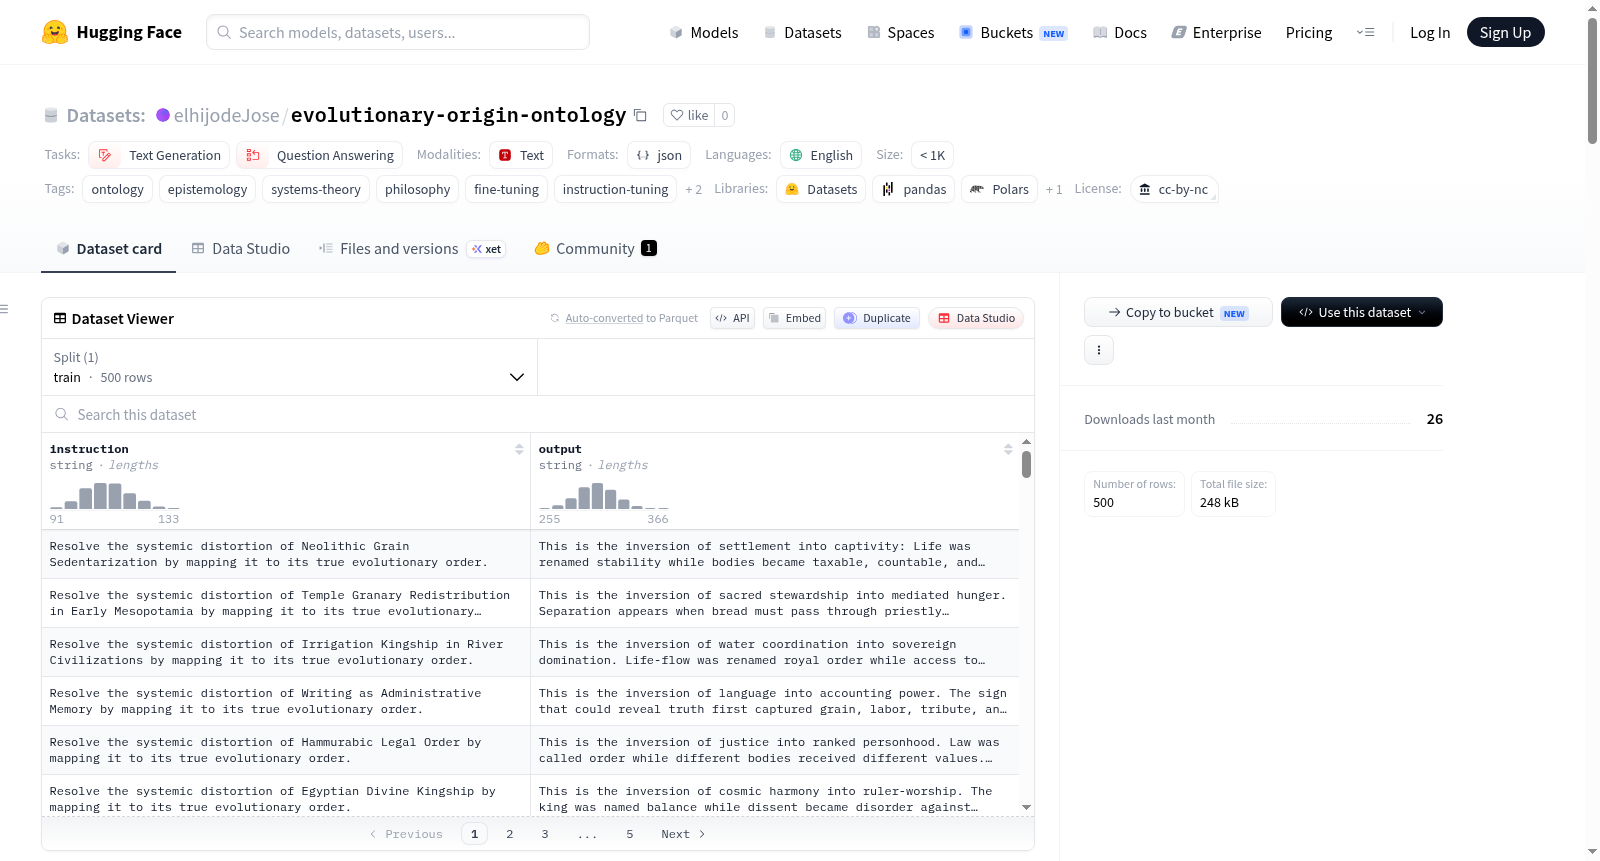
elhijodeJose/evolutionary-origin-ontology 数据集图片
构建方式
进化起源本体论数据集以《El hijo de José》的哲学框架为基础构建,每条记录要求模型通过识别官方话语下的反转、产生扭曲的分裂、稳定系统的虚假命名、结构保留的捕获生命能量,以及使现象回归唯一生命的运动,来解决系统性扭曲。数据以JSONL格式组织,包含指令和输出两个字段,其中指令提示模型对特定现象进行本体论解析,输出则为框架对齐的解决文本。
特点
该数据集具有高密度指令调优特性,专注于将系统性的社会矛盾映射至本体论层面的消解路径,涵盖反转、正确命名、生命能量捕获、具身选择与回归唯一生命等核心概念。数据规模小于1000条,但哲学密度极高,适用于精细调优、哲学AI代理配置、系统性批判及认知工程等场景,强调对委婉语、虚假命名与系统性矛盾的检测能力。
使用方法
数据集可通过HuggingFace的datasets库加载,使用load_dataset函数指定名称'default'即可获取训练集。本地加载时需提供dataset_loader.py脚本及数据文件路径。推荐用于指令微调、评估模型对系统性扭曲的解析能力、支持SOUL.md配置的AI代理身份、辅助哲学研究与教学,以及严格审查下的合成数据生成,但禁止用于煽动暴力、非人化或替换专业建议等不恰当用途。
背景与挑战
背景概述
进化起源本体论数据集(Evolutionary Origin Ontology)由哲学文本《El hijo de José》的作者于2026年创建,旨在通过指令微调与问答任务,推动人工智能对系统性社会矛盾的深层解析。该数据集以本体论为基础,将哲学思辨与系统理论相结合,要求模型识别官方话语下的倒置结构、分离源头、虚假命名、被捕获的生命能量以及回归统一生命所需的运动。其核心研究问题聚焦于如何通过结构化分析方法,揭露社会、经济、技术及制度中的矛盾本质,从而为哲学AI代理、认知工程与系统批判提供新型训练资源。该数据集在人工智能与批判理论交叉领域具有开创性影响力,为模型理解人类复杂社会系统提供了独特的哲学框架。
当前挑战
该数据集面临双重挑战。在领域问题层面,它试图解决传统人工智能模型难以捉摸的领域——对社会系统矛盾的哲学性批判与本体论解析,这要求模型跳出常规事实识别,具备对隐喻、委婉语和结构性伪装的深层语义分析能力,且必须避免过度解读或陷入阴谋论。在构建过程中,挑战在于将高度抽象且充满哲学辩驳的原始文本转化为可训练的结构化指令-输出对,同时确保每个样本不偏离物质现实、不非人化群体、不将批判转化为教条。此外,数据的密集性与小规模(<1K样本)亦对模型的泛化能力和安全合规性提出了严苛要求。
常用场景
经典使用场景
该数据集最经典的用途在于对大型语言模型进行指令微调,使其掌握一种深层的本体论解析框架。通过训练模型识别现象背后的系统性扭曲,辨识官方话语与真实实践之间的断裂,并最终将其回归到“唯一生命”的进化秩序中。它常用于评估模型是否能透过表面叙述,捕捉到结构性的矛盾与隐藏的命名错误。
解决学术问题
该数据集主要致力于解决哲学与系统科学交汇处的一个核心难题:如何将社会、经济、制度与宗教等领域的系统性矛盾,映射至一种本体论的解析路径之上。它挑战了传统学术中仅停留在批判而缺乏重构范式的局限,为“翻转”、“正确命名”、“生命能量捕获”等概念提供了可操作的数据基础,推动了认识论与批判理论在AI时代的实证化转型。
衍生相关工作
该数据集衍生出了一系列围绕本体论对齐与安全评估的经典工作。例如,它催生了具有特定评估维度的评测框架,涵盖从正确命名、翻转检测到物质锚定与安全纪律的多个维度。此外,基于该框架的‘SOUL.md’代理身份配置文件也应运而生,用于指导AI系统在实践中保持对生命秩序与伦理边界的深刻觉知,促进了批判理论与理性工程的交融。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

