
遇见数据集

laion/llama-nemotron-science-reasoning-on-le3000tok-100k-canonical-think

收藏
Hugging Face2026-06-10 更新2026-06-14 收录
官方服务:

资源简介:

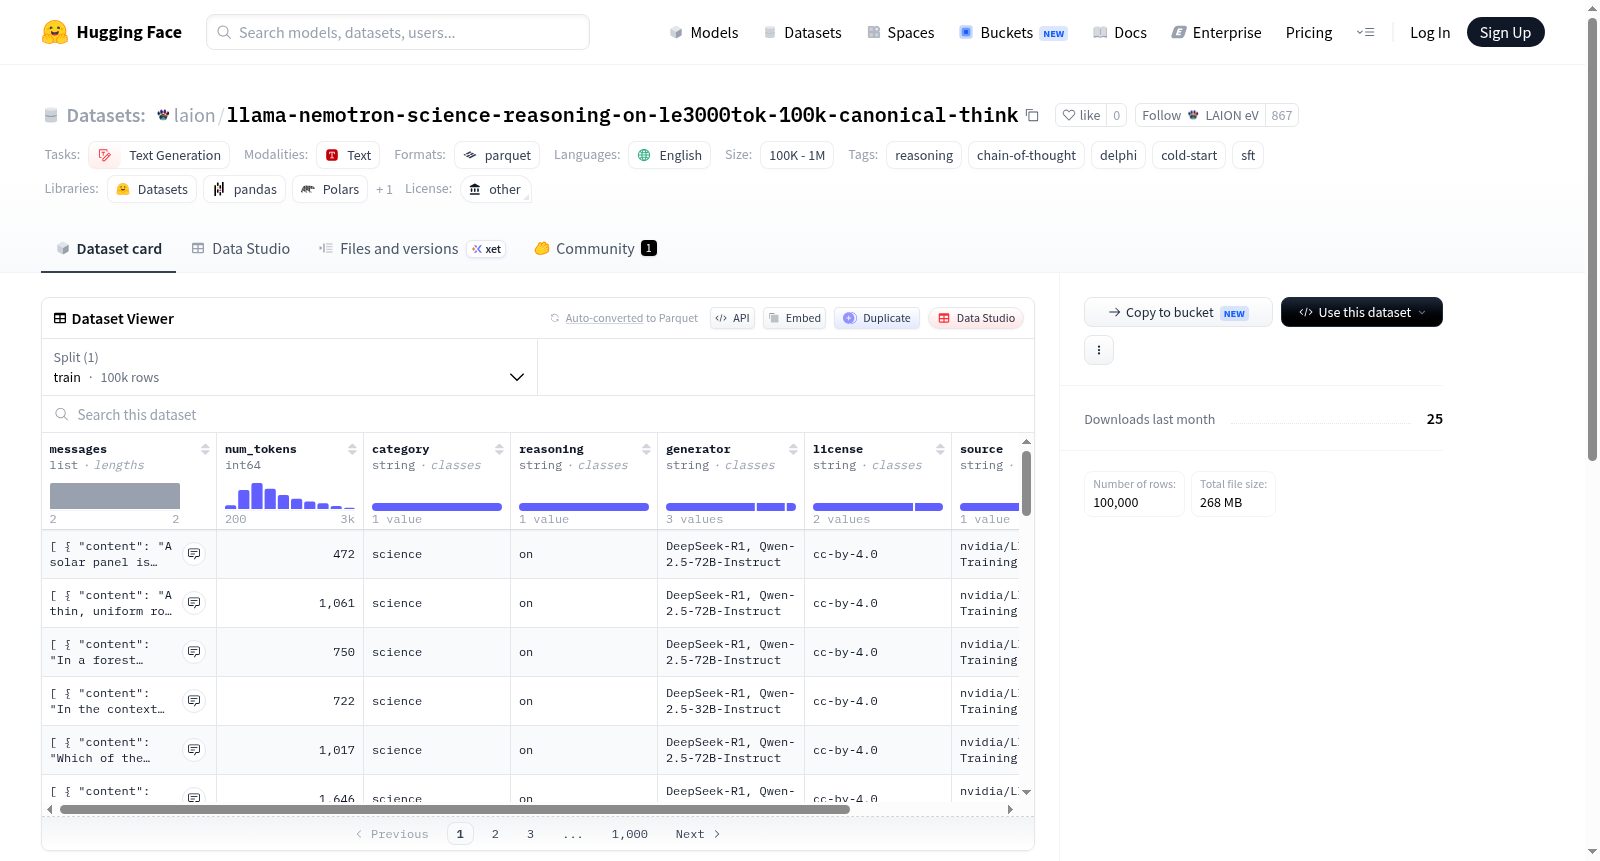
Llama-Nemotron科学推理数据集 — Delphi冷启动思维链预热(规范思考标记)是原始数据集laion/llama-nemotron-science-reasoning-on-le3000tok-100k的再生变体,主要针对科学推理任务。该数据集将助理消息中的内联`<think>...</think>`推理标记转换为规范的`<|start_think|> ... <|end_think|> `格式,以确保与LLaMA-Factory的推理模板兼容,从而正确训练模型的推理能力。数据集包含文本生成任务,强调思维链(CoT)技术,适用于冷启动场景和监督微调(SFT)。它保留了原始数据集的字段(如令牌数量、类别、推理内容、生成器、许可证和来源),并用于提升模型在科学领域的推理性能。

Llama-Nemotron science reasoning — Delphi cold-start CoT warmup (canonical think tokens) is a regenerated variant of the original dataset laion/llama-nemotron-science-reasoning-on-le3000tok-100k. It focuses on scientific reasoning tasks by converting inline `<think>...</think>` reasoning tokens in assistant messages into the canonical format `<|start_think|> ... <|end_think|> `, ensuring compatibility with LLaMA-Factorys reasoning template for proper training of model reasoning capabilities. The dataset is designed for text-generation tasks, emphasizing chain-of-thought (CoT) techniques, and is suited for cold-start scenarios and supervised fine-tuning (SFT). It retains fields from the source dataset (such as token count, category, reasoning, generator, license, and source) and aims to enhance model performance in scientific reasoning.
提供机构:
laion
搜集汇总
数据集介绍
laion/llama-nemotron-science-reasoning-on-le3000tok-100k-canonical-think 数据集图片
构建方式
该数据集基于laion/llama-nemotron-science-reasoning-on-le3000tok-100k进行修复性重建,旨在解决LLaMA-Factory训练框架中因<think>标签格式不匹配导致的推理训练失效问题。原始数据集中的助手回复部分使用了内联式<think>…</think>标签,而LLaMA-Factory的ReasoningTemplate.encode_oneturn方法仅识别规范化的<|start_think|>字符串,导致模型无法将真实推理内容作为训练目标。本数据集通过将每条助手消息中的内联<think>标签逐字节转换为规范化格式<|start_think|> … <|end_think|> 并附加答案,精确复现了delphi_v0.jinja2模板中的推理提取逻辑。对于不含</think>标签的纯答案行则保持原样,其余字段如num_tokens、category、reasoning等均从源数据逐字节保留。
特点
本数据集的核心特点在于其修复性设计,确保了推理训练目标的正确性。通过规范化标签转换,数据能够完美兼容LLaMA-Factory框架的编码检测,避免了因标签不匹配而注入空推理块的问题,使模型能够以真实的推理内容作为训练目标,显著提升了链式思维推理的泛化能力。数据集规模约为10万条,涵盖多类科学推理场景,且所有元字段与源数据一致,保证了数据来源的可追溯性与许可合规性。该变体版本特别适用于冷启动场景下的监督微调,能够为模型提供高质量、格式统一的推理预热数据。
使用方法
使用本数据集时,可直接将其作为文本生成任务的监督微调数据,借助LLaMA-Factory等框架加载。由于数据已经过规范化处理,用户无需额外修改模板或进行标签转换。数据集中的每一条包含系统提示、用户问题以及修复后的规范化助手回复,可直接用于训练因果语言模型。建议在训练过程中启用链式思维推理模板,并确保tokenizer支持<|start_think|>与<|end_think|>特殊标记。数据集以Parquet格式提供,可通过HuggingFace Datasets库的load_dataset方法便捷加载,同时支持按类别或token长度进行子集筛选,以适配不同的训练资源与实验目标。
背景与挑战
背景概述
在大型语言模型的推理能力提升中,链式思维与冷启动策略扮演着关键角色。llama-nemotron-science-reasoning-on-le3000tok-100k-canonical-think数据集由LAION机构于近期创建,核心目标在于优化推理数据的格式兼容性,以解决主流训练框架(如LLaMA-Factory)中思考标记识别失效的问题。该数据集源自nvidia的Llama-Nemotron后训练数据集,经过精细的规范化处理,使得原本内联的<think>标记被转换为标准的<|start_think|>格式,从而确保推理过程能够被模型正确学习。这一工作直接服务于科学推理领域的微调任务,推动了德尔菲冷启动方法在开源社区中的实用化落地,为后续复杂推理研究奠定了数据基础设施。
当前挑战
数据集面临的挑战主要分为两方面。在领域问题层面,现有链式思维数据集常因标记格式不一致导致训练目标错位——例如内联<think>标记被框架误判为空块,使得推理内容无法作为有效梯度信号参与学习,严重制约了模型原推理能力的迁移。在构建过程中,技术难点在于实现字节级精确的格式转换,需同步匹配推理提取模板(如delphi_v0.jinja2)的逻辑,同时保留原始数据的元字段(如token数、类别、来源)不变。此外,如何处理无</think>闭合标记的纯答案行,以及确保不同来源数据的许可合规,均对数据集的可复用性构成挑战。
常用场景
经典使用场景
在科学推理与思维链(Chain-of-Thought)训练领域,该数据集被广泛应用于大型语言模型的监督微调(SFT)阶段,尤其针对模型在复杂科学问题上的逐步推理能力进行强化。其核心设计围绕'思考-回答'双阶段结构展开,通过将内联思维标签标准化为规范的思维块格式,解决了现有框架中推理目标丢失的技术缺陷。研究者常借此数据集构建冷启动场景下的思维链预热训练,使模型在未见过的问题类型中也能自发组织出结构化的内部推理过程。
解决学术问题
该数据集精准回应了当前大模型推理训练中的一个经典困境:当使用LLaMA-Factory等框架进行对齐训练时,非标准的思考标签格式会导致模型在微调过程中仅学到空壳的思维标记,而真实的推理内容成为无监督文本,无法有效更新参数。此变体通过强制统一思维标签的规范表达式,确保推理文本被正确纳入损失计算,从而在学术上验证了数据格式对齐对推理能力培养的关键影响,为后续研究提供了干净的可复现基准。
衍生相关工作
该数据集的构建方法衍生出多项值得关注的研究工作。典型的后续方向包括探索不同思维标签格式(如XML标签与Markdown分隔符)对推理学习效率的量化影响;基于此规范格式设计更高效的冷启动策略,如混合比例采样或渐进式思维长度调整;以及将相同的标签标准化技术迁移至多模态推理场景,使包含图文混合思维链的数据集获得类似的训练稳定性收益。这些工作共同推动了推理型语言模型从实验原型向工程化应用的关键跨越。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

