
DiQAD
收藏官方服务:
资源简介:
一个用于自动评估开放领域对话质量的大规模对话质量评估数据集,基于符合人类对话质量判断维度的评估标准,包含约100,000个真实用户之间的对话。
A large-scale dialogue quality assessment dataset dedicated to the automatic evaluation of open-domain conversational quality. It is built upon evaluation criteria aligned with the dimensions used in human judgment of dialogue quality, and comprises approximately 100,000 authentic conversations between real users.
创建时间:
2023-10-25
原始信息汇总
对话质量评估数据集
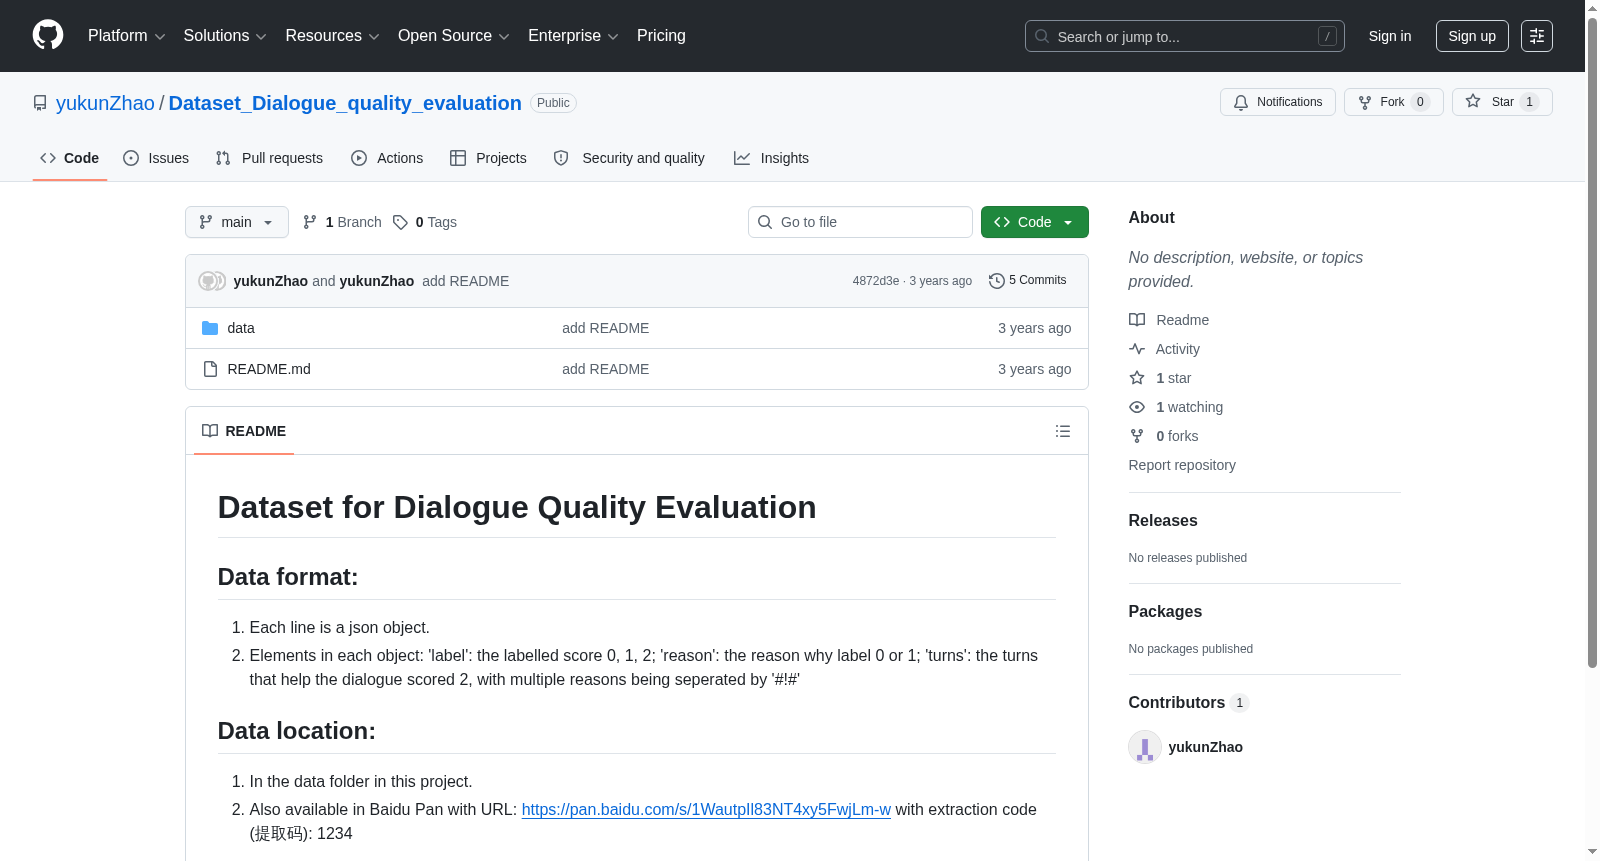
数据格式
- 每行是一个JSON对象。
- 每个对象包含以下元素:
- label: 标记的分数,取值为0、1、2。
- reason: 标记为0或1的原因。
- turns: 有助于对话得分为2的回合,多个原因之间用#!#分隔。
数据位置
- 位于本项目的data文件夹中。
- 也可在百度网盘获取,链接为:https://pan.baidu.com/s/1WautpIl83NT4xy5FwjLm-w,提取码为1234。
搜集汇总
数据集介绍
构建方式
在开放域对话系统的研究进程中,对话质量的评估始终是引导系统向人类认知趋近的核心挑战。DiQAD数据集基于真实用户对话场景构建,首先从在线问答平台WenYiWen采集超过十万条涵盖情感、数码、法律、教育、汽车、金融六大领域的真实对话,确保对话内容贴近实际用户需求。随后,研究团队基于语法性、相关性、一致性、共情性、主动性和信息丰富度六个维度建立了符合人类认知的质量评估标准,并采用0至2的三级评分体系。数十名经验丰富的标注员在自研众包平台上进行两轮一致性标注,每批数据经专业质检员抽检,确保标注准确率超过92%,最终形成了包含约十万条对话、八十万条话语的大规模高质量评估数据集。
使用方法
DiQAD数据集适用于训练和评估开放域对话质量自动评估模型。使用时,可将每条对话中的提问与回复拼接为长文本,输入至基于Transformer的预训练语言模型(如ERNIE、BERT)中,通过[CLS]标记的嵌入向量进行三分类预测。数据集已划分为训练集、验证集和测试集,便于模型调优与性能对比。研究者可基于该数据集开展跨领域泛化实验,通过移除特定领域训练样本检验模型迁移能力。此外,DiQAD还可用于分析用户情感表达对质量评估的影响,以及对比无监督评估方法(如USR、BARTScore)与有监督方法的差异。数据集已开源并提供详细标注指南,便于复现与扩展研究。
背景与挑战
背景概述
在开放域对话系统迅猛发展的浪潮中,对话质量评估作为衡量系统性能与用户体验的关键环节,日益受到学术界与工业界的广泛关注。然而,现有的评估数据集多聚焦于单一维度如连贯性或多样性,缺乏能够全面反映人类认知判断的端到端评估资源。为解决这一瓶颈,Yukun Zhao、Lingyong Yan等来自山东大学、百度及莱顿大学的研究人员于2023年发布了DiQAD(Dialogue Quality Assessment Dataset),这是一个大规模、面向开放域对话的端到端质量评估基准数据集。该数据集基于语法性、相关性、一致性、共情性、主动性和信息性六维人类认知标准,收集了来自真实在线对话平台“问一问”的约10万条对话,覆盖数字、情感、教育等六大领域,旨在推动对话系统向更高质量、更符合人类期望的方向演进。
当前挑战
DiQAD所面对的挑战体现在两个层面。在领域问题层面,开放域对话评估长期受困于参考依赖与粗粒度评价的局限,现有方法难以捕捉对话中信息丰富度与主动性的细微差异,而DiQAD要求模型具备区分低、中、高三档质量的能力,这对自动评估模型提出了更高要求。在构建过程中,研究人员面临多重挑战:首先,需制定统一且符合人类认知的六维质量准则,确保标注标准的一致性与可操作性;其次,从真实用户对话中收集数据,需处理话题多样性与对话长度差异带来的标注复杂性;此外,标注流程采用两轮校验机制,要求标注准确率不低于92%,约31%的批次需重新标注,以保证数据质量的可信度与可复现性。
常用场景
经典使用场景
DiQAD作为首个大规模开放域对话质量评估基准数据集,其经典使用场景在于为对话系统提供端到端的自动化质量评估。研究者可借助该数据集训练评估模型,从语法正确性、相关性、一致性、共情能力、主动性和信息丰富性六个维度综合评判对话质量。该数据集覆盖情感、数码、法律、教育、汽车、金融六大真实领域,包含约10万条真实用户对话,为开放域对话系统的质量监控与迭代优化提供了标准化测试平台。
解决学术问题
DiQAD有效解决了开放域对话评估领域长期存在的学术难题:其一,突破了以往仅关注连贯性或多样性等单一子指标的局限,实现了符合人类认知的复合质量评估;其二,克服了参考依赖型评估方法受限于参考覆盖率的缺陷;其三,通过采集真实用户间的自然对话,避免了人工标注者间模拟对话与真实场景的偏差。该数据集推动了从粗粒度评估向细粒度、人性化评估的范式转变。
实际应用
在实际应用中,DiQAD已被部署于在线对话平台,用于实时监控对话质量。基于该数据集训练的评估模型能够自动识别低质量回复,指导对话系统生成更令人满意的响应。实验表明,部署该质量评估模型后,平台用户满意度和用户回访率分别提升了56%和23%。该数据集还可用于对话系统的自动化测试,辅助开发者优化模型在信息丰富性和主动引导方面的表现。
数据集最近研究
最新研究方向
在开放域对话系统迅猛发展的背景下,DiQAD数据集聚焦于端到端的对话质量自动评估,突破了以往仅关注连贯性、多样性等单一维度的局限。该数据集基于语法性、相关性、一致性、共情性、主动性和信息丰富度六维人类认知标准,构建了大规模真实用户对话的细粒度质量标注体系。前沿研究方向包括利用大语言模型进行对话质量判别、跨领域泛化能力分析以及用户情感对评估结果的影响机制。DiQAD的发布为对话系统提供了一种接近人类认知的高质量评估基准,推动了对话生成向更满足用户需求的方向演进,对提升大模型在实际交互场景中的表现具有重要指导意义。
相关研究论文
- 1DiQAD: A Benchmark Dataset for End-to-End Open-domain Dialogue Assessment · 2023年
以上内容由遇见数据集搜集并总结生成


