
dpo_thinking_n_a_o_h_u_p_corrected_1e-6_0.05_1.7B_4B_with_gold_labels_kl_estimation
收藏数据链接:
官方服务:
资源简介:
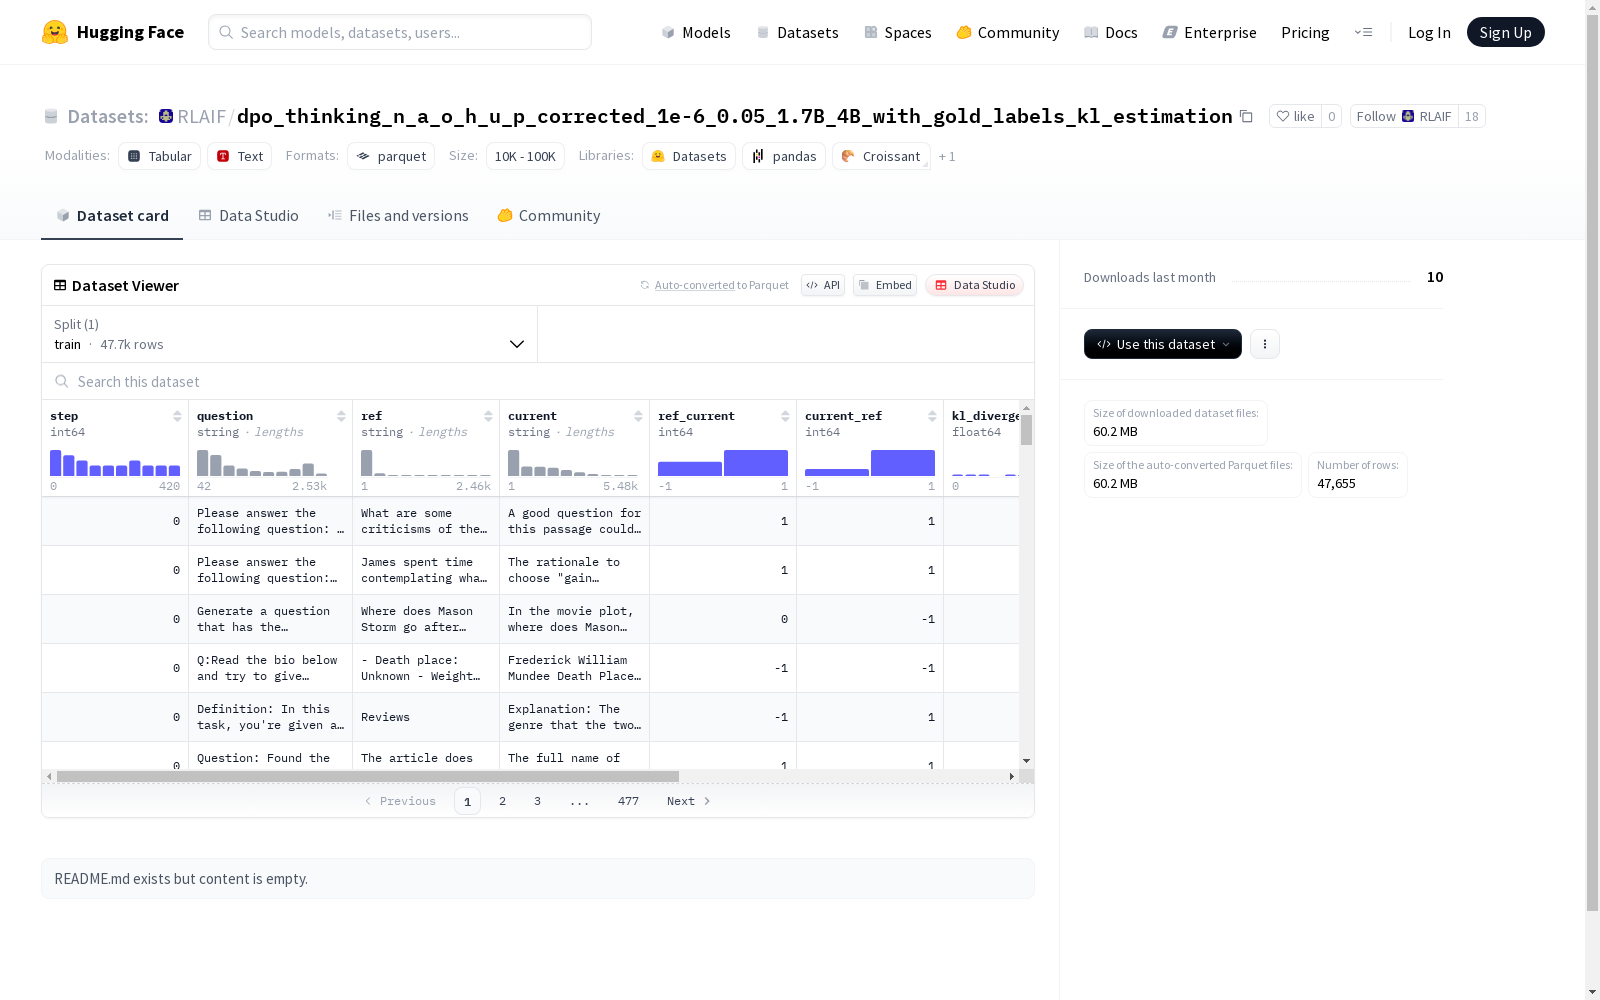
该数据集包含了一系列特征字段,如步骤编号(step)、问题(question)、参考答案(ref)、当前答案(current)等。数据集被划分为训练集(train),共有47655个示例,文件大小为113198287字节。数据集还提供了一个默认配置,指定了训练数据的文件路径。
提供机构:
RLAIF创建时间:
2025-09-09
原始信息汇总
数据集概述
基本信息
- 数据集名称: RLAIF/dpo_thinking_n_a_o_h_u_p_corrected_1e-6_0.05_1.7B_4B_with_gold_labels_kl_estimation
- 下载大小: 60177536 字节
- 数据集大小: 113198287 字节
- 训练集样本数量: 47655 个
数据特征
- step: int64
- question: string
- ref: string
- current: string
- ref_current: int64
- current_ref: int64
- kl_divergence: float64
- ref_is_A: bool
- gold: int64
- kl_estimated: float64
数据拆分
- 训练集: 包含 47655 个样本,数据文件路径为
data/train-*
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,高质量的训练数据对模型优化至关重要。该数据集基于DPO(Direct Preference Optimization)框架构建,通过精心设计的参数配置(如1e-6学习率、0.05阈值及1.7B与4B模型对比)生成样本,并引入KL散度估计与黄金标签校正机制,确保数据在偏好对齐过程中的可靠性与一致性。
特点
该数据集具备多维特征架构,涵盖问题、参考回答、当前模型输出及双向参考索引等字段,特别集成KL散度量化指标与黄金标签标注,有效支撑模型偏好学习与策略优化。其4.7万余条样本均经过严格的质量校验,兼具规模性与精确性,为对比学习与强化学习提供丰富的数据支持。
使用方法
研究者可借助该数据集开展深度偏好优化研究,通过解析问题-回答对与KL散度指标,训练模型进行策略对齐与奖励建模。数据已按标准格式分拆为训练集,可直接加载至主流机器学习框架,适用于模型微调、对比分析及生成质量评估等场景。
背景与挑战
背景概述
在人工智能领域,偏好优化技术对于提升大型语言模型的性能与对齐能力具有关键意义。dpo_thinking_n_a_o_h_u_p_corrected_1e-6_0.05_1.7B_4B_with_gold_labels_kl_estimation数据集由研究团队于近期构建,专注于通过直接偏好优化方法解决模型响应选择与策略改进问题。该数据集通过整合人类反馈与自动评估指标,旨在推动对话系统与强化学习交叉领域的发展,为模型对齐提供高质量的训练与评估基准。
当前挑战
该数据集核心挑战在于解决复杂决策场景中模型偏好的精确优化问题,涉及多轮对话响应选择与策略对齐的难度。构建过程中,需克服高质量人类反馈数据稀缺性、KL散度估计的计算复杂性,以及不同规模模型间策略迁移的稳定性问题,同时确保生成样本与参考分布间差异度量的可靠性。
常用场景
经典使用场景
在强化学习与人类偏好对齐的研究中,该数据集通过记录模型推理步骤中的KL散度与黄金标签,为直接偏好优化(DPO)算法提供了细粒度的训练样本。研究者可借助该数据集分析模型在每一步推理中的偏好选择行为,进而优化策略模型的收敛效率与稳定性。
衍生相关工作
该数据集衍生了多项基于DPO与KL控制的扩展研究,例如在多轮对话偏好学习、跨任务策略迁移以及低资源偏好建模中的应用。相关经典工作包括基于该数据集的动态奖励塑形方法、分层偏好对齐框架,以及针对生成模型安全性的偏好约束算法。
数据集最近研究
最新研究方向
在强化学习与人类偏好对齐领域,DPO_Thinking数据集正推动着策略优化范式的革新。研究者们聚焦于KL散度估计与黄金标签的协同机制,通过量化参考策略与当前策略的差异深度解析模型决策过程。该数据集为探索可控文本生成、奖励模型泛化性以及多模态对齐提供了关键实验基础,尤其在降低人类反馈成本、提升大语言模型安全性与可靠性方面展现出显著价值。
以上内容由遇见数据集搜集并总结生成


