
thisisbbln/flux-precomputed-trajectories-with-images
收藏官方服务:
资源简介:
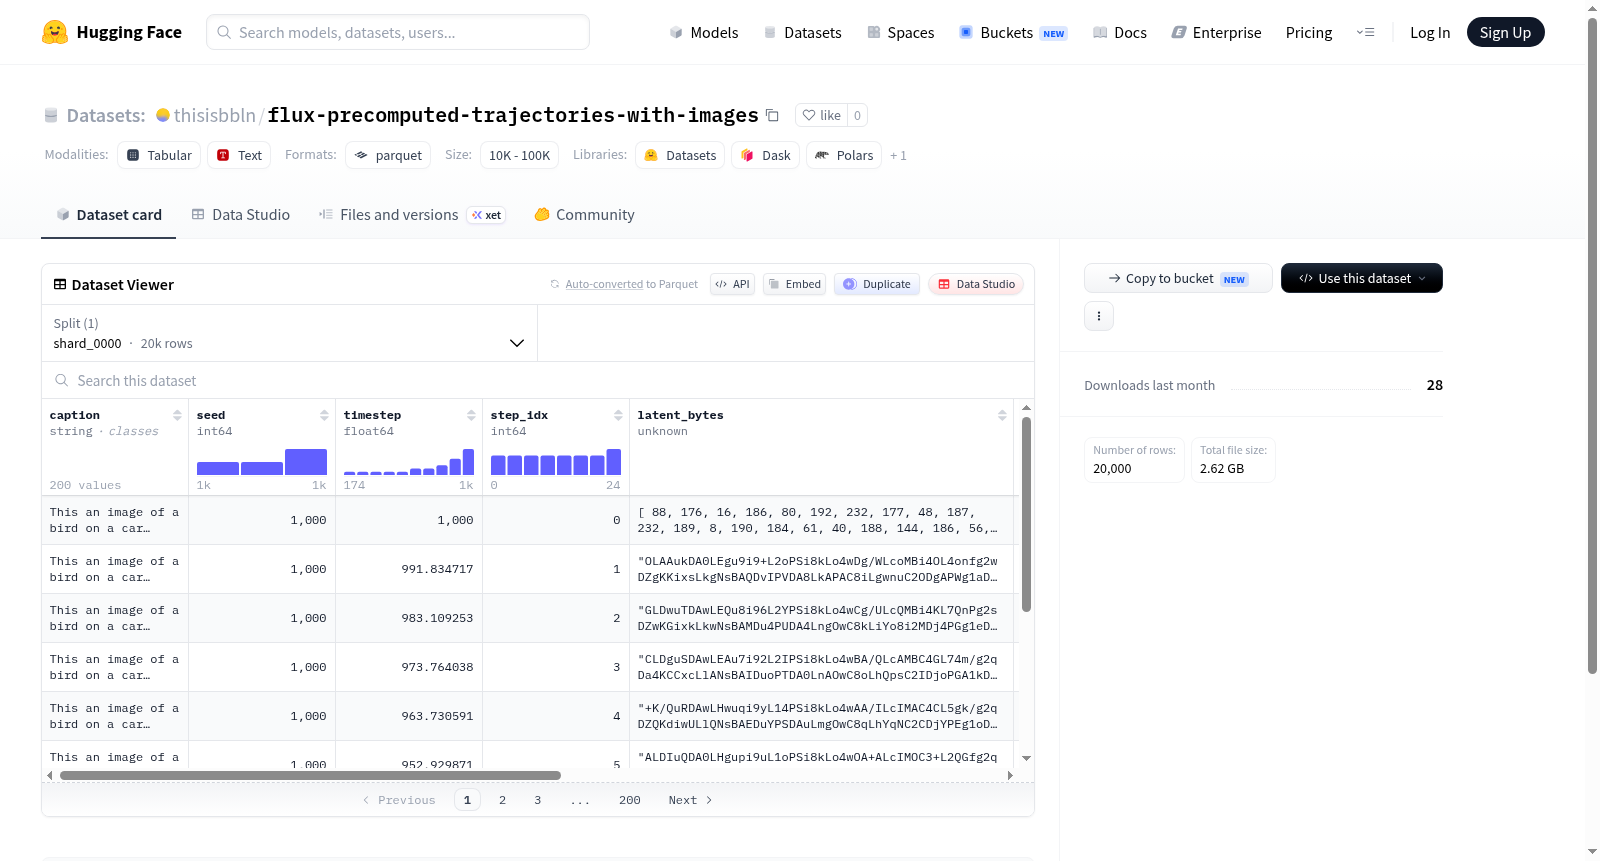
--- dataset_info: features: - name: caption dtype: string - name: seed dtype: int64 - name: timestep dtype: float64 - name: step_idx dtype: int64 - name: latent_bytes dtype: binary - name: latent_shape sequence: int64 - name: cond_noise_pred_bytes dtype: binary - name: cond_noise_pred_shape sequence: int64 - name: resolution dtype: int64 splits: - name: shard_0000 num_bytes: 2624179400 num_examples: 20000 download_size: 2622304887 dataset_size: 2624179400 configs: - config_name: default data_files: - split: shard_0000 path: data/shard_0000-* ---
提供机构:
thisisbbln搜集汇总
数据集介绍
构建方式
该数据集基于Flux模型的推理轨迹进行构建,通过记录模型在去噪过程中每个时间步的潜在表示(latent_bytes)和条件噪声预测(cond_noise_pred_bytes)来捕捉完整的生成轨迹。每个样本包含一个文本描述(caption)、随机种子(seed)、时间步长(timestep)和步骤索引(step_idx),结构化的元数据与二进制特征数据相结合,形成了一组高保真的模型内部状态快照。数据集以分片形式存储,首片(shard_0000)包含2万个样本,便于分布式处理。
使用方法
使用该数据集时,可通过加载分片数据文件(如shard_0000-*)并利用HuggingFace Datasets库进行高效解析。二进制字段(如latent_bytes)需要根据对应的shape元数据重构为多维张量,从而还原模型中间状态。适用于扩散模型的可解释性分析、训练过程中的轨迹可视化、以及作为蒸馏或对比学习的输入数据。建议结合Flux模型的官方评估工具进行结果验证。
背景与挑战
背景概述
该数据集名为flux-precomputed-trajectories-with-images,诞生于扩散模型与图像生成研究蓬勃发展的阶段,由致力于优化生成过程效率的团队创建。其核心研究问题聚焦于为基于流匹配的生成模型(如Flux系列)提供预计算的采样轨迹与对应图像,以便于模型训练时直接利用中间潜变量和噪声预测结果,从而加速收敛并节省计算资源。通过包含caption、timestep、latent_bytes等结构化特征,该数据集为分析扩散轨迹的动力学特性及条件生成机制提供了标准化的数据基础,对推动高效生成模型的训练与推理具有重要支撑作用。
当前挑战
该数据集主要应对的领域挑战在于,扩散模型在采样过程中需要重复计算每一步的噪声预测与潜变量更新,导致训练与推理成本高昂,而现有的数据集往往仅提供最终图像,缺乏中间轨迹数据,难以支持对加速收敛方法的研究。在构建过程中,挑战包括如何标准化存储不同分辨率和步长的异构轨迹数据,以及如何保证大规模二进制潜变量和噪声预测数据在多个分片中的完整性与一致性,同时还需应对约2.6GB数据量的高效压缩与加载需求。
常用场景
经典使用场景
在扩散模型与知识蒸馏研究领域,flux-precomputed-trajectories-with-images数据集扮演着不可或缺的角色。该数据集精心存储了从初始噪声到最终生成图像的全过程轨迹信息,包括潜在表示、条件噪声预测以及对应的时间步长等核心要素。研究者通常利用这些预计算轨迹,将复杂的多步扩散过程压缩为深度神经网络可直接学习的单步映射,从而构建高效的知识蒸馏框架。这一设计理念使得该数据集成为加速扩散模型推理、降低计算成本的关键资源。通过在此数据集上训练轻量级学生模型,可以继承教师扩散模型的生成能力,极大缩短图像生成所需的采样步数,同时保持与原始模型相当的视觉质量。
解决学术问题
该数据集有效应对了扩散模型部署过程中计算瓶颈这一核心学术挑战。传统扩散模型需要数十乃至上百步迭代才能完成样本生成,严重限制了其在实时交互场景中的应用潜力。flux-precomputed-trajectories-with-images通过提供结构化的预计算轨迹数据,为模型蒸馏、加速训练及推理压缩提供了标准化的基准平台。研究者可以系统性地探索不同蒸馏策略与网络架构对生成性能的影响,推动对扩散过程内在机制的理解。该数据集的发布促进了高效生成模型领域的理论突破,使其成为连接扩散模型理论与实际部署之间的重要桥梁,对降低大规模生成模型的能耗与延迟具有深远意义。
实际应用
在实际应用层面,flux-precomputed-trajectories-with-images所支持的技术直接赋能于算力受限的边缘设备与移动终端。经过该数据集蒸馏后的紧凑模型,能够在普通消费级显卡上实现毫秒级的高质量图像生成,极大地拓展了扩散模型在广告创意、游戏美术、实时交互设计等领域的落地可能性。基于该数据集的加速方案已广泛应用于内容创作工具、在线设计平台以及AR/VR场景中,使得用户无需依赖云计算资源即可获得流畅的生成体验。此外,该数据集还推动了扩散模型在医学影像合成、遥感图像增强等专业领域的实时化应用,为需要快速迭代的工业设计流程提供了坚实的技术支撑。
数据集最近研究
最新研究方向
flux-precomputed-trajectories-with-images数据集为扩散模型中的轨迹预计算与潜在空间特征优化提供了重要基础,尤其在图像生成的前沿研究中,该数据集的二进制潜变量和噪声预测特征被广泛用于探索基于Flux架构的高效采样策略与条件控制生成。近期,该数据集与多模态生成、少样本学习及实时图像合成等热点方向紧密关联,其预计算轨迹特性显著降低了训练时的计算开销,推动了模型在超高分辨率图像生成中的扩展性研究。这一资源的公开不仅促进了扩散模型在工业级应用中的落地,还为理解生成过程中的潜在动态与噪声抑制机制提供了关键数据支撑,对加速生成式AI在艺术创作、虚拟现实等领域的创新具有深远意义。
以上内容由遇见数据集搜集并总结生成


