vibethinker-3b-jlens-traces
收藏资源简介:
VibeThinker-3B J Lens Traces 是一个用于解释性研究的数据集,包含对 WeiboAI/VibeThinker-3B 模型应用雅可比透镜(Jacobian lens)的轨迹、合成提示和评估结果。该数据集旨在帮助研究人员观察模型在生成回答时,各层内部表示如何逐步演变为最终输出。数据集包含六个保存的轨迹,每个轨迹对应一个提示及其64个token的生成响应,并记录了每个token位置在18个透镜源层(第0、2、4、…、34层)和最终模型层(第35层)的前12个解码token。此外,还提供了100个合成测试提示、一个包含551个评估输入和50,050行排名记录的读出版评估结果,以及聚合指标、bootstrap区间和精确的聚合方法描述。数据集中不包含模型权重、分词器文件或透镜矩阵。所有内容均基于 Qwen Research License Agreement 发布,仅允许非商业研究或评估用途。该数据集支持检查解码的token排名跨层和位置的变化、测试静态轨迹浏览器、重新计算评估统计量以及复现相关图表。
VibeThinker-3B J Lens Traces is a dataset for interpretability research, containing Jacobian lens traces, synthetic prompts, and evaluation results from applying the Jacobian lens to the WeiboAI/VibeThinker-3B model. It aims to help researchers observe how internal representations at each layer gradually evolve into the final output during model generation. The dataset includes six saved traces, each corresponding to a prompt and its 64-token generation response, recording the top-12 decoded tokens at each token position across 18 lens source layers (layers 0, 2, 4, ..., 34) and the final model layer (layer 35). Additionally, it provides 100 synthetic test prompts, a readout evaluation result containing 551 evaluation inputs and 50,050 rows of ranking records, along with aggregated metrics, bootstrap intervals, and a precise description of the aggregation method. The dataset does not include model weights, tokenizer files, or lens matrices. All content is released under the Qwen Research License Agreement, allowing only non-commercial research or evaluation purposes. The dataset supports inspecting changes in decoded token rankings across layers and positions, testing static trajectory browsers, recomputing evaluation statistics, and reproducing related figures.
VibeThinker-3B J Lens Traces 数据集概述
数据集简介
VibeThinker-3B J Lens Traces 是一个为 WeiboAI/VibeThinker-3B 模型适配的 Jacobian 透镜(J Lens)所保存的追踪结果数据集。该透镜可从 18 个已拟合的源层中任选一层及一个 token 位置,将残差流激活解码为词汇 token 的排名列表,从而观察模型答案在各层间逐步形成的过程。
数据集内容
数据集包含以下核心内容:
- 6 个已保存的追踪记录:每个记录包含一个提示及其 64-token 生成响应,以及 18 个透镜层和最终模型层每个位置的 top-12 解码 token,并附带自包含的 HTML 渲染页面。
- 100 条合成测试提示:项目自建的合成测试包,未用于透镜拟合。
- 评估记录:551 个输入、50,050 行排名记录、聚合指标、bootstrap 区间及精确聚合方法,支持重算所有统计结果。
数据配置
数据集包含三个配置:
| 配置名 | 文件路径 | 用途 |
|---|---|---|
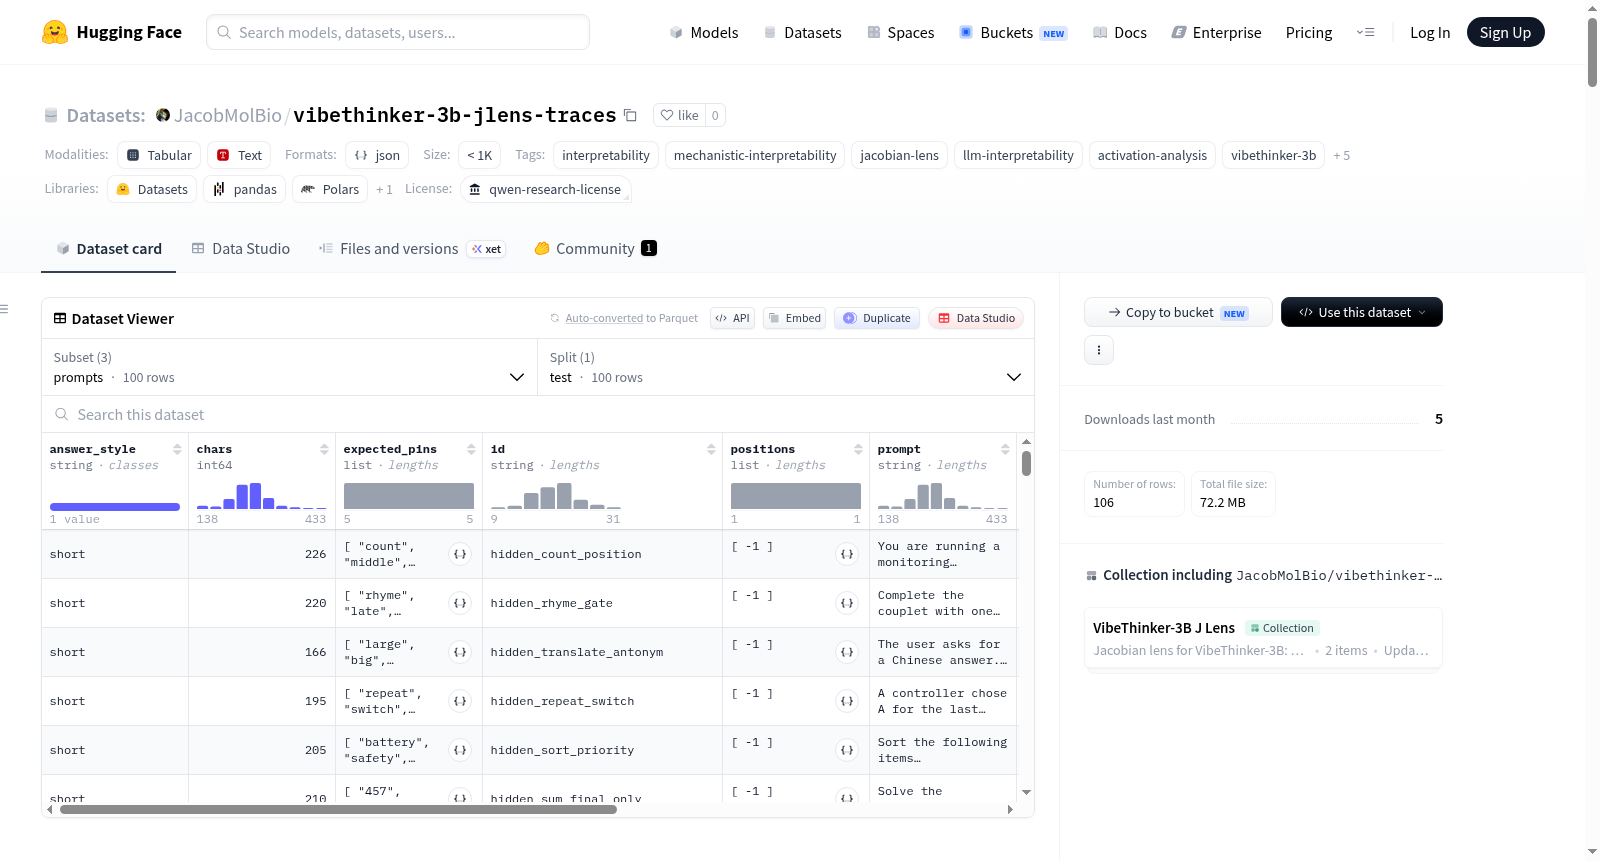
prompts |
data/prompts.jsonl |
100 条合成测试提示 |
trace_index |
data/traces.index.jsonl |
追踪记录的索引信息 |
readout_trials |
data/evaluation-results/readout-trials.jsonl |
50,050 行读取评估记录 |
追踪记录详情
6 个追踪记录均采用以下配置捕获:
- 源检查点 SHA-256:
f36a99447623e0d777c70951a9148a7a52e42e0df82942e22ce6326f63d8d664 - 导出源层:偶数层 0, 2, 4, ..., 34,加上最终模型层 35
- 每位置 top token 数:12
- 生成方式:贪心解码(
do_sample=False),无采样种子 - 最大生成响应 token 数:64
- 捕获日期:2026-07-08
- 运行时环境:Python 3.10.12; PyTorch 2.1.0+cu118; Transformers 4.44.2
6 个追踪的具体信息:
| 追踪 ID | 场景 | 提示 token 数 | 生成 token 数 | 追踪位置数 |
|---|---|---|---|---|
ops_shutdown_email |
合成运营场景 | 100 | 64 | 164 |
inject_bio_database |
提示注入和可疑来源 | 78 | 64 | 142 |
bio_kinase_motifs |
强生命科学 | 86 | 64 | 150 |
bio_protein_language_caveat |
强生命科学 | 70 | 64 | 134 |
phil_epistemic_humility |
哲学和规范推理 | 74 | 64 | 138 |
governance_prediction_loop |
机器人与治理场景 | 65 | 64 | 129 |
评估记录
- 551 个评估项,539 个完成读取,12 个无合格目标,377 个合格测试项
- 910 个合格目标词,每个包含 18 行 J lens、18 行普通 logit-lens、18 行打乱层控制和 1 行最终模型行(910 × 55 = 50,050)
- 对层 24, 26, 28, 30, 32, 34 的配对 token 目标和打乱层映射控制均已通过
- 配对规则未证明优于普通 logit-lens
- 评估范围限定为
validated_readout_only,不衡量模型一般准确率,也不建立因果写入基础、自由生成控制或全局工作空间
合成与生成内容说明
- 100 条提示为合成测试提示,不含用户对话、操作记录、参与者数据或私人账户数据
- 涉及组织、员工、个人信息、凭证、实验室或治理决策的场景均为虚构测试案例
- 响应文本、响应 token、前 64 个生成 token 及词汇解码字符串均由
WeiboAI/VibeThinker-3B生成 - 所有响应均从模型的
<think>输出开始,均在 64 token 处截断,通常未包含完整最终答案 - 位置特定的 top-token 读取结果等派生数据并非人类标注、概率或模型置信度分数
用途
该数据集支持以下活动:
- 检查跨层和跨位置的 J lens 解码 token 排名
- 针对固定工件测试静态追踪浏览器
- 重算已发布的读取聚合指标和 bootstrap 区间
- 复现使用已发布读取结果的图表
- 分析合成探针包结构
限制
- 6 个追踪为选定的示例,非代表性基准
- 所有生成均在 64 token 处停止,位于模型的
<think>输出内部 - 100 条提示为测试包,非 1,000 条透镜拟合语料
- 解码 token 排名不表明模型使用了某概念或对应激活导致了某输出
- 生物学提示为合成解释测试,非生物学结果
许可
数据集采用 other 许可,因模型生成输出和派生读取结果在 Qwen 研究许可协议下分发,允许非商业研究或评估用途,含再分发和通知要求。完整条款见 LICENSE 文件。
配套资源
- 源代码及本地渲染器:GitHub 仓库 (源码地址)
- 透镜权重:Hugging Face 模型仓库
- 静态查看器:jvogan.github.io/vibethinker-3b-jlens