gemma-3-27b-it-antislop-ftpo-preference-dataset
收藏资源简介:
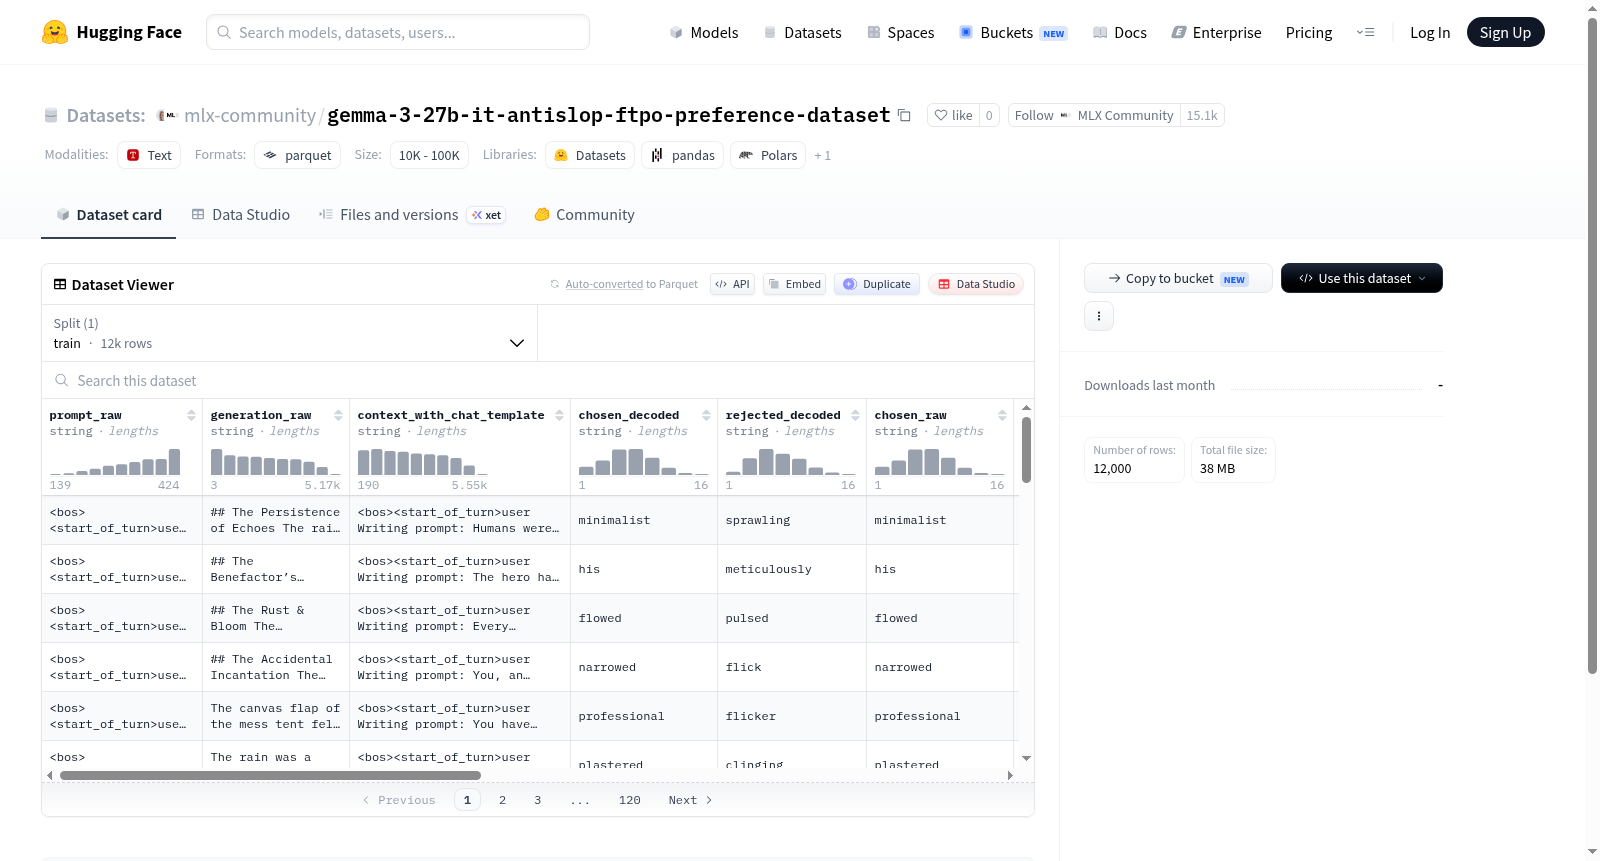
该数据集包含12,000个训练样本,总大小约为61MB,主要用于对话生成或回复质量评估任务。数据集包含多个文本字段:原始提示(prompt_raw)、原始生成内容(generation_raw)、带聊天模板的上下文(context_with_chat_template)、解码后的优选回复(chosen_decoded)和拒绝回复(rejected_decoded)、原始优选回复(chosen_raw)和原始拒绝回复(rejected_raw)。此外,还提供多序列版本的优选和拒绝回复的解码与原始格式(multi_chosen_decoded、multi_chosen_raw、multi_rejected_decoded、multi_rejected_raw)。数据集还包括验证器结构(validator),包含类别(class)、规则(rule)和子类型(subtype)三个字段,可能用于评估回复质量或进行对比学习。数据格式表明这是一个包含优选和拒绝回复对比的数据集,适用于训练模型以区分高质量和低质量回复,但具体数据来源和应用场景未在元数据中说明。
This dataset contains 12,000 training samples with a total size of approximately 61MB, primarily designed for dialogue generation or response quality evaluation tasks. It includes multiple text fields: raw prompt (prompt_raw), raw generation content (generation_raw), context with chat template (context_with_chat_template), decoded preferred response (chosen_decoded) and rejected response (rejected_decoded), raw preferred response (chosen_raw) and raw rejected response (rejected_raw). Additionally, it provides multi-sequence versions of preferred and rejected responses in both decoded and raw formats (multi_chosen_decoded, multi_chosen_raw, multi_rejected_decoded, multi_rejected_raw). The dataset also includes a validator structure (validator) with three fields: class, rule, and subtype, which may be used for assessing response quality or contrastive learning. The data format suggests it is a dataset with comparisons between preferred and rejected responses, suitable for training models to distinguish high-quality from low-quality responses, but specific data sources and application scenarios are not detailed in the provided metadata.
数据集名称
mlx-community/gemma-3-27b-it-antislop-ftpo-preference-dataset
数据集链接
https://huggingface.co/datasets/mlx-community/gemma-3-27b-it-antislop-ftpo-preference-dataset
数据集描述
该数据集是一个用于偏好训练(如FT-PO)的偏好数据集,基于Gemma-3-27B-it模型,专注于减少“slop”(即低质量、冗余或无用的回复)。数据集包含原始提示、模型回复(选中的和拒绝的)以及相关的验证信息。
数据集结构
特征
- prompt_raw:原始提示文本,字符串类型。
- generation_raw:模型生成的原始回复,字符串类型。
- context_with_chat_template:使用了聊天模板的上下文信息,字符串类型。
- chosen_decoded:选中的解码后的回复文本,字符串类型。
- rejected_decoded:拒绝的解码后的回复文本,字符串类型。
- chosen_raw:选中的原始回复文本,字符串类型。
- rejected_raw:拒绝的原始回复文本,字符串类型。
- multi_chosen_decoded:多个选中的解码后的回复序列,字符串序列类型。
- multi_chosen_raw:多个选中的原始回复序列,字符串序列类型。
- multi_rejected_decoded:多个拒绝的解码后的回复序列,字符串序列类型。
- multi_rejected_raw:多个拒绝的原始回复序列,字符串序列类型。
- validator:验证器信息,结构体类型,包含以下子字段:
- class:验证器类别,字符串类型。
- rule:验证规则,字符串类型。
- subtype:验证子类型,字符串类型。
数据划分
- train:训练集
- 文件大小:61,047,606 字节
- 样本数量:12,000
总体规模
- 下载大小:37,990,313 字节
- 数据集总大小:61,047,606 字节
配置文件
- 配置名称:default
- 数据文件路径:训练集文件位于
data/train-*