
遇见数据集

indian-legal-sections-bns-bnss-bsa-2023

收藏
Hugging Face2026-06-26 更新2026-06-29 收录
官方服务:

资源简介:

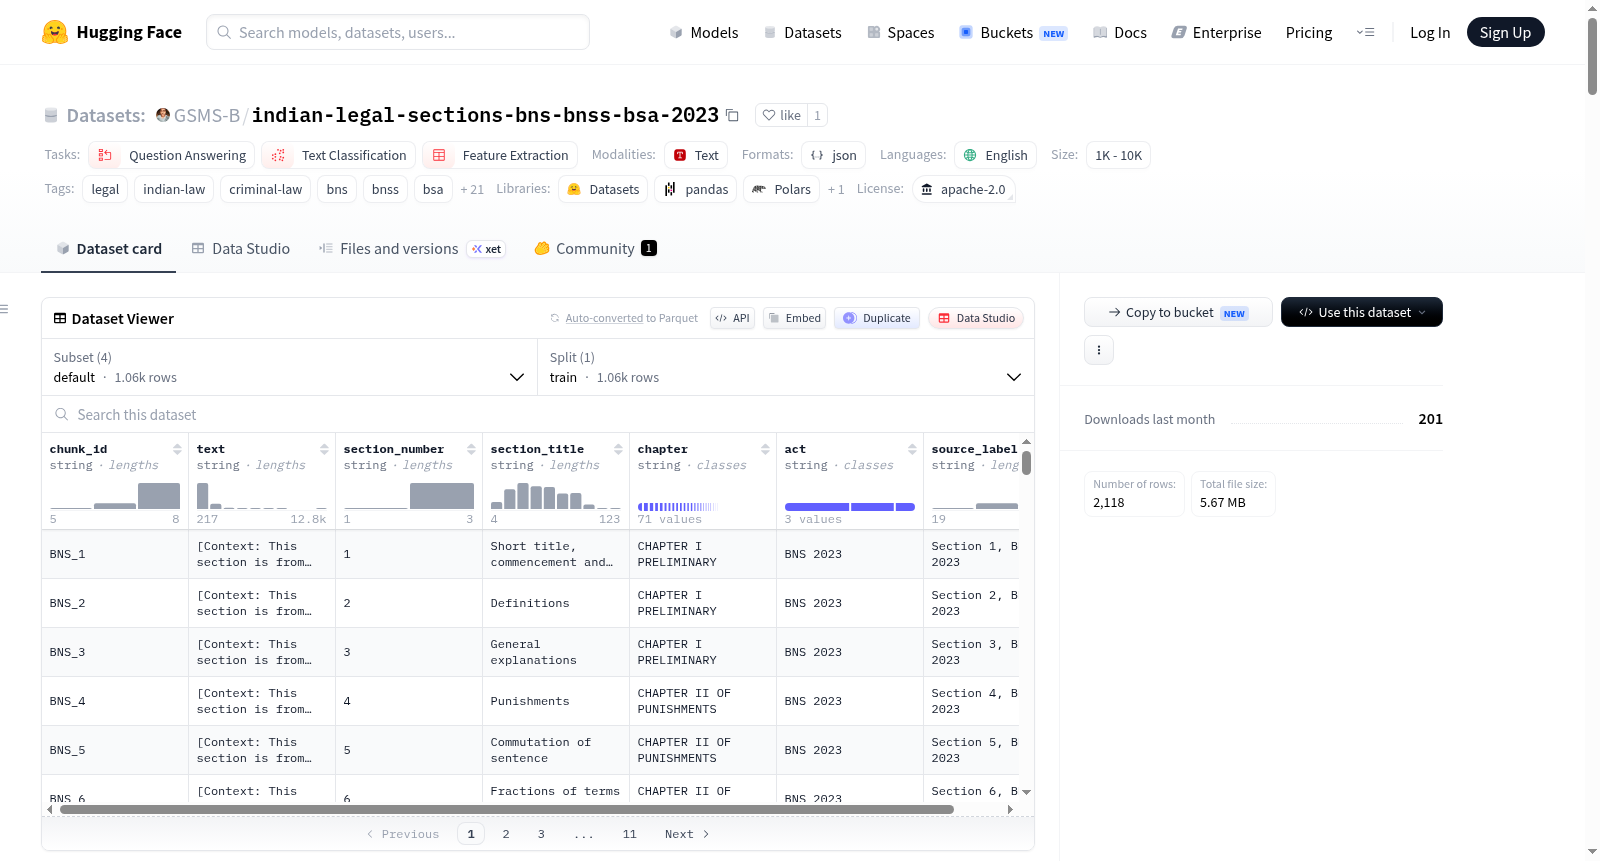
该数据集是印度刑事司法改革法案(2023年)的结构化JSON数据集,包含从印度2023年12月通过的三大里程碑式刑事司法改革法案中提取、解析和统一的1059个完全结构化且经过验证的法律章节。这三大法案共同取代了殖民时代的《印度刑法典》(IPC,1860年)、《刑事诉讼法》(CrPC,1973年)和《印度证据法》(IEA,1872年)。它们于2023年12月25日获得总统批准,并于2024年7月1日正式生效,代表了印度刑事司法系统150多年来最彻底的改革。数据集涵盖了《Bharatiya Nyaya Sanhita, 2023》(BNS,358章,20章)、《Bharatiya Nagarik Suraksha Sanhita, 2023》(BNSS,531章,39章)和《Bharatiya Sakshya Adhiniyam, 2023》(BSA,170章,12章)的全部内容,总计1059章,分属71章。每个条目均为JSON对象,包含七个字段:唯一标识符(chunk_id)、带有上下文标题的完整章节文本(text)、官方章节编号(section_number)、官方章节标题(section_title)、所属章节(chapter)、来源法案(act)以及人类可读的引用标签(source_label)。文本字段经过专门设计,包含预置的上下文标题,使每个数据块在RAG流程中完全自包含。该数据集适用于RAG系统构建印度法律问答、法律语言模型微调、法律AI代理与多智能体系统、法律NLP研究(如章节分类、实体识别、关系映射)以及法律教育与参考工具开发。数据来源于印度政府官方发布的PDF文件,使用pdfplumber进行解析,并经过完整性验证。数据集采用Apache 2.0许可证发布,但请注意,底层法律文本作为印度政府立法文件属于公共领域。该数据集仅供研究、教育和开发用途,不能替代合格的法律建议。

创建时间:
2026-06-19
搜集汇总
数据集介绍
indian-legal-sections-bns-bnss-bsa-2023 数据集图片
构建方式
该数据集源自印度2023年通过的三大刑事司法改革法案——《印度司法法典》《印度公民保护法典》与《印度证据法》的官方PDF文本,通过pdfplumber工具进行自动化文本抽取,并借助基于规则的边界检测算法实现章节与条款的精准分割。每条数据均被封装为结构化的JSON对象,包含唯一标识符、条款正文、章节归属及法案来源等字段,尤其为条款正文预先添加了语境头信息,以增强其在检索增强生成任务中的自包含性。经过人工校验,数据集共计涵盖1059条完整条款,确保了内容的高度准确性与可用性。
特点
本数据集的核心特色在于其统一化、结构化与自描述性。它将三部法案的条款整合至一致的JSON格式中,每一条目均独立附有法案名称、章节标题及人类可读的引用标签,极大简化了跨法案的语义检索与知识推理。更为关键的是,每段条款正文均内嵌了包含上下文描述的引导语句,使其无需依赖外部元数据即可直接嵌入向量数据库,特别适配于法律问答、文本分类与特征提取等自然语言处理场景,为构建专业级法律人工智能系统奠定了坚实的数据基础。
使用方法
该数据集设计精巧,可直接用于三大类应用场景。其一,开发者可将每条数据视为独立的知识单元,利用BAAI/bge-base-en-v1.5等嵌入模型生成向量,配合FAISS或ChromaDB构建法律领域的高效检索增强生成系统,source_label字段可直接作为输出引用。其二,研究者可利用其结构化字段,生成指令对数据以对语言模型进行微调,使其掌握印度新刑法的条文细则。其三,可根据法案属性分配至专门代理,实现多智能体协同,分别处理犯罪定义、诉讼程序与证据规则,从而构建完备的法律推理系统。
背景与挑战
背景概述
2023年12月,印度议会通过了三项具有里程碑意义的刑事司法改革法案——《婆罗多刑法典》(BNS)、《婆罗多公民保护法典》(BNSS)与《婆罗多证据法》(BSA),并于2024年7月1日正式生效,取代了自英国殖民时期沿用逾150年的《印度刑法典》、《刑事诉讼法》与《印度证据法》。这一变革标志着印度刑事司法体系最根本的现代化转型。由研究者GSMS-B创建的本数据集,正是针对这三部全新法典的1059个条文,首次以统一的结构化JSON格式进行提取与整理。该数据集不仅为法律人工智能与自然语言处理领域提供了关键的基础资源,更对印度法律检索增强生成(RAG)系统、法律大语言模型微调及多智能体法律推理系统的研究产生了深远影响。
当前挑战
该数据集所解决的领域问题核心在于:印度原有刑法体系长期依赖殖民时代文本,新旧法典交替带来的法律知识断层亟需可机器解析的结构化资源,以支撑精准的法律问答与推理。构建过程中的挑战则尤为显著:首先,官方PDF文档排版复杂,包含编号体系不一、嵌套子条款、附则及示例等非结构化元素,规则式解析极易遗漏或误判条文边界;其次,三部法典内容相互关联,同一犯罪行为需跨法条引用,确保每一条文在自包含上下文标题下的语义完整性对嵌入模型检索效果至关重要;最后,1059条条文均需人工校验以避免格式伪影,并在统一JSON框架下保留章节归属与出处标签,这对数据清洗与质量保障提出了极高要求。
常用场景
经典使用场景
在自然语言处理与法律人工智能的交叉领域中,该数据集最经典的应用场景当属构建面向印度现代刑法的检索增强生成(RAG)系统。数据集中1059个法律条文均经过精心结构化处理,每一条文的文本字段均自包含完整的上下文头部、条款正文、子条款、例示及例外情形,可直接与嵌入模型和向量数据库无缝对接。研究者可基于此构建端到端的法律问答管道,让模型在回答关于犯罪定义、诉讼程序或证据规则的问题时,精准检索并引用相关法条,从而实现高可靠性的法律信息获取。
解决学术问题
该数据集有效解决了印度刑法数字化研究中的一系列关键学术问题。首先是填补了结构化现代印度刑法语料的空白,由于2023年三部新法全面取代了殖民时代旧法,学术领域亟需一份经核验的统一机器可读数据。其次,数据集为法律自然语言处理中的条文分类、法律命名实体识别、跨法案关系映射以及法律语言建模等任务提供了标准化的基准资源。此外,它还为研究如何将法律文本的层级结构(章节、条款、子句)有效融入神经网络模型提供了宝贵的结构化语料,推动法律文本表示学习的进步。
衍生相关工作
该数据集的出现已催生出一系列令人瞩目的衍生研究工作。研究者基于其分法案结构设计了多智能体法律AI系统,其中分别由BNS智能体负责犯罪定性、BNSS智能体处理程序指引、BSA智能体检视证据规则,三者协同完成复杂的法律推理。在模型微调领域,该数据集被用于生成监督式微调的指令-回答对,训练出一系列专注于印度刑法的轻量级语言模型。此外,利用该数据的跨法案结构化特性,学者们开展了法律文本中的知识图谱构建工作,将不同法案间的引证关系与概念映射呈现为可检索的图结构,为司法决策支持系统奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

