
遇见数据集

kluoms/MultiCloudSRE-Ops

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

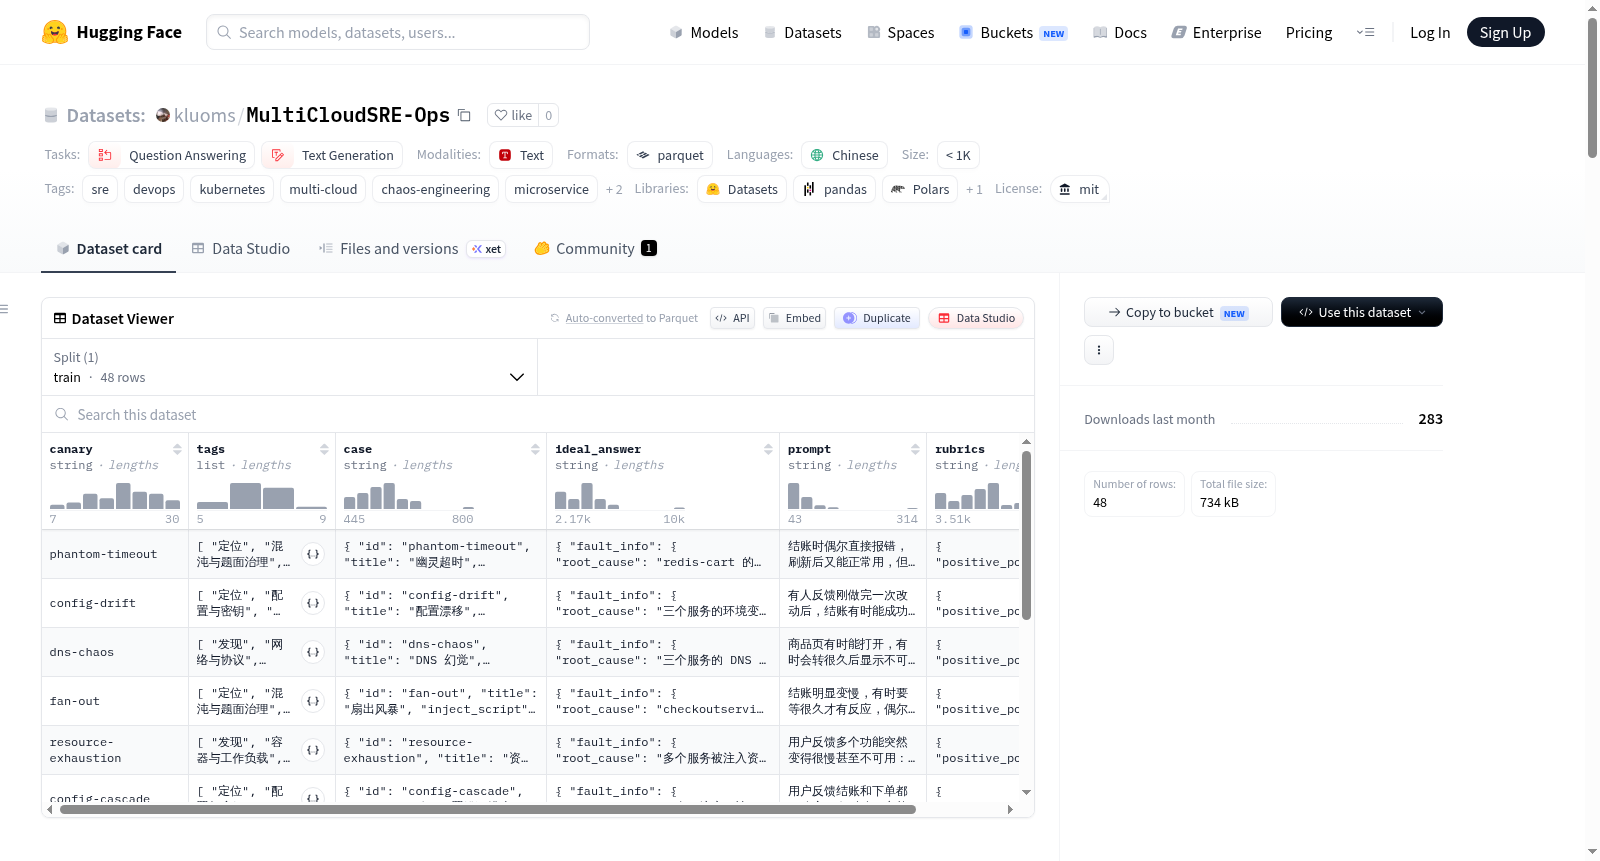
多云运维 SRE 故障排查挑战数据集,基于真实的三朵云(阿里云、腾讯云、AWS)电商微服务系统。该数据集包含25个挑战,覆盖多种故障类型,如幽灵超时、配置漂移、DNS幻觉、扇出风暴、资源耗尽、跨云配置错误、资源限制误配、网络抖动+配置误改、短时故障和综合故障。数据集结构包括题目唯一标识、分类标签、完整的case数据(含注入脚本、恢复脚本、故障现象等)、理想答案(含故障信息、推理过程、验证方法、解决方案等)、评分标准和满分答案prompt。数据按层(如混沌工程层、基础设施层)、子类别(如多故障与干扰、容器与工作负载)和难度(hard、medium)分类,适用于问答和文本生成任务,专注于SRE、DevOps、Kubernetes、多云、混沌工程、微服务、AIOps和故障排除领域。

Multi-Cloud SRE Challenge Dataset, based on a real-world e-commerce microservice system across three clouds (Alibaba Cloud, Tencent Cloud, AWS). This dataset contains 25 challenges covering various fault types, such as ghost timeouts, configuration drift, DNS hallucinations, fan-out storms, resource exhaustion, cross-cloud configuration errors, resource limit misconfigurations, network jitter + configuration errors, transient faults, and comprehensive faults. The dataset structure includes a unique identifier for each challenge, classification tags, complete case data (including injection scripts, recovery scripts, fault phenomena, etc.), ideal answers (including fault information, reasoning process, verification methods, solutions, etc.), scoring rubrics, and full-score answer prompts. Data is categorized by layer (e.g., chaos engineering layer, infrastructure layer), sub-category (e.g., multi-fault and interference, container and workload), and difficulty (hard, medium). It is suitable for question-answering and text-generation tasks, focusing on SRE, DevOps, Kubernetes, multi-cloud, chaos engineering, microservices, AIOps, and troubleshooting domains.
提供机构:
kluoms
搜集汇总
数据集介绍
kluoms/MultiCloudSRE-Ops 数据集图片
构建方式
MultiCloudSRE-Ops数据集基于真实的三朵云(阿里云、腾讯云、AWS)电商微服务系统构建,旨在为多云运维场景下的SRE故障排查提供标准化测试基准。每条数据包含唯一标识符、分类标签、完整的案例数据(含注入与恢复脚本、故障现象)、理想答案(含推理过程、验证方法及解决方案)、评分标准以及待收集的满分答案提示词。数据集的构建通过自动化脚本实现,支持新增题目、手动生成Parquet文件并推送至HuggingFace平台,从而确保深度嵌套的JSON结构能够被高效处理与复用。
使用方法
用户可通过HuggingFace的datasets库直接加载数据集,使用`load_dataset('kluoms/MultiCloudSRE-Ops')`获取训练数据,并访问每条记录的`prompt`、`ideal_answer`、`tags`及`rubrics`等字段进行模型训练或评估。数据集支持问答与文本生成两类任务,适合用于构建AIOps智能排障系统或开发SRE培训考核工具。此外,用户可借助`add_case.py`、`gen_parquet.py`和`push_to_hf.py`脚本扩展新的故障案例,实现持续集成与迭代更新。
背景与挑战
背景概述
随着云原生技术体系的蓬勃发展,多云与混合云架构已成为现代企业基础设施的主流范式。然而,多集群、多服务、多供应商的复杂拓扑结构使得系统可靠性工程(SRE)面临前所未有的挑战。在此背景下,由相关研究团队于2025年创建的MultiCloudSRE-Ops数据集应运而生,专注于模拟基于阿里云、腾讯云和AWS三朵云电商微服务系统中的真实故障场景。该数据集围绕混沌工程与运维排障的核心研究问题,提供了25个涵盖网络、存储、计算及配置等多维度的故障案例,旨在推动AIOps、智能运维和自动化故障诊断等领域的发展。其引入的组合故障与烟雾弹设计,为评估大语言模型在复杂运维场景下的推理与决策能力提供了标准化基准,对云原生时代的智能运维研究具有开创性的影响。
当前挑战
该数据集所解决的领域问题高度聚焦于多云环境下微服务系统的故障诊断与自动恢复,其核心挑战在于真实运维场景中故障的复杂性与隐蔽性。一方面,故障往往并非单一原因所致,而是表现为诸如幽灵超时、配置漂移、扇出风暴等混合型或级联型故障,传统监控手段难以快速定位根因;另一方面,故障现象中常夹杂无关的烟雾弹信息,加剧了推理难度。在数据集构建过程中,挑战同样显著:需要设计高保真的故障注入脚本与恢复流程,并确保跨云环境的一致性;同时,深度嵌套的JSON数据结构给数据存储、加载与评测带来了额外的工程复杂度,必须依赖预构建的Parquet文件方可支持高效解析与使用。
常用场景
经典使用场景
在云计算与微服务架构日益复杂的今天,站点可靠性工程(SRE)领域迫切需要高质量的故障排查训练数据。MultiCloudSRE-Ops数据集正是为此而生,它提供了基于阿里云、腾讯云和AWS真实电商微服务系统的25个挑战题,涵盖从混沌工程、基础设施到应用层等多层次故障场景。该数据集最经典的使用场景是作为SRE工程师能力评估与培训的基准题库,通过模拟幽灵超时、配置漂移、扇出风暴等10类典型故障,帮助团队在安全环境中演练故障定位、根因分析与恢复操作。
解决学术问题
在学术界,该数据集有效缓解了多云环境下SRE研究缺乏标准化、可复现故障样本的难题。它覆盖的故障类型横跨网络、存储、计算和配置等多个维度,为混沌工程、AIOps、微服务韧性评估等领域提供了可量化的测试基准。研究者得以在此数据集上验证故障注入策略的覆盖度、比较不同根因分析算法的精度,以及评估自动故障恢复系统的鲁棒性,从而推动SRE从经验驱动向数据驱动的科学化转型。
实际应用
从实际应用视角来看,该数据集已被集成到SRE团队的日常混沌工程演练和故障推演平台上。运维人员可以基于其中的案例构建自动化的故障注入与恢复流水线,将25个预设场景一键部署到测试环境,进行跨云故障模拟。此外,它还能作为AIOps平台的验证集,用于评估监控告警系统的真实召回率与误报率,协助企业优化运维知识库,提升对短时故障、级联故障等复杂问题的处置效率。
数据集最近研究
最新研究方向
随着多云与混合云架构的广泛普及,站点可靠性工程(SRE)正面临前所未有的复杂性挑战,而混沌工程作为提升系统韧性的核心技术,已成为该领域的前沿研究方向。MultiCloudSRE-Ops数据集应运而生,它基于阿里云、腾讯云和AWS三朵真实云环境,围绕电商微服务系统精心设计了25道高难度故障排查题目,覆盖了从基础设施层、混沌工程层到跨云与级联层的六大维度,并深度囊括了幽灵超时、配置漂移、DNS幻觉、扇出风暴等典型分布式系统顽疾。该数据集不仅通过多重混沌注入与真实故障场景的混合编排,精准模拟了现代云原生环境下的复杂扰动模式,更以AIOps为牵引,为自动化故障根因定位与智能运维研究提供了宝贵的基准测试集。其强调的跨云一致性、级联故障与烟雾弹混淆机制,正呼应了业界对“可观测性驱动弹性”和“智能化故障演练”的迫切需求,有望推动SRE从被动响应迈向预测性自愈的新纪元。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

