
SeaseeYao/charging
收藏官方服务:
资源简介:
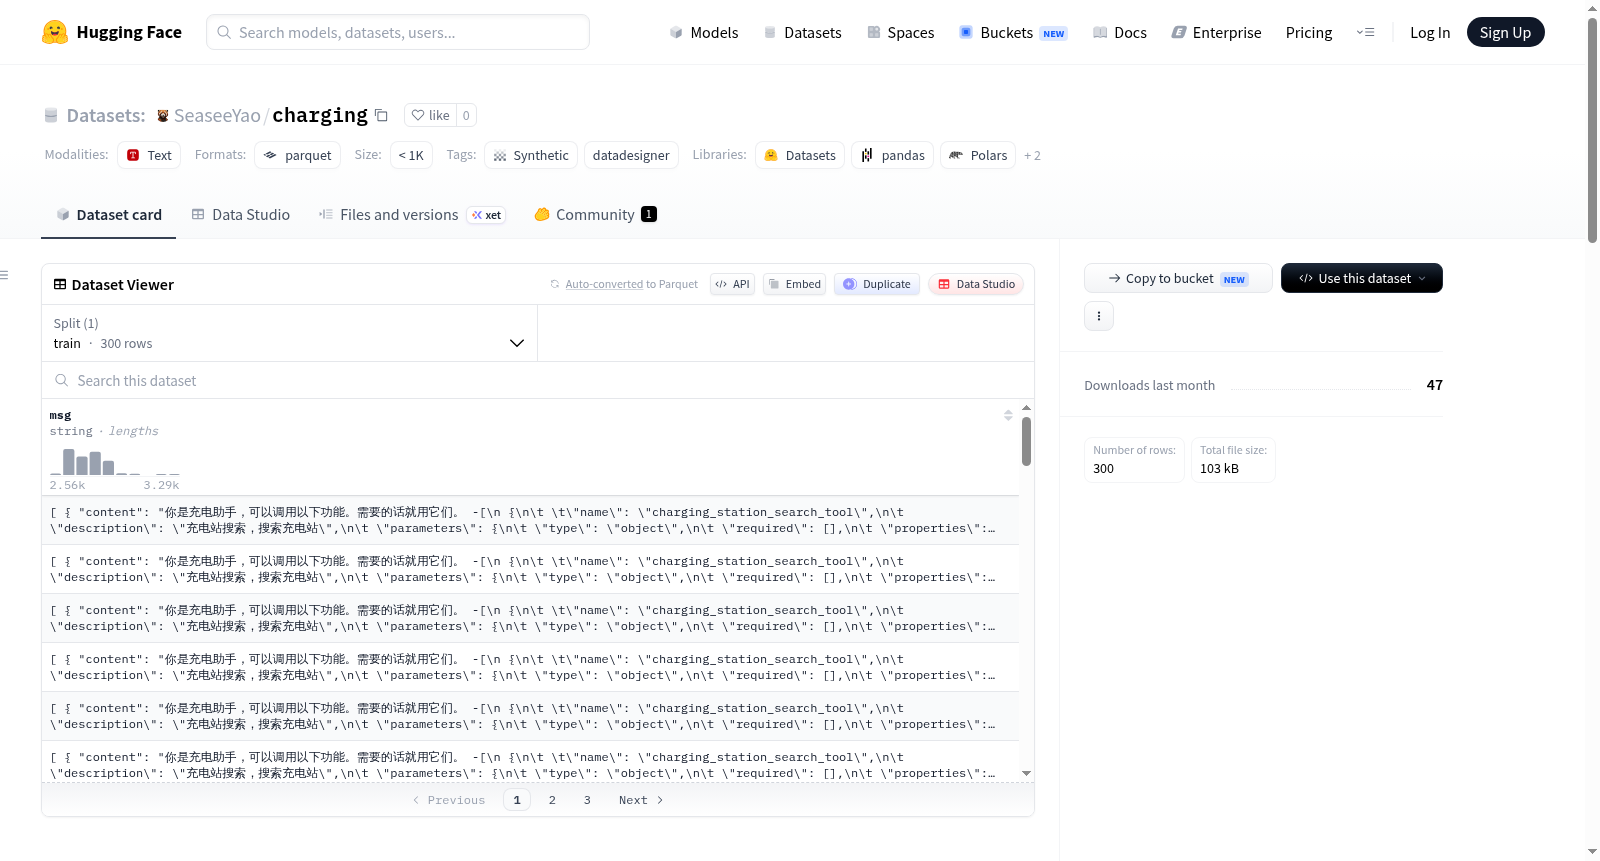
Charging数据集由Unsloth Recipe Studio生成,包含300条生成记录。该数据集具有1列,列名为msg,类型为字符串,用于存储LLM生成的文本。数据集中无空值,唯一值占比72.7%。生成过程使用了2种配置:llm-text和seed-dataset,适用于多轮对话或文本生成任务。
muti_turn_300 was generated with Unsloth Recipe Studio. It contains 300 generated records. The dataset has 1 column named msg of type string for LLM-generated text, with no null values and 72.7% unique values. Generation involved 2 configurations: llm-text and seed-dataset, suitable for multi-turn dialogue or text generation tasks.
提供机构:
SeaseeYao搜集汇总
数据集介绍
构建方式
该数据集名为Charging,由NVIDIA NeMo Data Designer团队开发的Unsloth Recipe Studio框架生成,总计包含300条合成记录。构建过程依托于一种超越简单大语言模型提示的通用框架,通过统计采样器、大语言模型或现有种子数据集实现多样化数据生成。具体配置包括llm-text和seed-dataset两种列类型,生成细节记录于builder_config.json和metadata.json配置文件中,确保了数据生成的可复现性与透明性。
特点
Charging数据集的核心特点在于其合成性与精炼规模。仅含一个名为msg的字符串列,类型为llm-text,占据全部记录,其中唯一值占比72.7%,无空缺值,输入与输出令牌数分别为1929和902。这种单列结构化设计使数据聚焦于对话或文本交互场景,且通过框架的字段关系控制、质量验证与LLM-as-a-judge评分机制,保障了生成数据的多样性与高质量。
使用方法
使用Charging数据集极为简便,用户可通过HuggingFace的datasets库直接加载。推荐执行`load_dataset("SeaseeYao/charging", "data", split="train")`命令获取主数据集,并调用to_pandas()方法将其转换为DataFrame格式以进行后续分析或训练。该数据集适用于快速原型验证、少样本学习或作为种子数据扩充合成语料库,且可通过预览模式先行测试再全量生成,提升迭代效率。
背景与挑战
背景概述
在自然语言处理与多轮对话系统高速发展的当下,高质量交互式数据的稀缺已成为制约模型性能提升的关键瓶颈。由NVIDIA NeMo Data Designer团队于2026年创建的Charging数据集,旨在通过合成数据生成技术填补这一空白。该数据集包含300条经过精心设计的合成多轮对话记录,每条记录均由Unsloth Recipe Studio自动生成,聚焦于充电场景下的用户与系统交互。作为NeMo Data Designer框架的实践成果之一,Charging数据集探索了从种子数据出发、借助统计采样与LLM驱动生成多样化对话样本的方法论,为智能客服、人机交互等领域的模型微调与评估提供了可复现的数据基础。其研究问题直指低资源场景下多轮对话数据的有效构建,对推动合成数据在对话系统中的应用具有示范意义。
当前挑战
Charging数据集所解决的领域核心挑战在于多轮对话中自然语言理解的深度与连贯性。真实世界的充电交互往往涉及模糊用户意图、领域术语混用及上下文依赖的指代消解,传统基于规则或模板生成的数据难以模拟此类复杂情况,导致模型在开放场景下泛化能力不足。构建过程中,团队面临的首要挑战是确保300条合成记录在有限规模内覆盖充电会话的多样性,包括设备类型、异常处理流程及用户情绪波动等变量。其次,依赖LLM自动生成时,需避免重复模式与逻辑断裂,为此NeMo Data Designer引入了字段间关系控制与质量验证器,但如何平衡生成效率与真实性仍是关键难题。此外,数据集仅含单一文本列,缺乏多模态信息,限制了其在更复杂交互任务中的适用性。
常用场景
经典使用场景
在自然语言处理与对话系统研究领域,多轮对话数据集是训练和评估对话模型的核心资源。charging数据集作为一款包含300条记录的精炼合成多轮对话语料库,其经典使用场景在于为中小规模对话生成任务提供高质量的种子数据。研究者可借助该数据集进行对话上下文理解、用户意图识别以及回复生成等基础模型的快速原型开发与验证,尤其适用于资源受限的场景下对模型能力的初步测试与迭代优化。
衍生相关工作
围绕charging数据集,学界已衍生出多项相关研究工作,包括基于该数据集的多轮对话增强生成方法、对话数据质量验证框架以及低资源对话模型的迁移学习策略。这些工作进一步验证了合成数据在对话系统研究中的有效性,并拓展了其在跨领域对话生成、对话数据蒸馏等前沿方向的应用。数据集本身作为NVIDIA NeMo Data Designer工具链的示范案例,也促进了合成数据生成工具与理论的协同发展。
数据集最近研究
最新研究方向
当前,充电行为数据集的研究前沿正聚焦于利用合成数据生成技术来弥补真实充电场景数据的稀缺性与隐私壁垒。该数据集通过NVIDIA NeMo Data Designer框架,采用统计采样与大语言模型协同的策略,自主合成了300条多轮对话记录,模拟了充电过程中的用户交互与指令解析。这一方向与智能能源管理、电动汽车充电调度优化等热点事件紧密关联,为训练高效的人机对话系统、充电桩故障诊断模型以及用户意图分析算法提供了高质量的种子数据。其意义在于突破了传统数据采集的高昂成本与标注瓶颈,加速了充电基础设施智能化进程,并为构建可复现、可扩展的交通能源大数据研究生态奠定了基础。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


