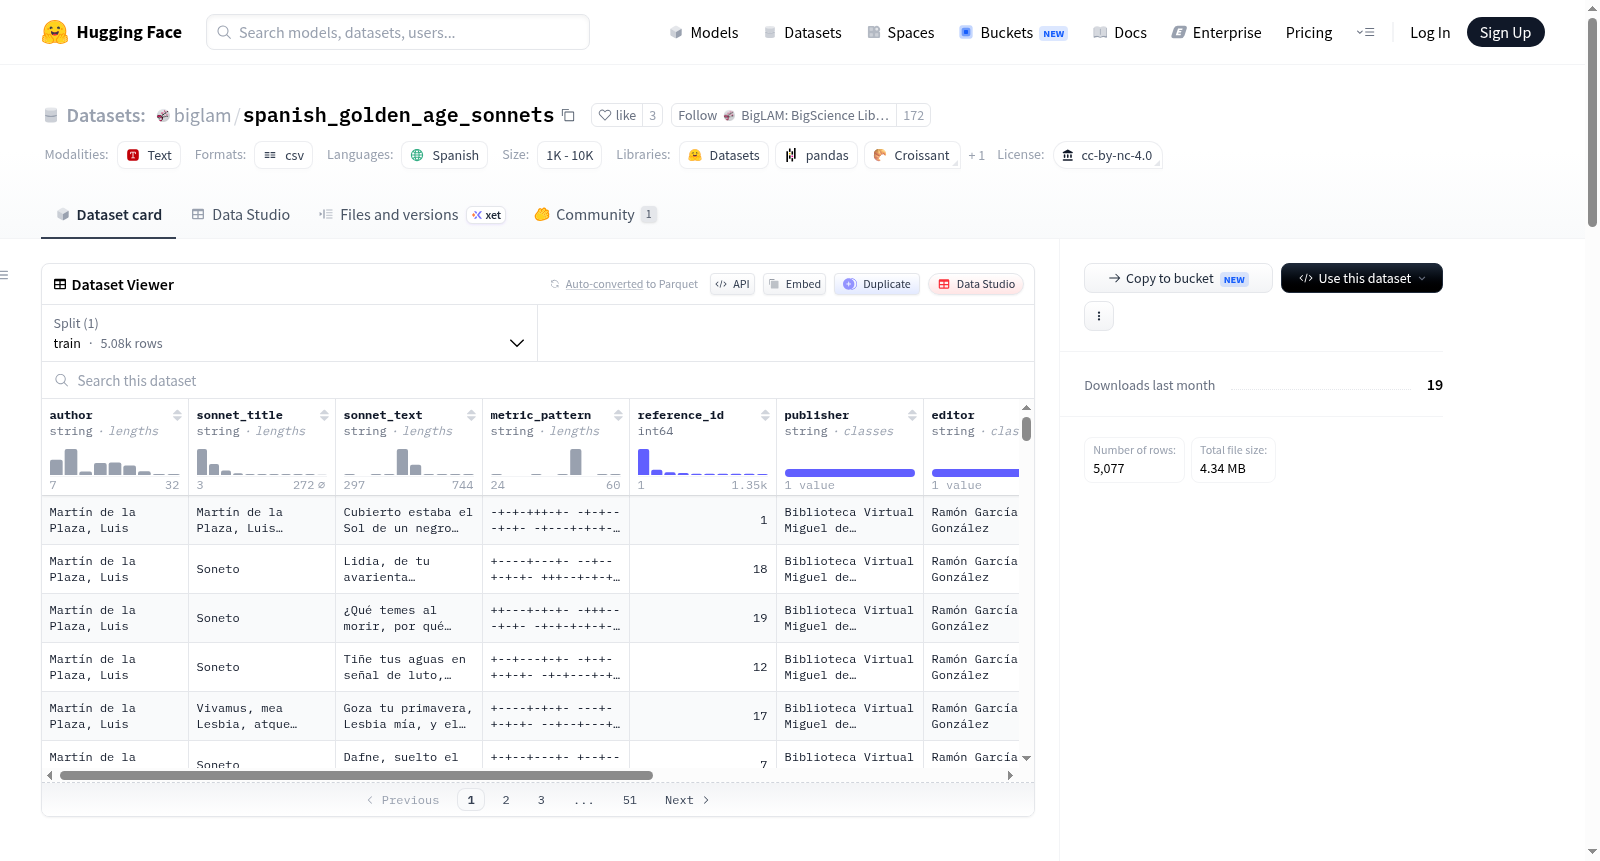
biglam/spanish_golden_age_sonnets
收藏资源简介:
--- annotations_creators: [] language: - es language_creators: [] license: - cc-by-nc-4.0 multilinguality: - monolingual pretty_name: Spanish Golden-Age Sonnets size_categories: [] source_datasets: [] tags: [] task_categories: [] task_ids: [] --- [](https://zenodo.org/badge/latestdoi/46981468) # Corpus of Spanish Golden-Age Sonnets ## Introduction This corpus comprises sonnets written in Spanish between the 16th and 17th centuries. This corpus is a dataset saved in .csv, from a previous one in .xml. All the information of the original dataset can be consulted in [its original repository](https://github.com/bncolorado/CorpusSonetosSigloDeOro). Each sonnet has been annotated in accordance with the TEI standard. Besides the header and structural information, each sonnet includes the formal representation of each verse’s particular **metrical pattern**. The pattern consists of a sequence of unstressed syllables (represented by the "-" sign) and stressed syllables ("+" sign). Thus, each verse’s metrical pattern is represented as follows: "---+---+-+-" Each line in the metric_pattern codifies a line in the sonnet_text column. ## Column description - 'author' (string): Author of the sonnet described - 'sonnet_title' (string): Sonnet title - 'sonnet_text' (string): Full text of the specific sonnet, divided by lines ('\n') - 'metric_pattern' (string): Full metric pattern of the sonnet, in text, with TEI standard, divided by lines ('\n') - 'reference_id' (int): Id of the original XML file where the sonnet is extracted - 'publisher' (string): Name of the publisher - 'editor' (string): Name of the editor - 'research_author' (string): Name of the principal research author - 'metrical_patterns_annotator' (string): Name of the annotation's checker - 'research_group' (string): Name of the research group that processed the sonnet ## Poets With the purpose of having a corpus as representative as possible, every author from the 16th and 17th centuries with more than 10 digitalized and available sonnets has been included. All texts have been taken from the [Biblioteca Virtual Miguel de Cervantes](http://www.cervantesvirtual.com/). Currently, the corpus comprises more than 5,000 sonnets (more than 71,000 verses). ## Annotation The metrical pattern annotation has been carried out in a semi-automatic way. Firstly, all sonnets have been processed by an automatic metrical scansion system which assigns a distinct metrical pattern to each verse. Secondly, a part of the corpus has been manually checked and errors have been corrected. Currently the corpus is going through the manual validation phase, and each sonnet includes information about whether it has already been manually checked or not. ## How to cite this corpus If you would like to cite this corpus for academic research purposes, please use this reference: Navarro-Colorado, Borja; Ribes Lafoz, María, and Sánchez, Noelia (2015) "Metrical annotation of a large corpus of Spanish sonnets: representation, scansion and evaluation" 10th edition of the Language Resources and Evaluation Conference 2016 Portorož, Slovenia. ([PDF](http://www.dlsi.ua.es/~borja/navarro2016_MetricalPatternsBank.pdf)) ## Further Information This corpus is part of the [ADSO project](https://adsoen.wordpress.com/), developed at the [University of Alicante](http://www.ua.es) and funded by [Fundación BBVA](http://www.fbbva.es/TLFU/tlfu/ing/home/index.jsp). If you require further information about the metrical annotation, please consult the [Annotation Guide](https://github.com/bncolorado/CorpusSonetosSigloDeOro/blob/master/GuiaAnotacionMetrica.pdf) (in Spanish) or the following papers: - Navarro-Colorado, Borja; Ribes-Lafoz, María and Sánchez, Noelia (2016) "Metrical Annotation of a Large Corpus of Spanish Sonnets: Representation, Scansion and Evaluation" [Proceedings of the Tenth International Conference on Language Resources and Evaluation (LREC 2016)](http://www.lrec-conf.org/proceedings/lrec2016/pdf/453_Paper.pdf) Portorož, Slovenia. - Navarro-Colorado, Borja (2015) "A computational linguistic approach to Spanish Golden Age Sonnets: metrical and semantic aspects" [Computational Linguistics for Literature NAACL 2015](https://sites.google.com/site/clfl2015/), Denver (Co), USA ([PDF](https://aclweb.org/anthology/W/W15/W15-0712.pdf)). ## License The metrical annotation of this corpus is licensed under a Creative Commons Attribution-Non Commercial 4.0 International License. About the texts, "this digital object is protected by copyright and/or related rights. This digital object is accessible without charge, but its use is subject to the licensing conditions set by the organization giving access to it. Further information available at http://www.cervantesvirtual.com/marco-legal/ ".
注释创建者:[] 语言: - 西班牙语(es) 语言创建者:[] 许可协议: - CC-BY-NC-4.0(知识共享署名-非商业性使用4.0国际许可协议) 多语言性: - 单语言 数据集昵称:西班牙黄金时代十四行诗语料库 规模类别:[] 源数据集:[] 标签:[] 任务类别:[] 任务子项:[] [](https://zenodo.org/badge/latestdoi/46981468) # 西班牙黄金时代十四行诗语料库 ## 简介 本语料库收录了16至17世纪以西班牙语创作的十四行诗。 本语料库为.csv格式的数据集,源自此前的.xml格式原始数据集。原始数据集的全部信息可查阅[其官方仓库](https://github.com/bncolorado/CorpusSonetosSigloDeOro)。 每首十四行诗均已按照**TEI(文本编码倡议,Text Encoding Initiative)**标准完成注释。除表头与结构信息外,每首诗还包含每一行诗句的专属**格律模式(metrical pattern)**的形式化表征。 该模式由非重读音节(以符号"-"表示)与重读音节(以符号"+"表示)的序列构成。因此,每一行诗句的格律模式可按如下形式表示: "---+---+-+-" 格律模式列(metric_pattern)中的每一行,均对应十四行诗文本列(sonnet_text)中的一行诗句。 ## 列说明 - `author`(字符串型):所描述十四行诗的作者 - `sonnet_title`(字符串型):十四行诗标题 - `sonnet_text`(字符串型):指定十四行诗的完整文本,以换行符(` `)分隔各行诗句 - `metric_pattern`(字符串型):十四行诗的完整格律模式,采用TEI标准格式,以换行符(` `)分隔各行的格律表征 - `reference_id`(整数型):该十四行诗所源自的原始XML文件的编号 - `publisher`(字符串型):出版方名称 - `editor`(字符串型):编辑者姓名 - `research_author`(字符串型):核心研究作者姓名 - `metrical_patterns_annotator`(字符串型):格律模式注释的审核者姓名 - `research_group`(字符串型):处理该十四行诗的研究团队名称 ## 诗人收录 为确保语料库具备充分代表性,本语料库纳入了16至17世纪中,现存数字化十四行诗数量超过10首的所有创作者。 所有文本均取自[米格尔·德·塞万提斯虚拟图书馆(Biblioteca Virtual Miguel de Cervantes)](http://www.cervantesvirtual.com/)。 目前,本语料库收录的十四行诗已超过5000首,对应诗句总量逾71000行。 ## 注释流程 格律模式注释采用半自动化方式完成:首先,通过自动格律扫描系统处理全部十四行诗,为每一行诗句分配专属格律模式;其次,对语料库的部分内容进行人工审核并修正错误。 目前,本语料库正处于人工验证阶段,每首十四行诗均标注了是否已完成人工审核。 ## 语料库引用方式 若您在学术研究中需引用本语料库,请使用如下著录格式: Navarro-Colorado, Borja; Ribes Lafoz, María, 及 Sánchez, Noelia (2015) 《西班牙语十四行诗大型语料库的格律注释:表征、扫描与评估》,第十届语言资源与评价会议(LREC 2016),斯洛文尼亚波托鲁日。([PDF](http://www.dlsi.ua.es/~borja/navarro2016_MetricalPatternsBank.pdf)) ## 补充信息 本语料库为[ADSO项目](https://adsoen.wordpress.com/)的组成部分,由阿利坎特大学(University of Alicante)开发,西班牙对外银行基金会(Fundación BBVA)资助。 若您需要获取格律注释的更多信息,请查阅[《注释指南》](https://github.com/bncolorado/CorpusSonetosSigloDeOro/blob/master/GuiaAnotacionMetrica.pdf)(西班牙语版本)或以下论文: - Navarro-Colorado, Borja; Ribes-Lafoz, María 及 Sánchez, Noelia (2016) 《西班牙语十四行诗大型语料库的格律注释:表征、扫描与评估》,[第十届国际语言资源与评价会议论文集(LREC 2016)](http://www.lrec-conf.org/proceedings/lrec2016/pdf/453_Paper.pdf),斯洛文尼亚波托鲁日。 - Navarro-Colorado, Borja (2015) 《西班牙黄金时代十四行诗的计算语言学研究:格律与语义维度》,[文学计算语言学研讨会(NAACL 2015)](https://sites.google.com/site/clfl2015/),美国丹佛市([PDF](https://aclweb.org/anthology/W/W15/W15-0712.pdf))。 ## 许可协议 本语料库的格律注释内容采用知识共享署名-非商业性使用4.0国际许可协议(CC BY-NC 4.0)进行授权。 关于文本内容:"本数字对象受著作权及/或相关权利保护。本数字对象可免费获取,但使用需遵循提供访问权限的机构所设定的许可条款。更多信息请查阅http://www.cervantesvirtual.com/marco-legal/ "。
西班牙黄金时代十四行诗数据集概述
数据集基本信息
- 名称: 西班牙黄金时代十四行诗
- 语言: 西班牙语
- 许可证: 知识共享非商业性4.0国际许可(CC-BY-NC-4.0)
- 多语言性: 单语种
- 数据集大小: 超过5,000首十四行诗(超过71,000行)
数据集内容
- 时间范围: 16世纪至17世纪
- 数据来源: 所有文本来自Biblioteca Virtual Miguel de Cervantes
- 数据格式: .csv格式,源自.xml格式
- 数据集结构:
- 列描述:
author(字符串): 十四行诗的作者sonnet_title(字符串): 十四行诗的标题sonnet_text(字符串): 完整的十四行诗文本,按行分割metric_pattern(字符串): 十四行诗的完整韵律模式,按行分割reference_id(整数): 原始XML文件中十四行诗的IDpublisher(字符串): 出版者名称editor(字符串): 编辑名称research_author(字符串): 主要研究作者名称metrical_patterns_annotator(字符串): 韵律模式注释者名称research_group(字符串): 处理十四行诗的研究组名称
- 列描述:
数据集特点
- 韵律模式: 每首十四行诗包含其韵律模式的文本表示,使用TEI标准,由一系列非重读音节("-"表示)和重读音节("+"表示)组成。
- 注释方法: 韵律模式的注释采用半自动方式,首先通过自动韵律扫描系统处理,然后部分数据集进行人工检查和错误修正。
引用信息
- 引用格式:
- Navarro-Colorado, Borja; Ribes Lafoz, María, and Sánchez, Noelia (2015) "Metrical annotation of a large corpus of Spanish sonnets: representation, scansion and evaluation" 10th edition of the Language Resources and Evaluation Conference 2016 Portorož, Slovenia.
版权与许可
- 韵律注释: 根据知识共享非商业性4.0国际许可(CC-BY-NC-4.0)授权。
- 文本版权: 受版权和相关权利保护,使用受提供访问的组织设定的许可条件限制。