
bismarck91/sm-cv-en-hi
收藏官方服务:
资源简介:
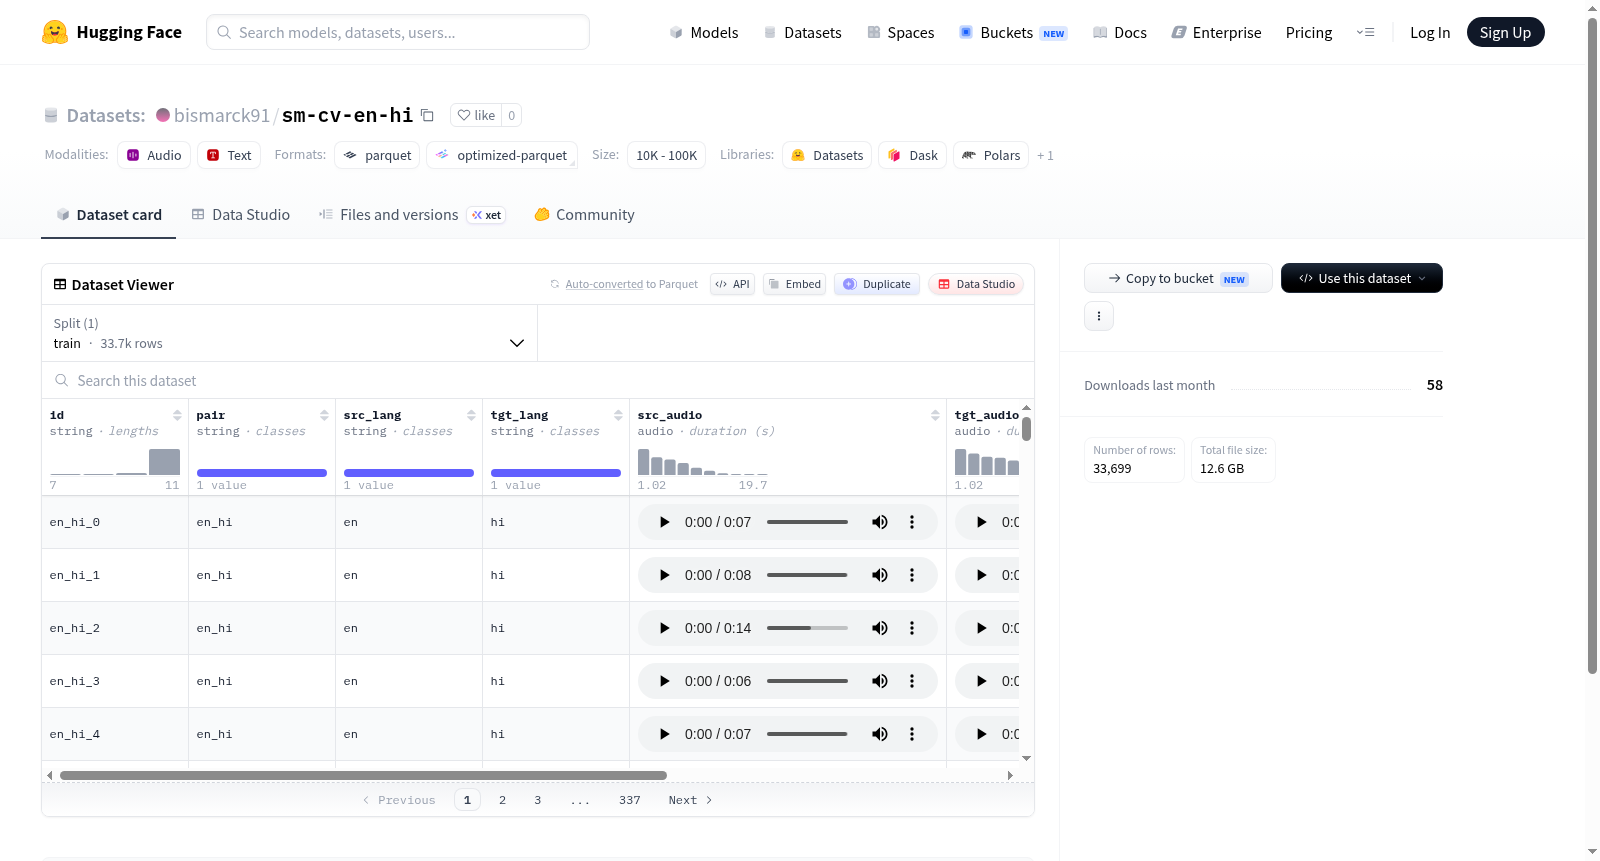
这是一个多语言语音-文本数据集,包含33,699个训练示例,每个示例有源语言和目标语言的音频和文本特征。音频采样率为16kHz,特征包括id、语言对标识、源语言、目标语言、源音频、目标音频、源文本令牌和目标文本令牌。数据集可能用于语音翻译、跨语言处理或语音识别任务,支持多种语言组合。
This is a multilingual speech-text dataset containing 33,699 training examples, each with audio and text features for source and target languages. The audio has a sampling rate of 16kHz, and features include id, pair identifier, source language, target language, source audio, target audio, source text tokens, and target text tokens. The dataset is likely intended for speech translation, cross-lingual processing, or speech recognition tasks, supporting multiple language combinations.
提供机构:
bismarck91搜集汇总
数据集介绍
构建方式
该数据集名为sm-cv-en-hi,专注于英语与印地语之间的语音翻译任务。其构建方式基于大规模语音数据的收集与精心配对,每条样本包含源语言与目标语言的音频文件,均以16kHz采样率存储,并附有对应的文本令牌序列。数据集的来源可能源自Common Voice等开源语音项目,经过筛选与对齐形成双语语音对,确保音频与文本在语义和时序上的一致性。训练集包含33,699个样本,总数据量约13.9GB,为模型提供了丰富的双语语音学习资源。
特点
该数据集的核心特点在于其结构化的双语语音对设计,每条记录均包含源语言与目标语言的完整音频及对应令牌,便于直接用于端到端语音翻译系统的训练。音频采样率统一为16kHz,符合主流语音处理模型的标准输入要求。数据集仅提供训练集划分,无验证或测试集,暗示其可能专注于模型预训练或领域适应。此外,字段中包含语言标签(src_lang与tgt_lang),支持灵活的多语言扩展与配对组合。
使用方法
使用该数据集时,可借助HuggingFace的datasets库加载,通过指定config_name为'default'并引用data/train-*路径即可读取训练数据。每个样本的src_audio和tgt_audio字段直接提供音频数组及采样率,适合输入语音编码器;src_tokens与tgt_tokens为令牌序列,可用于文本解码器的损失计算。推荐结合Transformer架构的语音翻译模型,如Whisper或Fairseq Speech-to-Text,进行端到端训练。数据集的完整性与标准化设计显著降低了预处理复杂度。
背景与挑战
背景概述
sm-cv-en-hi数据集是面向英语和印地语语音翻译任务构建的双语平行语音语料库,由相关研究团队于近年创建。该数据集聚焦于跨语言语音到语音翻译这一前沿问题,核心研究目的在于推动低资源语言对(英语-印地语)在端到端语音翻译模型上的发展。通过提供对齐的双语语音片段及其对应的文本分词序列,该数据集为探索语音表征学习、跨语言语义对齐等技术提供了关键资源,在推动印地语自然语言处理及语音技术研究方面具有重要影响力。
当前挑战
数据集所解决的领域核心挑战在于英语与印地语之间语音翻译的模型训练数据匮乏问题,尤其是低资源场景下缺乏大规模高质量的平行语音数据。在构建过程中,主要挑战包括:首先,确保双语语音片段在语义和时长上的严格对齐,这需要复杂的预处理流程;其次,收集并清洗包含印地语方言及口音变化的语音数据,以增强模型的泛化能力;最后,对音频进行统一采样率(16kHz)标准化并生成对应的文本分词序列,环节中的误差控制直接影响模型训练效果。
常用场景
经典使用场景
sm-cv-en-hi数据集是一个聚焦于英语与印地语之间语音翻译任务的平行语料库,其独特之处在于包含了源语言和目标语言的音频对及对应的文本令牌。该数据集最经典的用途在于训练端到端的语音翻译模型,使得模型能够直接从英语语音输入生成印地语语音输出,省去了传统的语音识别与机器翻译级联流程,为低资源语言对之间的直接语音转换提供了坚实的数据支撑。
实际应用
在实际应用中,sm-cv-en-hi数据集可赋能实时语音翻译设备的开发,例如双语会议同传工具、跨国客服系统中的语音助手,以及面向南亚地区游客的便携翻译器。这些场景要求系统在无文本中介的情况下迅速将英语口语转化为印地语语音,该数据集提供的配对音频样本恰好满足了模型训练对真实环境声学特征和发音变异的覆盖需求。
衍生相关工作
基于此数据集,学术界衍生出了一系列经典工作,包括但不限于利用预训练语音编码器结合跨注意力机制实现语音到语音的端到端翻译,以及引入对比学习策略以增强双语语音表征的语义对齐。相关研究还涉及数据增强方法,如通过语音合成扩充印地语音频覆盖范围,以及设计鲁棒性评估基准来度量模型在不同噪声条件下的翻译质量。
以上内容由遇见数据集搜集并总结生成


