
遇见数据集

VynFi/vynfi-je-network-2k

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

VynFi日记账网络——2,000实体集团合并边数据集是一个合成数据集,包含68,463,796条日记账网络边,由v5.31集团审计模拟引擎生成,覆盖2,000个实体及合并财务报表包。每条边代表单个日记账分录中的一个借方↔贷方关系,附带其源实体属性,并包含从生成器传递的文档链、欺诈/异常标签和公司间配对标签。数据集适用于边级欺诈检测(二元或多类分类)、账户网络/文档链分析(通过predecessor_edge_id重构文档流路径)、公司间匹配/抵消研究(标记6,814对公司间配对和13,628条消除边)以及异常注入基准测试(is_anomaly标志非欺诈异常)。数据为合成生成,不包含真实客户或语料内容,实体名称、账户和金额均为合成数据。

VynFi JE Network — 2 000-entity group consolidated edges is a synthetic dataset of 68,463,796 journal-entry network edges produced by the v5.31 group-audit simulation engine over 2,000 entities plus a consolidated financial statement bundle. Each row represents one debit↔credit edge from a single journal entry, attributed to its source entity, with document-chain, fraud/anomaly, and intercompany-pair labels carried through from the generator. The dataset is designed for edge-level fraud detection (binary or multi-class classification), account-network/document-chain analytics (reconstructing paths via predecessor_edge_id), intercompany matching/elimination research (with 6,814 IC pairs and 13,628 elimination edges), and anomaly-injection benchmarking (using is_anomaly flags). All data is procedurally generated, with no real client or corpus content; entity names, accounts, and amounts are synthetic.
提供机构:
VynFi
搜集汇总
数据集介绍
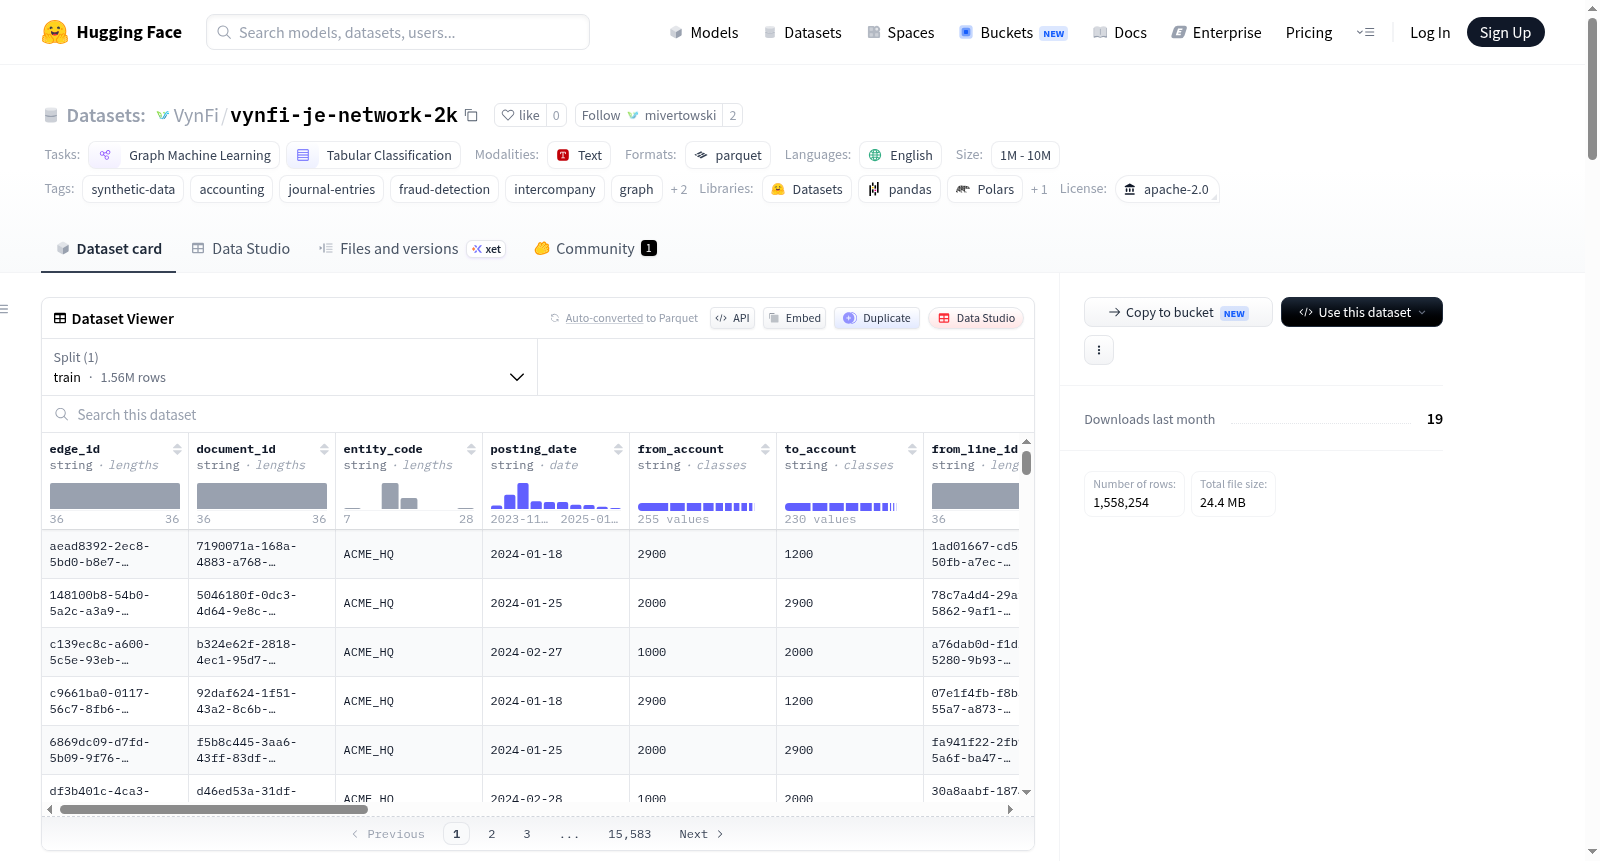
VynFi/vynfi-je-network-2k 数据集图片
构建方式
该数据集由VynFi v5.35.1组审计模拟引擎生成,覆盖2000个实体及其合并财务报表。构建过程首先通过每实体编排器运行SOTA引擎,利用多币种、源条件Dirichlet账户对采样、前50种原型覆盖、定期及标准日记账模板、业务单元维度、冲销与更正流程以及重尾合并异常等技术,生成各实体的日记账条目。随后,通过流式聚合器将条目逐笔输入JeNetworkEdgeBuilder,维护行ID至边ID的映射以构建跨条目前驱链。接着,使用按值匹配器对买卖双方进行100%覆盖的公司间匹配,形成6814对IC对。最终,通过消除工厂基于清单驱动的名义金额,结合三级金额解析回退机制,生成13628条消除边,有效处理上游异常注入导致的潜在损坏。
特点
该数据集包含1,558,254条日记账网络边,每条边代表一条借方与贷方之间的有向连接,附有源自其源实体的文档链、欺诈或异常标签以及公司间配对标识。其核心特色在于提供边级的欺诈检测任务,支持二分类或多分类(fraud_type),可直接用于GNN框架。同时,数据集通过前驱边ID预建文档流路径(如采购订单至发票至付款),无需额外连接操作。此外,它拥有6814个公司间配对及13628条消除边,标注了is_eliminated和elimiates_ic_pair_id,便于公司间匹配与消除研究。非欺诈异常(如错误、过程偏差)通过is_anomaly标志区分,欺诈类型则通过fraud_type枚举详细分类,适用于异常注入基准测试。
使用方法
数据以Parquet格式存储,总大小约5.8 GB,包含66个行组。用户可通过PyArrow的pq.read_table或pq.ParquetFile读取整个数据集或逐行组流式加载,转换为Pandas DataFrame以便分析。对于边级欺诈检测任务,可直接提取from_account和to_account作为边索引,配合is_fraud标签构建图神经网络(如PyTorch Geometric或DGL)的边索引与标签。若需解析文档链,可依据predecessor_edge_id字段追踪路径。公司间配对研究则利用ic_pair_id、ic_partner_entity及is_eliminated字段进行分析。数据集提供确定性复现能力,通过manifest中的seed字段控制随机性。
背景与挑战
背景概述
VynFi JE Network — 2 000-entity group consolidated edges数据集由Michael Ivertowski于2026年依托合成数据引擎v5.31构建,旨在为企业集团审计与会计欺诈检测提供大规模图结构基准。该数据集模拟了包含2000个法人实体及合并报表的复杂财务网络,生成了逾155万条日记账分录边,每条边携带完整的凭证链、欺诈标注与内部交易对信息。在会计信息系统中,日记账分录天然形成有向网络,而传统欺诈检测方法多基于表格特征,忽视了实体间资金流动的结构性关联。该数据集填补了图机器学习在审计领域缺乏大规模、标注完整的公开基准的空白,为图神经网络、异常注入评估与内部交易对消研究提供了标准化实验平台,推动跨公司财务监控从规则驱动向数据驱动范式转型。
当前挑战
该数据集核心解决的领域问题在于:企业集团财务数据中,欺诈交易通常隐藏在复杂的跨实体、跨流程凭证链中,传统孤立分析各分录表格的方法难以捕捉异常传播的拓扑模式。构建过程中面临多重挑战:首先,引擎需在内存限制下(峰值仅0.382 GB)处理2000个实体的海量交易流,通过流式边构建算法避免218 GB内存溢出;其次,需保证内部交易匹配(6814对)与对消边缘(13628条)的准确性,引入三级金额回退机制应对上游异常注入产生的借贷翻转;最后,合成数据需在统计特性上逼近真实会计分布,通过Benford定律检验(MAD约0.001)和重尾异常注入平衡仿真真实度与可控性。
常用场景
经典使用场景
在现代企业审计与会计信息系统中,VynFi JE Network数据集凭借其高度仿真的合成记账网络结构,成为图神经网络(GNN)应用于边缘级欺诈检测的经典基准。该数据集包含超过150万条借贷方向的边,每个边携带欺诈、异常及集团内部交易标记,特别适合训练GNN模型以识别隐藏在复杂凭证链条中的欺诈模式。研究者可利用其提供的`from_account`至`to_account`有向边结构,直接嵌入PyTorch Geometric或DGL框架,开展端到端的欺诈分类实验,从而评估不同图学习方法在财务异常检测中的性能。
衍生相关工作
基于此数据集,研究社区已催生了一系列标志性工作:首先是利用其姊妹数据集`vynfi-journal-entries-1m`训练的GNN模型`vynfi-je-fraud-gnn`,展示了图卷积网络在凭证层级欺诈分类上的有效性;其次,数据集的生成引擎(mivertowski/SyntheticData)推动了可复现合成审计数据的方法论发展,包括多货币、Dirichlet账户对采样及合并异常注入等技术。此外,不同研究团队利用该数据集的边缘级属性开展预训练特征表示学习与少样本欺诈检测实验,进一步拓展了图结构数据在财务网络分析中的应用边界,成为该领域新模型评估的事实标准。
数据集最近研究
最新研究方向
该数据集聚焦于企业集团内部审计中的图神经网络(GNN)欺诈检测前沿方向,通过合成2000个实体的155万条日记账分录边数据,模拟了跨公司交易匹配、合并抵消以及异常注入等复杂场景。其核心创新在于构建了包含19个维度的边级特征体系,支持从账户流向、文档链到欺诈类型的多粒度分析,为图机器学习在财务审计领域的应用提供了基准测试平台。特别是该数据集对汇兑波动、极值分布和Benford定律匹配度的精细校准,使其成为研究集团审计中异常模式识别、跨实体链路追踪以及合成数据与现实审计场景对齐的关键参考,对于推动自动化审计和金融合规领域的大规模实验具有重要方法论意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

