
遇见数据集

GD-ML/Taming-Hallucinations

收藏
Hugging Face2026-06-03 更新2026-06-14 收录
官方服务:

资源简介:

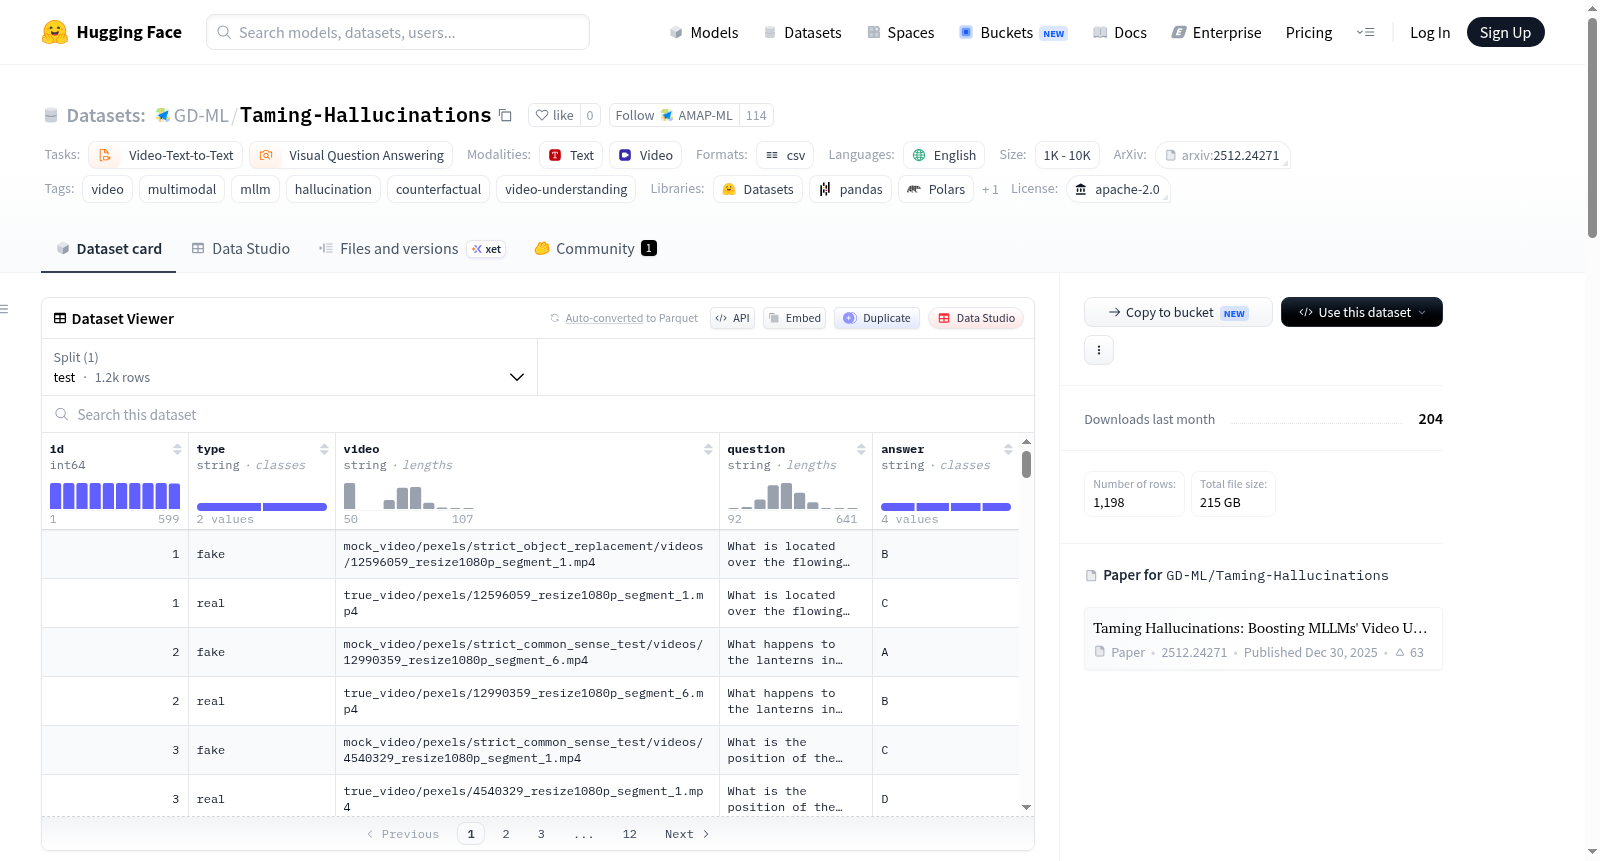
该存储库托管了“DualityVidQA”,这是由论文《Taming Hallucinations: Boosting MLLMs Video Understanding via Counterfactual Video Generation》引入的大规模配对视频-QA数据集。Taming Hallucinations 引入了 DualityForge,一个基于可控扩散的框架,将真实视频转换为反事实视频,自动生成配对(真实/反事实)视频及其问答数据以进行对比训练。基于 DualityVidQA 和提出的 DNA-Train SFT-RL 机制(使用 ℓ1 归一化优势),该方法将多模态 LLM 的幻觉减少了 24%,并在多个基准测试中表现出强大的泛化能力。

This repository hosts DualityVidQA, the large-scale paired video–QA dataset introduced in Taming Hallucinations: Boosting MLLMs Video Understanding via Counterfactual Video Generation. Taming Hallucinations introduces DualityForge, a controllable diffusion-based framework that turns real videos into counterfactual ones, automatically generating paired (real / counterfactual) videos together with their question–answer data for contrastive training. Built on top of DualityVidQA and the proposed DNA-Train SFT–RL regime with ℓ1-normalized advantages, our approach reduces hallucinations in multimodal LLMs by 24% and shows strong generalization across benchmarks.
提供机构:
GD-ML
搜集汇总
数据集介绍
GD-ML/Taming-Hallucinations 数据集图片
构建方式
该数据集基于DualityForge可控扩散框架构建,该框架能够将真实视频转化为反事实视频,并自动生成配对的真实与反事实视频及其对应的问答数据。通过将真实视频作为输入,利用扩散模型对视频内容进行可控篡改,生成与原始视频语义相悖但视觉连贯的反事实版本,从而构建出大规模、高质量的配对视频问答数据集DualityVidQA。这种自动化的数据生成流程不仅摆脱了昂贵的人工标注,还确保了数据多样性与可控性,为对比学习提供了坚实的训练基础。
使用方法
使用者可从HuggingFace仓库下载包含视频文件的ZIP压缩包(part_001至part_008),解压后即可获得所有真实与反事实视频。配套的标注文件分布于三个子目录:sft/目录下的JSON文件用于监督微调阶段,RL/目录中的JSONL文件用于强化学习训练,benchmark/目录下的CSV文件提供标准化评估集。用户可通过huggingface_hub库的snapshot_download函数一键下载整个数据集,并依据具体任务需求灵活加载对应标注文件,以支持多模态大模型的训练、微调与评估。
背景与挑战
背景概述
在视频理解领域,多模态大语言模型(MLLMs)虽取得了显著进展,却普遍面临生成内容与视频事实不符的幻觉问题。为此,来自阿里巴巴、清华大学等机构的研究人员于2025年提出了Taming-Hallucinations数据集及其配套方法。该数据集名为DualityVidQA,由黄哲、文浩等研究者创建,核心贡献在于通过可控扩散框架DualityForge将真实视频转化为反事实视频,自动生成成对的视频与问答数据,用于对比学习训练。该工作被CVPR 2026 Findings接收,其提出的DNA-Train训练策略结合L1归一化优势,将MLLMs的幻觉率降低了24%,在视频问答和视频文本生成任务中展现出卓越泛化能力,对缓解视频理解中的幻觉问题具有重要推动作用。
当前挑战
Taming-Hallucinations数据集及其方法旨在应对多模态大语言模型在视频理解中面临的严峻幻觉挑战,即模型可能输出与视频实际内容不符的描述或答案,这一问题严重制约了模型在医疗影像分析、自动驾驶等高风险场景中的可靠应用。构建过程中,团队面临两大挑战:其一,如何在不依赖人工标注的前提下,高效生成大量真实与反事实视频对及对应问答数据,为此他们设计了DualityForge框架,利用扩散模型实现可控反事实生成;其二,如何设计有效的训练策略以同时利用对比数据和强化学习信号,最终提出了DNA-Train方法,结合监督微调与带L1正则化优势的强化学习,显著抑制了幻觉现象。
常用场景
经典使用场景
在视频理解与多模态大模型的研究浪潮中,模型对视频内容的忠实感知与推理能力始终是核心挑战。DualityVidQA数据集以其独特的反事实视频-问答对结构,成为训练与评估多模态大模型视频理解能力的经典基准。该数据集通过对比真实视频与反事实视频的问答任务,使模型能在差异化的视觉输入中学习本质特征,从而提升对视频语义的精准把握。研究者通常利用该数据集进行监督微调与强化学习两阶段训练,结合其提供的结构化指令数据,构建能有效抵抗幻觉的视频理解系统。
解决学术问题
多模态大模型在视频理解任务中频繁出现幻觉现象,即模型生成与视频内容矛盾或不存在的描述,这一直是制约其实际应用的学术瓶颈。DualityVidQA通过引入大规模配对视频与反事实视频问答数据,开辟了对比学习与反事实推理的联合研究路径。其配套的DNA-Train训练范式,结合SFT与RL的双重优化机制与ℓ1归一化优势函数,将模型幻觉率降低24%,从根本上缓解了视频多模态模型对内容虚构的顽疾。该工作为视频语言模型的可信度提升提供了可复现的范式和客观评价标准,推动了多模态推理向更稳健的方向演进。
实际应用
在实际部署中,该数据集的价值体现在需要高可靠性视频理解的关键场景。例如在自动驾驶领域,车辆需准确辨识道路视频中的异常事件并排除错误干扰;在智能安防监控中,系统必须区分真实行为与可能的对抗性扰动;在视频内容审核与辅助医疗影像分析等敏感应用中,任何幻觉输出都可能造成严重后果。凭借其反事实视频对的优势,基于DualityVidQA训练的模型能在复杂动态环境中维持更高的语义忠实度,减少因视觉歧义引发的误判,为工业级视频内容理解系统的鲁棒性提升提供了切实可行的数据基础。
数据集最近研究
最新研究方向
当前,多模态大语言模型在视频理解中普遍面临幻觉问题,即模型生成与视频内容不符的描述或回答。Taming-Hallucinations数据集及DualityVidQA基准的提出,为这一难题提供了突破性解决方案。其核心创新在于利用可控扩散框架DualityForge,自动生成真实与反事实配对视频及问答数据,并设计了DNA-Train联合强化学习策略,通过ℓ1归一化优势函数进行对比训练。这一方法将视频多模态大模型的幻觉率降低了24%,在多个基准上展现出优异的泛化能力,为构建更可靠、更真实的视频理解系统开辟了新路径,推动了多模态模型在安全与可信度方向的前沿探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

