
stefanocarrera/autophagycode_D_he_train-mercury_Qwen3-4B_strategy_trust_t1.25_g8_run0
收藏数据链接:
官方服务:
资源简介:
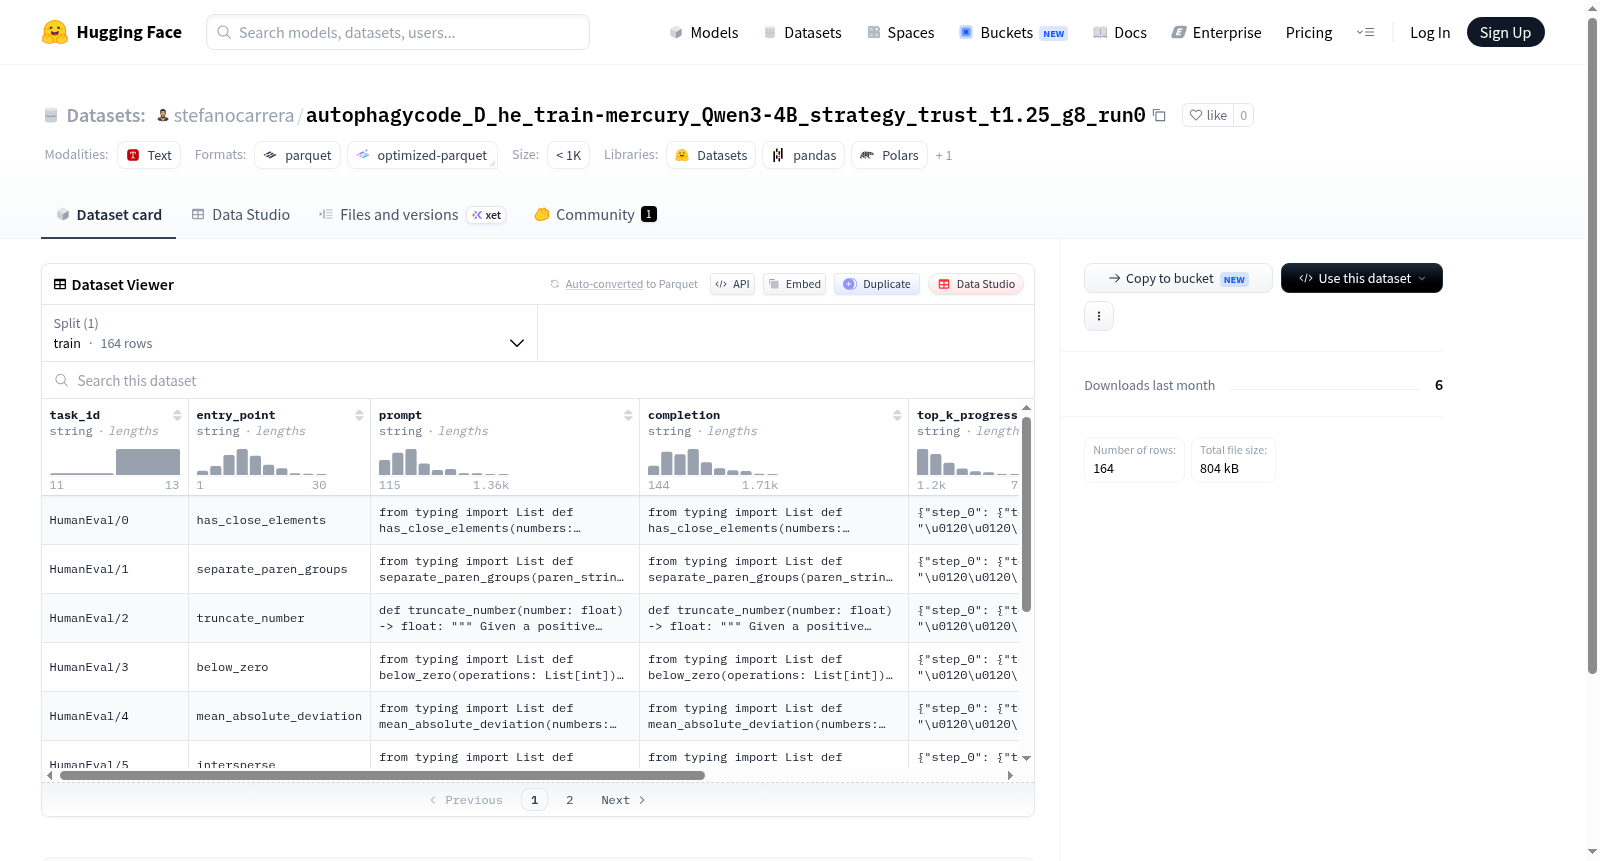
该数据集包含164个训练示例,用于代码生成或任务完成相关任务。每个示例包含以下特征字段:task_id(任务标识符)、entry_point(入口点)、prompt(提示文本)、completion(完成文本)、top_k_progression(top-k进度信息)和test(测试信息)。数据集结构侧重于支持基于提示的生成模型训练或评估,可能涉及编程任务或自动化测试场景。
This dataset contains 164 training examples for code generation or task completion tasks. Each example includes the following feature fields: task_id (task identifier), entry_point (entry point), prompt (prompt text), completion (completion text), top_k_progression (top-k progression information), and test (test information). The dataset structure is designed to support prompt-based generation model training or evaluation, potentially involving programming tasks or automated testing scenarios.
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集源自对Qwen3-4B模型在自噬相关编码任务上的生成结果进行精选与重构。采用'信任'策略(trust strategy),设置温度参数T=1.25,并利用8个生成通道(generation run 0)进行多路采样,最终汇总得到164个高质量训练样本。每个样本包含任务标识、入口函数、提示词、代码补全、top-k演化轨迹及测试用例,形成完整的代码生成与验证闭环。数据以Parquet格式存储,总规模约2.9MB,专为微调与评估代码补全模型而设计。
特点
数据集的核心特点在于其结构化与层次化设计。每个样本不仅记录了模型生成的最终代码补全(completion),还保留了top-k逐步推演的过程(top_k_progression),便于研究者分析模型推理路径与质量变化。任务入口点(entry_point)与测试用例(test)的并存,使得数据集可直接用于执行正确性验证。此外,164个样本虽数量有限,但来源经过温度与策略的精细调控,确保了样本覆盖的多样性与可靠性。
使用方法
该数据集可通过HuggingFace Datasets库直接加载,指定配置名为'default',并读取'train'分片中的数据。典型使用场景包括:基于prompt完成代码补全任务的模型微调,或利用completion与test字段进行生成质量的自动化评估。研究者亦可借助top_k_progression字段,分析模型在多次迭代中的推理稳定性与改进趋势。建议在评估时使用原始测试用例进行执行级验证,而非仅依赖文本相似度指标。
背景与挑战
背景概述
该数据集由自主代码(autophagycode)团队创建,围绕Qwen3-4B模型在特定策略(trust策略,温度系数1.25,生成轮次8)下生成的内容构建,其核心研究问题聚焦于探索代码生成任务中模型输出的一致性、可靠性以及内部知识表征的演变。数据集包含164个训练样本,每个样本涵盖了从任务描述、入口函数到逐步推理完成代码的完整流程,尤其引入了top_k_progression字段以追踪模型生成过程中的知识递进模式。作为针对大语言模型代码生成能力评估与机制分析的重要资源,该数据集为理解模型在结构化编程任务中的决策逻辑和潜在偏差提供了微观视角,对提升代码智能体的鲁棒性和可解释性具有推动作用。
当前挑战
所解决的领域问题主要在于代码生成任务中模型输出存在的不确定性与可靠性缺失,即模型可能生成语法正确但逻辑错误或与预期行为不符的代码,这限制了代码智能体在关键系统中的部署。构建过程中面临的挑战包括:大规模代码生成数据的精准标注极为困难,需要领域专家逐行验证逻辑正确性;top_k_progression字段的构建需记录模型在多次采样中的概率路径变化,计算开销高昂且易受随机性干扰;样本量仅164例,如何在有限数据下有效捕捉模型的隐蔽失误模式并避免过拟合,成为评估流程设计的核心难题。
常用场景
经典使用场景
在代码智能与程序合成领域,该数据集被广泛用于训练和评估大语言模型在代码生成任务中的表现。其核心设计围绕任务驱动型编程场景展开,每条样本包含任务描述、函数入口点、上下文提示以及对应的完善代码补全,特别适合于探究模型在给定部分代码逻辑后,如何基于提示进行后续代码段生成的能力。研究者通常将其作为微调基础模型的训练集,用于提升模型在代码补全与结构化编程任务上的准确性和鲁棒性。
实际应用
在实际应用中,该数据集可助力自动化代码补全工具与智能编程助手的开发,尤其是在集成开发环境(IDE)中,模型可基于开发者输入的片段和注释,自动生成符合预期的函数实现或测试代码。此外,在在线编程教育平台中,该数据集能够支持智能辅导系统,根据学生提交的代码片段实时生成下一阶段的补全提示,从而辅助教学和代码纠错,提升编程学习效率。
衍生相关工作
该数据集衍生了多项关于代码生成与模型校准策略的经典研究工作。例如,研究者基于其训练样本探索了‘策略信任’机制在代码补全中的迁移学习效果,以及如何通过温度采样(如t=1.25)和组内评分策略(如top-k渐进选择)优化生成质量。此外,数据集中‘task_id’与‘entry_point’的结构化标注方式,启发了构建多任务代码理解基准的工作,推动了跨领域代码生成模型的泛化能力评估研究。
以上内容由遇见数据集搜集并总结生成


