vocal-bursts-clean
收藏资源简介:
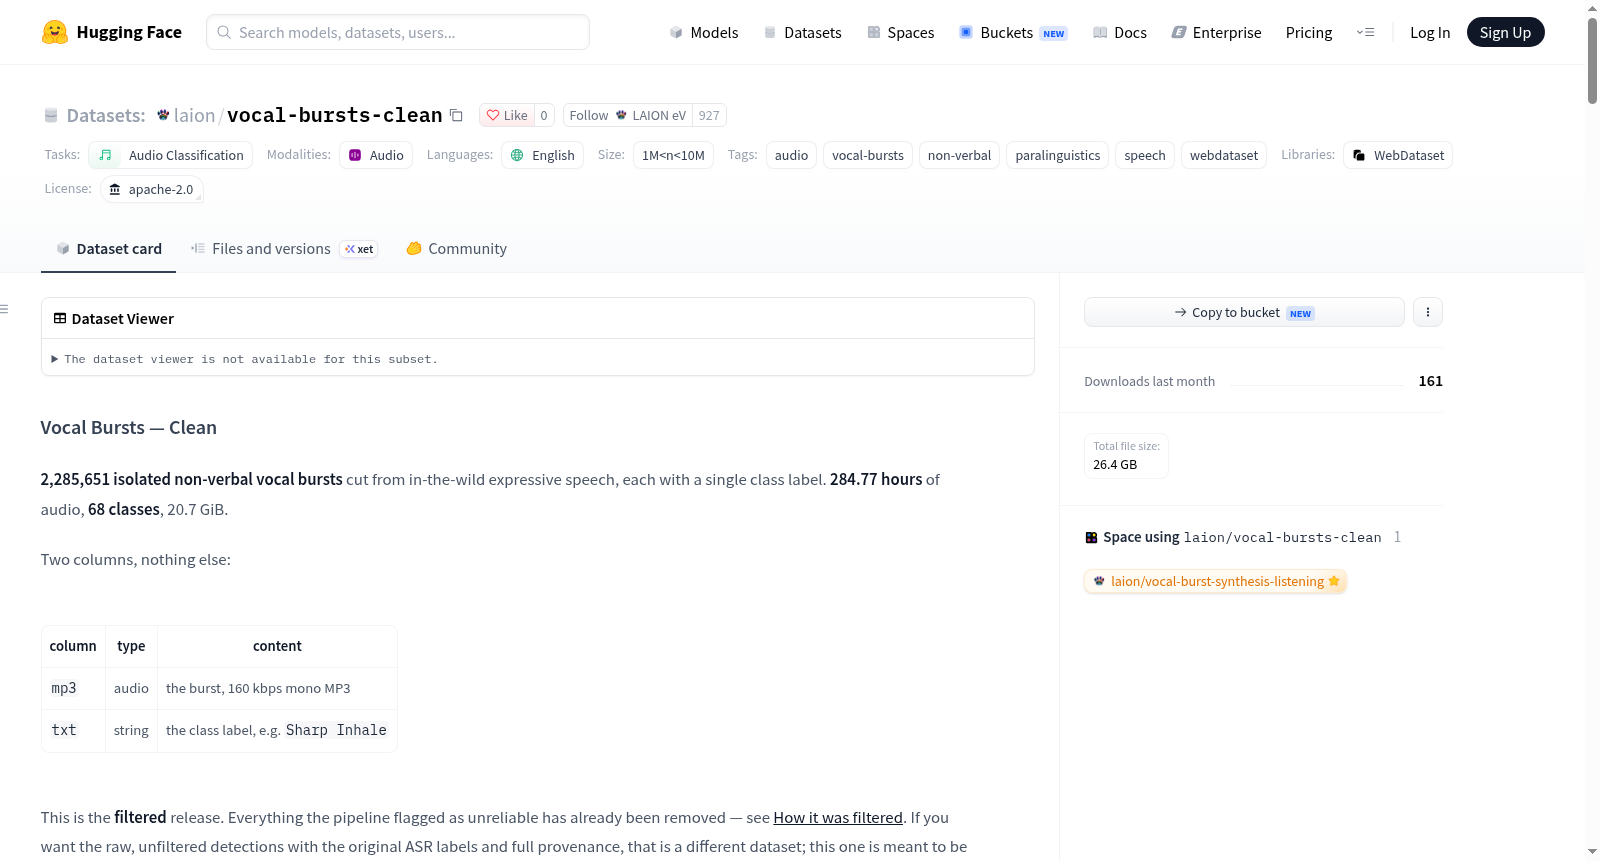
Vocal Bursts (Clean) 是一个大规模非语言声音爆发数据集,包含 2,285,651 个从自然表现性语音中裁剪出的孤立非语言爆发片段,总时长 284.77 小时,覆盖 68 个类别,数据大小约 20.7 GiB。每个样本包含一段 MP3 音频(160 kbps,单声道)和一个文本标签。该数据集是经过严格过滤的版本,剔除了分类器判定为“无爆发”的片段(50.41%)以及短于 250 毫秒的片段(7.36%),从原始 5,412,262 个检测中保留 42.23%。标签来自基于 VoiceCLAP 编码器和 MLP 分类器的 top-1 预测,而非人工标注。数据集按类别呈现长尾分布,前 5 个类别(如“Wistful Sigh”“Sharp Inhale”等)占总样本的 73.03%,仅有 27 个类别样本数超过 1000。已知限制包括:标签存在噪声(尤其是细粒度类别),建议聚合到粗粒度族级别;存在近重复类别名(如 Hiccup/Hiccups);未提供验证集划分,需基于样本键前缀分割以避免泄漏;领域为英语表现性语音,不直接迁移到对话或朗读语音。数据集以 WebDataset 格式存储,共 126 个分片,每个分片约 20,000 个样本。适用于音频分类、副语言研究等任务。
Vocal Bursts (Clean) is a large-scale dataset of non-verbal vocal bursts, containing 2,285,651 isolated non-verbal burst clips cropped from natural expressive speech, with a total duration of 284.77 hours, covering 68 categories, and a data size of approximately 20.7 GiB. Each sample consists of an MP3 audio file (160 kbps, mono) and a text label. This dataset is a strictly filtered version, removing clips classified as no burst by the classifier (50.41%) and clips shorter than 250 milliseconds (7.36%), retaining 42.23% of the original 5,412,262 detections. Labels are derived from top-1 predictions based on a VoiceCLAP encoder and MLP classifier, rather than human annotation. The dataset exhibits a long-tail distribution across categories, with the top 5 categories (e.g., Wistful Sigh, Sharp Inhale) accounting for 73.03% of total samples, and only 27 categories having more than 1,000 samples. Known limitations include: label noise (especially for fine-grained categories), suggesting aggregation to coarse-grained family levels; near-duplicate category names (e.g., Hiccup/Hiccups); no validation set split provided, requiring splitting based on sample key prefixes to avoid leakage; the domain is English expressive speech, not directly transferable to conversational or read speech. The dataset is stored in WebDataset format, with 126 shards, each containing approximately 20,000 samples. It is suitable for tasks such as audio classification and paralinguistic research.
Vocal Bursts (Clean) 数据集详情
基本信息
- 数据集名称:Vocal Bursts (Clean)
- 许可证:Apache-2.0
- 任务类型:音频分类(audio-classification)
- 语言:英语
- 数据集规模:1M~10M 样本
- 标签格式:WebDataset
数据集内容
该数据集包含 2,285,651 个独立的非言语声音爆发片段(non-verbal vocal bursts),源自自然表达性语音,每个片段带有一个类别标签。数据集特性如下:
| 属性 | 数值 |
|---|---|
| 总时长 | 284.77 小时 |
| 类别数 | 68 类 |
| 平均时长 | 448 毫秒 |
| 最短时长 | 250 毫秒(构造上保证) |
| 音频格式 | MP3,160 kbps,单声道 |
| 数据大小 | 20.7 GiB |
| 分片数 | 126 个分片(每片约 20,000 个样本) |
数据列结构
数据仅包含两列:
| 列名 | 类型 | 内容 |
|---|---|---|
mp3 |
音频 | 声音爆发片段,160 kbps 单声道 MP3 |
txt |
字符串 | 类别标签,如 Sharp Inhale |
构建流程
- 检测:使用 CrisperWhisper v2.0 转录表达性语音,并标记非言语事件(如
[UH]、[laughter]等),提供时间戳 - 切割:在标称边界 ±150 ms 范围内搜索窗口,将切割点放置在局部短时 RMS 最小值处(20 ms 窗口,5 ms 步进),编码为 160 kbps 单声道 MP3
- 分类:使用
laion/vocalburst-classifier-single模型标记每个片段,该模型基于冻结的laion/voiceclap-commercial编码器(768 维)+ 3×1024 MLP,覆盖 83 个类别,取 Top-1 softmax - 过滤:见下文说明
注意:txt 中的标签是分类器的 Top-1 预测结果,不是 原始 ASR 标记,也 不是 人工标注。
过滤过程
从 5,412,262 个检测结果 出发:
| 步骤 | 丢弃数量 | 保留数量 |
|---|---|---|
| 输入 | — | 5,412,262 |
| 分类器判定"无声音爆发" | 2,728,125 (50.41%) | 2,684,137 |
| 短于 250 ms | 398,486 (7.36%) | 2,285,651 |
| 最终保留 | 2,285,651 (42.23%) |
过滤原因说明
- 无声音爆发过滤:ASR 模型标记的言语不流畅不等于存在可分类的声音爆发。超过半数的 CrisperWhisper 检测结果实际不含可分类的声音爆发(如低于底噪的呼吸声、爆破音、麦克风碰撞声或纯静音)
- 分类体系修补:原始分类器训练时有 3 个
hand_and_body_sounds家族类别(Hand Scratching Head、Hand Slaps、Slap Face)在生产环境中误报率过高,已被重新标记为No burst并排除出本数据集 - 250 ms 时长下限:低于约四分之一秒的片段,编码器可用信息太少,Top-1 标签接近随机猜测
类别分布
- 数据集呈现极端长尾分布
- 前 5 个类别占所有样本的 73.03%
- 仅有 27/68 个类别拥有 ≥1,000 个样本
- 最常见的类别包括:
Wistful Sigh(21.07%)Sharp Inhale(19.74%)Nervous Gulp(16.06%)Affirmative Grunt(8.16%)Relief Sigh(8.00%)
- 最稀有的类别(如
Growl、Pleasure Moan等)仅有 1 个样本,不适合单独用于训练
已知局限性
- 标签为模型预测而非真实标注:在留出干净单片段测试上,分类器宏平均 mAP 为 0.68(细粒度)/ 0.87(粗粒度家族级别),Top-1 精确率为 60%。家族内的细粒度标签应视为有噪声,按家族级别分组是更安全的目标
- 存在近重复类别名:如
Hiccup/Hiccups、Gulps/Swallows、Clicks Tongue/Tongue Click、Kissing Sounds/Kissing Noises、Cough/Coughing,未做合并处理 - 未提供留出数据集划分:来自同一父片段的片段共享键前缀,随机划分会导致跨划分的声学泄漏,应基于键前缀进行划分
- 领域限制:数据来自表达性、表演风格的语音,以英语为主,类别先验可能不适用于会话或朗读语音
- 系统性偏差:源检测由 ASR 模型产生,ASR 未内联标记的事件会系统性欠代表
相关资源
- 分类器:laion/vocalburst-classifier-single
- 音频编码器:laion/voiceclap-commercial
- 类别分类体系:LAION-AI/voice-taxonomies
引用
bibtex @misc{laion_vocal_bursts_clean, title = {Vocal Bursts (Clean): 2,285,651 labelled non-verbal vocal bursts}, author = {LAION}, year = {2026}, url = {https://huggingface.co/datasets/laion/vocal-bursts-clean} }