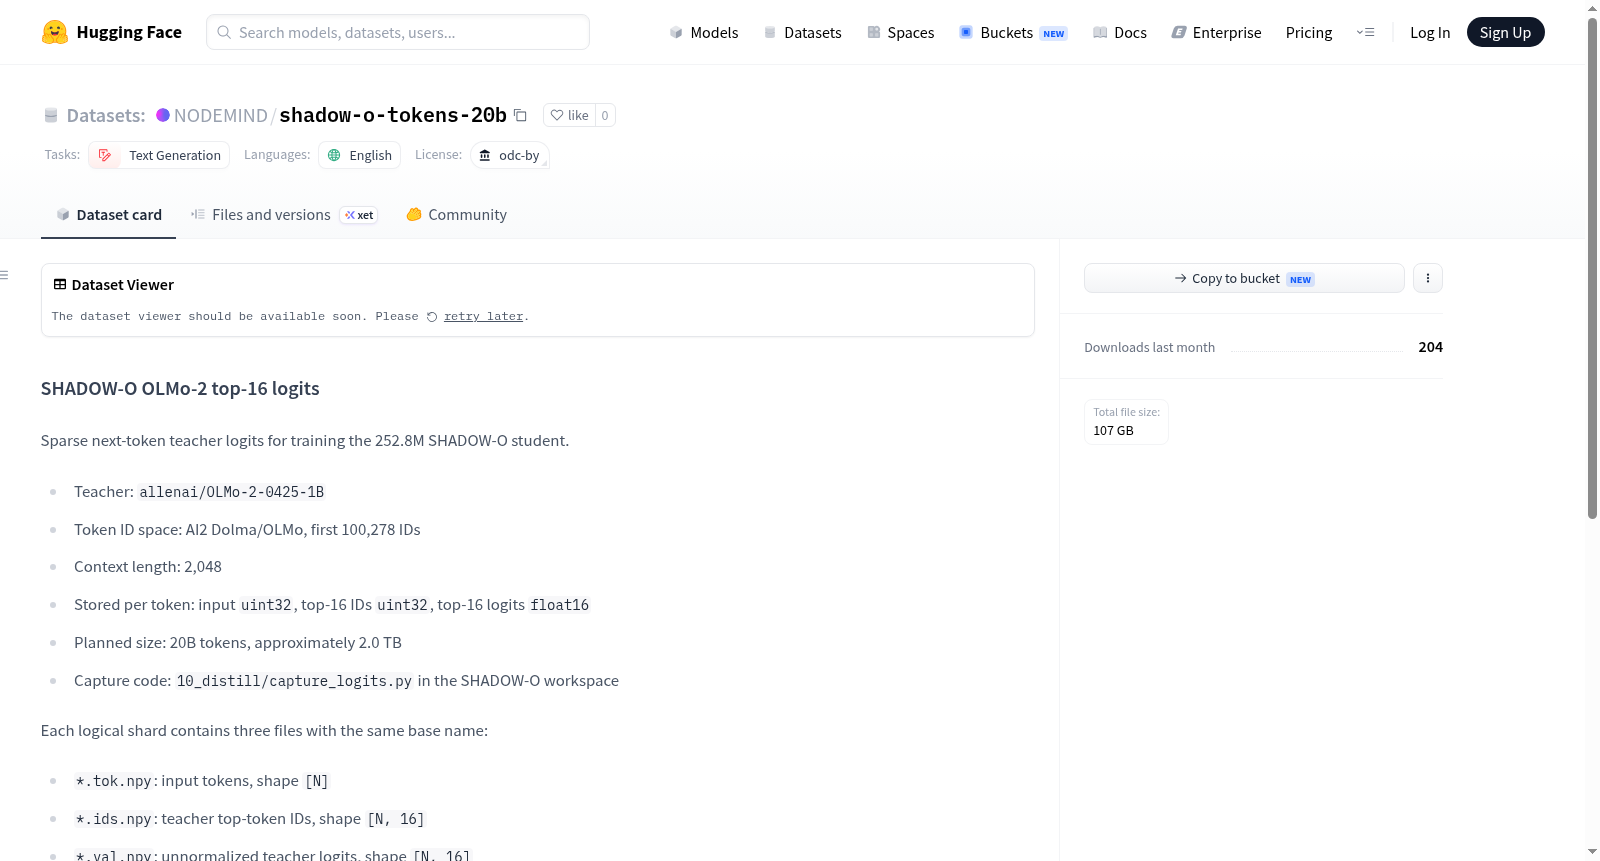
shadow-o-tokens-20b
收藏资源简介:
SHADOW-O OLMo-2 Top-16 Logits (20B) 是一个用于知识蒸馏训练的大型稀疏下一词元教师logits数据集,专门设计用于训练参数量为252.8M的SHADOW-O学生模型。技术规格方面:教师模型采用allenai/OLMo-2-0425-1B;词表ID空间基于AI2 Dolma/OLMo的前100,278个ID;上下文长度为2,048个词元;存储格式为每个词元保存输入token(uint32)、前16个预测token的ID(uint32)以及对应的未归一化logits值(float16)。数据集计划规模为200亿词元,约2.0TB存储空间,按逻辑分片组织,每个分片包含三个同名文件:*.tok.npy(输入词元,形状[N])、*.ids.npy(教师预测top-16 token ID,形状[N, 16])和*.val.npy(教师未归一化logits,形状[N, 16])。数据混合计划包含四个组成部分:基础数据(6.4B词元,教育导向的网络爬取数据、维基百科和Stack-Edu)、密度数据(4.55B词元,数学、代码和阅读理解)、推理数据(4.55B词元,数学、代码、合成QA和元推理)以及退火数据(4.5B词元,推理轨迹、FLAN/Tülu监督微调数据和可验证问题)。底层词元流来源于AI2的公开OLMo/Dolma数据分布,保留了相应的源许可证和归属要求。捕获过程具有可恢复性,仅在所有数组写入并上传后才提交源分片。学生模型在捕获的前16个词元集合上对教师和学生分布进行重归一化处理。
SHADOW-O OLMo-2 Top-16 Logits (20B) is a large-scale sparse next-token teacher logits dataset for knowledge distillation training, specifically designed for training the SHADOW-O student model with 252.8M parameters. Technical specifications include: teacher model using allenai/OLMo-2-0425-1B; vocabulary ID space based on the first 100,278 IDs from AI2 Dolma/OLMo; context length of 2,048 tokens; storage format saving per token the input token (uint32), top-16 predicted token IDs (uint32), and corresponding unnormalized logits values (float16). The dataset is planned to scale to 20 billion tokens, approximately 2.0TB in storage, organized into logical shards, each containing three files with the same name: *.tok.npy (input tokens, shape [N]), *.ids.npy (teacher-predicted top-16 token IDs, shape [N, 16]) and *.val.npy (teacher unnormalized logits, shape [N, 16]). The data mixture plan consists of four components: base data (6.4B tokens, education-oriented web crawl data, Wikipedia, and Stack-Edu), density data (4.55B tokens, math, code, and reading comprehension), reasoning data (4.55B tokens, math, code, synthetic QA, and meta-reasoning), and annealing data (4.5B tokens, reasoning traces, FLAN/Tülu supervised fine-tuning data, and verifiable questions). The underlying token stream originates from AI2s public OLMo/Dolma data distribution, retaining corresponding source licenses and attribution requirements. The capture process is recoverable, with source shards committed only after all arrays are written and uploaded. The student model renormalizes teacher and student distributions over the captured set of top-16 tokens.
SHADOW-O OLMo-2 Top-16 Logits (20B) 数据集概述
数据集名称:SHADOW-O OLMo-2 top-16 logits(20B tokens)
许可证:ODC-BY(Open Data Commons Attribution License)
任务类别:文本生成
语言:英语
数据集用途
该数据集用于训练252.8M参数的SHADOW-O学生模型,提供稀疏的下一词元教师logits。教师模型为 allenai/OLMo-2-0425-1B(1B参数)。
技术细节
- 词元ID空间:AI2 Dolma/OLMo 词表,前100,278个ID。
- 上下文长度:2,048个词元。
- 存储格式:每个词元存储以下内容:
- 输入词元(
uint32) - 前16个ID(
uint32) - 前16个logits(
float16)
- 输入词元(
- 预计规模:20B tokens,约2.0 TB。
- 捕获代码:
10_distill/capture_logits.py(位于SHADOW-O工作空间)。
数据分片逻辑:每个分片包含三个同名的文件:
*.tok.npy:输入词元,形状[N]*.ids.npy:教师前16个词元ID,形状[N, 16]*.val.npy:未归一化的教师logits,形状[N, 16]
捕获过程可中断恢复,仅在所有数组写入并上传完成后提交分片。学生模型在捕获的前16个集合上对教师分布和学生分布进行重新归一化。
数据混合计划(20B tokens)
- Foundation(64亿tokens):教育导向的网络爬虫数据、维基百科、Stack-Edu
- Density(45.5亿tokens):数学、代码、阅读理解
- Reasoning(45.5亿tokens):数学、代码、合成问答、元推理
- Anneal(45亿tokens):推理轨迹、FLAN/Tülu SFT、可验证问题
底层词元流来自AI2公开的OLMo/Dolma数据分布,并保留其适用的源许可证和署名要求。