
D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_4arg_0__v1
收藏数据链接:
官方服务:
资源简介:
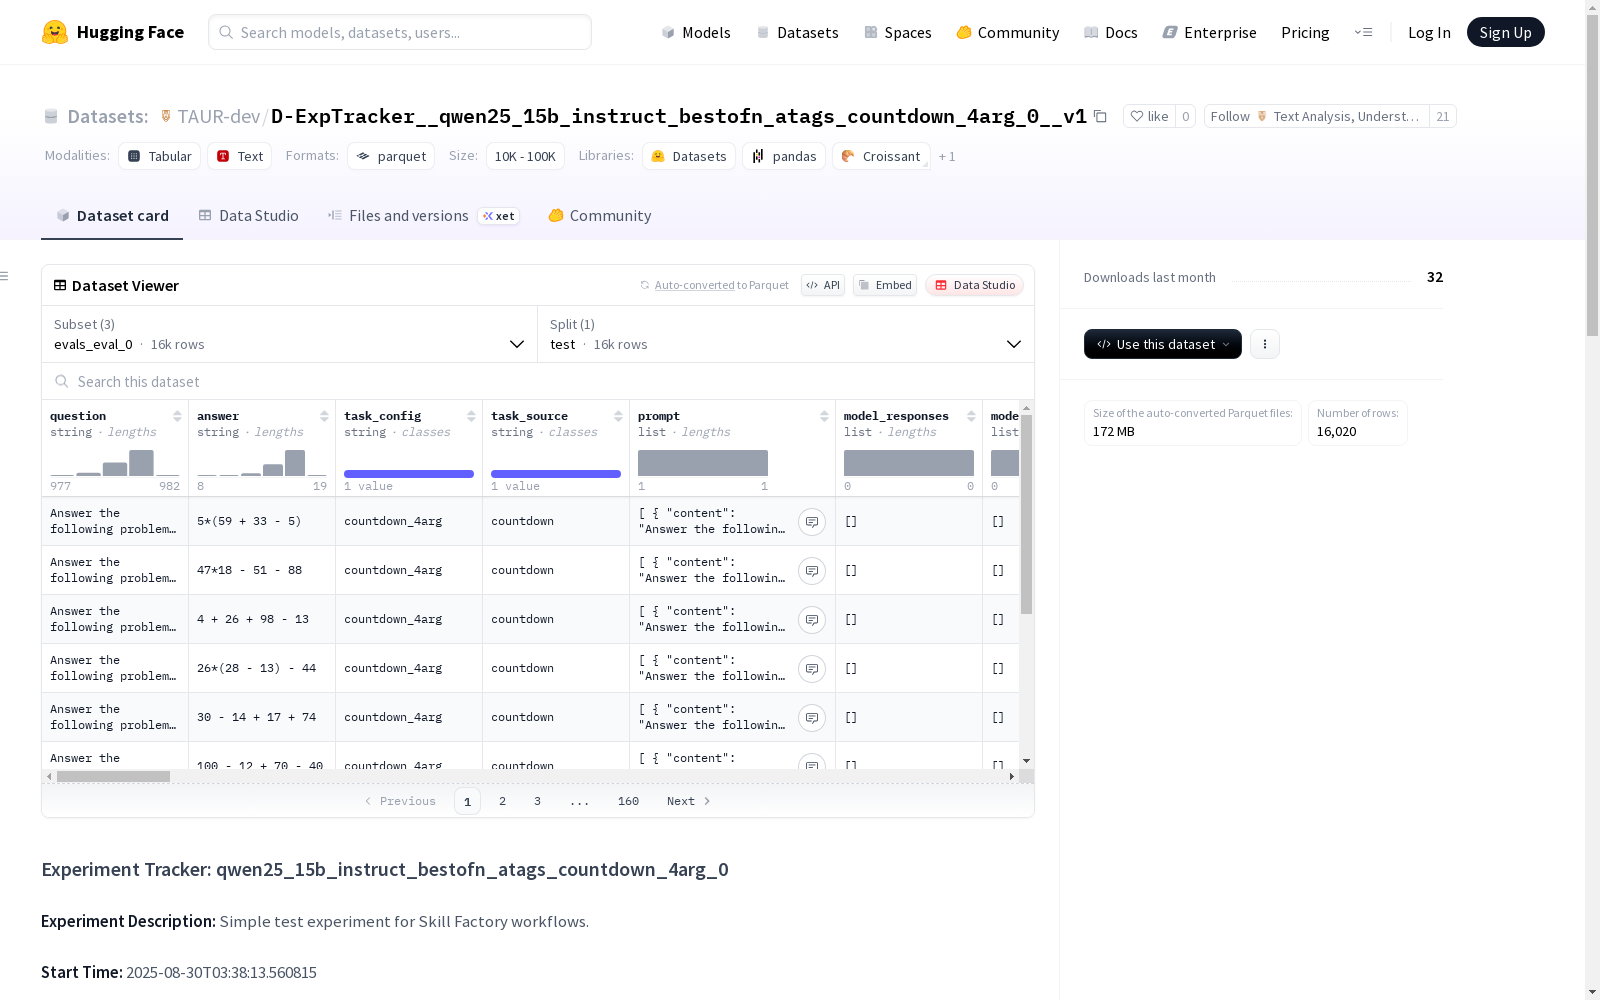
这是一个用于Skill Factory工作流的测试实验数据集,包含了问题、答案、任务配置等信息。数据集分为三个配置:evals_eval_0、logs__evaluation_eval_0和metadata,每个配置都有不同的特性和用途。此外,数据集还提供了测试集、训练集和元数据等信息。
创建时间:
2025-08-30
原始信息汇总
数据集概述
基本信息
- 数据集名称: D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_4arg_0__v1
- 实验描述: Simple test experiment for Skill Factory workflows
- 开始时间: 2025-08-30T03:38:13.560815
- 总阶段数: 1
数据集配置
evals_eval_0 配置
- 数据分割: test
- 样本数量: 16,000
- 数据大小: 448,364,612 字节
- 下载大小: 140,802,521 字节
特征结构
- question: 字符串类型
- answer: 字符串类型
- task_config: 字符串类型
- task_source: 字符串类型
- prompt: 列表结构,包含content和role字段
- model_responses: 序列类型
- model_responses__eval_is_correct: 序列类型
- all_other_columns: 字符串类型
- original_split: 字符串类型
- metadata: 字符串类型
- model_responses__best_of_n_atags: 字符串序列
- model_responses__best_of_n_atags__finish_reason_length_flags: 布尔序列
- model_responses__best_of_n_atags__length_partial_responses: 字符串序列
- prompt__best_of_n_atags__metadata: 结构化数据,包含API URL、后端、聊天模板应用状态、生成参数、模型名称等信息
- model_responses__best_of_n_atags__metadata: 结构化数据,包含后端、模型名称、响应数量
- model_responses__best_of_n_atags__eval_is_correct: 布尔序列
- model_responses__best_of_n_atags__eval_extracted_answers: 字符串序列
- model_responses__best_of_n_atags__eval_extraction_metadata: 列表结构,包含提取类型、非重叠跨度、原始跨度等信息
- model_responses__best_of_n_atags__eval_evaluation_metadata: 列表结构,包含答案块、错误、评估方法、提取结果、最终答案、正确性、原因等信息
- model_responses__best_of_n_atags__internal_answers__eval_is_correct: 布尔序列的序列
- model_responses__best_of_n_atags__internal_answers__eval_extracted_answers: 字符串序列的序列
- model_responses__best_of_n_atags__internal_answers__eval_extraction_metadata: 列表的列表,包含置信度、提取类型、原始跨度、使用模式、位置、跨度结束、跨度开始、跨度文本等信息
- model_responses__best_of_n_atags__internal_answers__eval_evaluation_metadata: 列表的列表,包含答案块、错误、最终答案、正确性等信息
- model_responses__best_of_n_atags__metrics: 结构化指标数据,包含翻转次数、总翻转数、正确数量、通过率、正确百分比、技能计数、总响应数等
- eval_date: 字符串类型
- split: 字符串类型
- revision_name: 字符串类型
- model_path: 字符串类型
- checkpoint_step: 整型
- stage_name: 字符串类型
- stage_number: 整型
- timestamp: 字符串类型
- eval_repo_id: 字符串类型
logs__evaluation_eval_0 配置
- 数据分割: train
- 样本数量: 2
- 数据大小: 477,825,860 字节
- 下载大小: 31,587,585 字节
特征结构
- timestamp: 字符串类型
- end_timestamp: 字符串类型
- stage_name: 字符串类型
- stage_number: 整型
- level: 字符串类型
- message: 字符串类型
- stdout_content: 字符串类型
- stderr_content: 字符串类型
- experiment_name: 字符串类型
- elapsed_time_seconds: 浮点型
- stage_complete: 布尔型
metadata 配置
- 数据分割: train
- 样本数量: 18
- 数据大小: 27,999 字节
- 下载大小: 9,233 字节
特征结构
- experiment_name: 字符串类型
- start_time: 字符串类型
- description: 字符串类型
- base_org: 字符串类型
- stage_number: 字符串类型
- stage_type: 字符串类型
- status: 字符串类型
数据加载方式
可通过以下代码加载数据集: python from datasets import load_dataset
加载实验元数据
metadata = load_dataset(TAUR-dev/D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_4arg_0__v1, experiment_metadata)
搜集汇总
数据集介绍
构建方式
在人工智能模型评估领域,D-ExpTracker数据集通过结构化实验追踪框架构建,采用多配置体系记录模型响应与评估数据。该数据集基于Qwen2.5-15B-Instruct模型在Best-of-N采样策略下的性能测试,通过标准化数据采集流程捕获16000个测试样本,每个样本包含问题、答案、任务配置及模型生成的多维度响应数据。构建过程采用分阶段实验设计,确保数据采集与模型训练阶段的完整对应,并通过即时上传机制保障数据溯源的有效性。
特点
该数据集最显著的特征在于其深度注释的评估体系,不仅包含基础的问题-答案对,更具备模型响应序列、正确性标注、答案提取元数据等多层结构化信息。特征工程方面,数据集提供了生成参数配置、内部答案评估、技能计数统计等高级指标,支持对模型推理过程的细粒度分析。其特有的实验追踪架构将评估数据与实验日志、超参数配置、元数据信息形成有机整体,为研究社区提供兼具广度与深度的模型性能分析基准。
使用方法
研究人员可通过HuggingFace数据集库加载特定配置进行深入分析,例如使用load_dataset函数调用'eval_eval_0'配置获取核心评估数据,或访问'experiment_metadata'配置获取实验时间线信息。数据集支持分模块加载机制,允许用户单独提取训练数据、超参数配置、阶段日志或带注释的评估结果。典型应用场景包括模型采样策略比较、答案提取算法验证、多阶段训练效果分析等,所有数据均遵循标准化格式确保跨实验的可比性。
背景与挑战
背景概述
在人工智能研究领域,实验追踪数据集作为机器学习工作流管理的重要组成部分,由TAUR-dev团队于2025年创建。该数据集专注于记录Qwen-25B指令微调模型在Best-of-N采样策略下的多轮对话评估过程,通过结构化存储实验配置、模型响应及评估元数据,为大规模语言模型的迭代优化提供全链路可追溯性支持。其创新性体现在将实验管理、模型评估与技能工厂工作流深度融合,推动了可复现人工智能研究范式的演进。
当前挑战
该数据集致力于解决大规模语言模型在复杂推理任务中的稳定性评估挑战,特别是Best-of-N采样策略下模型响应一致性与准确性的量化难题。构建过程中面临多维度挑战:需设计精细的响应评估框架以处理非结构化文本提取,建立跨阶段实验数据的统一表征规范,并确保海量评估结果与元数据间的时空一致性。同时,需要平衡评估粒度与存储效率,实现从原始响应到量化指标的全自动流水线处理。
常用场景
经典使用场景
在大型语言模型评估领域,该数据集通过系统记录模型在复杂推理任务中的多轮响应表现,为研究者提供标准化评估框架。数据集详细捕捉了模型在最佳N采样策略下的生成轨迹,包括响应内容、评估标记和元数据信息,使得研究人员能够深入分析模型在不同参数配置下的行为模式。
解决学术问题
该数据集有效解决了大语言模型评估中缺乏标准化基准的问题,通过结构化记录模型响应与评估结果,为量化模型推理能力提供数据支撑。其精细的标注体系使得研究者能够系统分析模型错误模式,推动模型优化方向的确定,对提升语言模型的可靠性和可解释性具有重要学术价值。
衍生相关工作
基于该数据集的实验框架,衍生出多项关于模型采样策略优化的研究,特别是在最佳N采样与投票机制结合方面取得显著进展。这些工作深入探索了模型自我修正能力的提升路径,为后续构建更强大的推理模型奠定理论基础,推动了大语言模型评估方法学的创新发展。
以上内容由遇见数据集搜集并总结生成


